
side7
收藏官方服务:
资源简介:
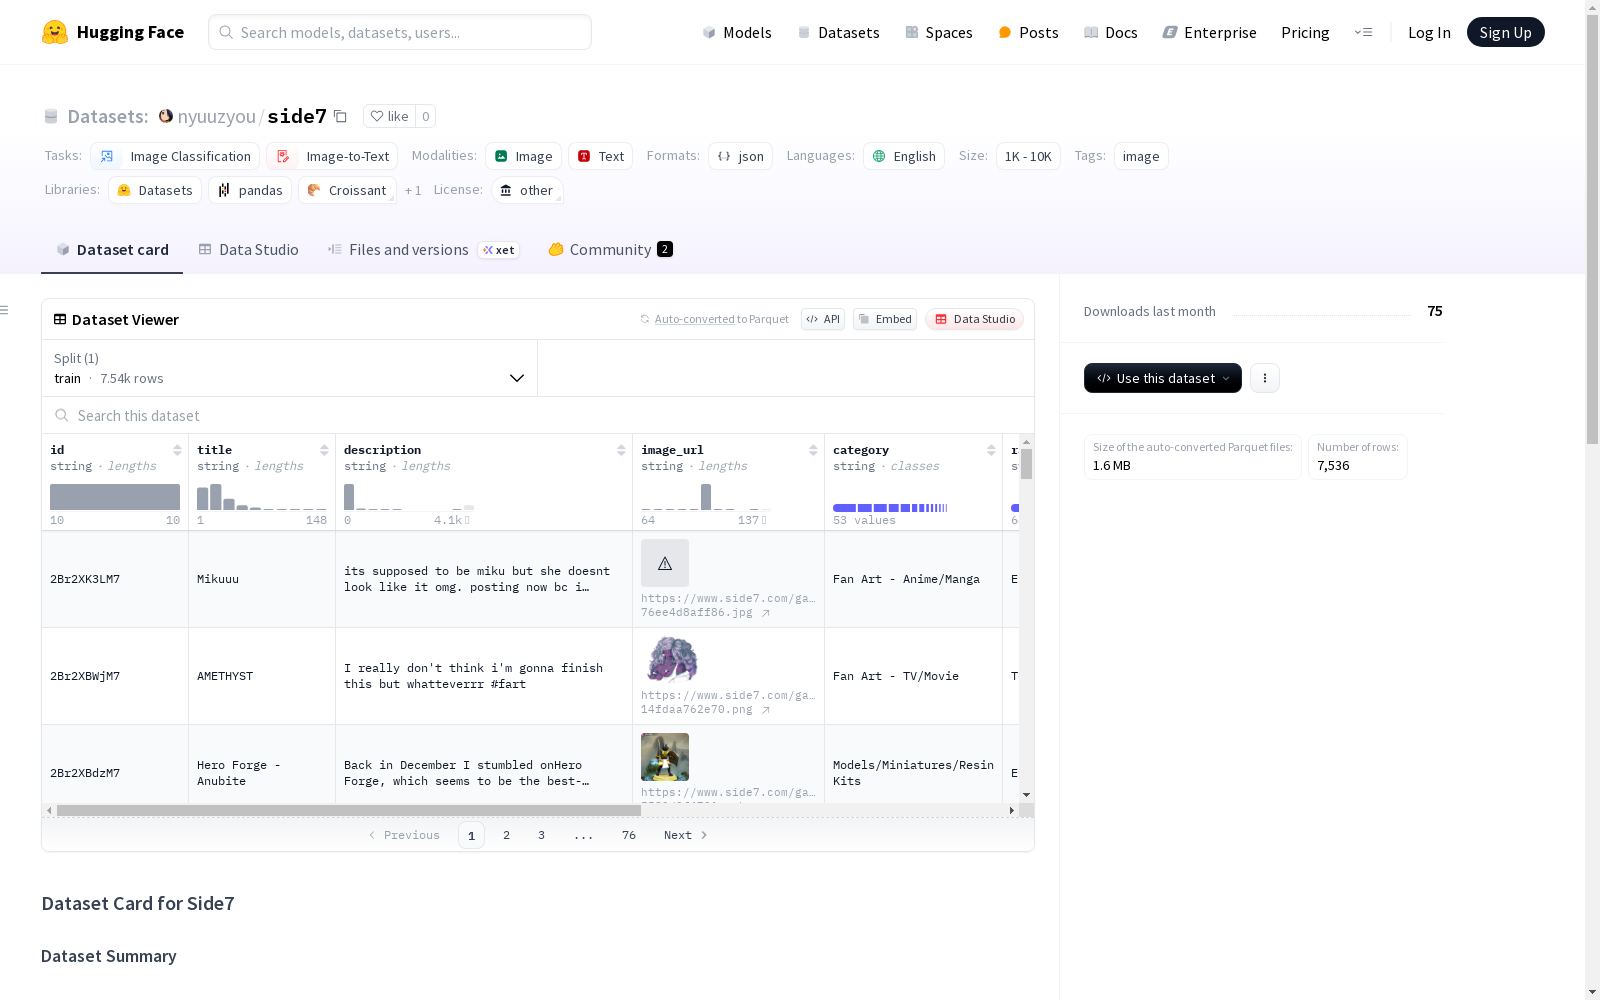
Side7数据集是从side7.com网站收集的艺术作品数据集,包含了新手和资深艺术家以及艺术爱好者的作品。数据集包括图像以及相关的元数据,如标题、描述、分类、评分和标签等。
The Side7 Dataset is an artwork dataset collected from the website side7.com. It contains works created by novice and seasoned artists, as well as art enthusiasts. The dataset includes images and associated metadata such as titles, descriptions, categories, ratings, tags and other relevant information.
创建时间:
2025-04-16
原始信息汇总
Side7 数据集概述
数据集摘要
- 数据集来源:side7.com(在线虚拟艺术画廊和社区)
- 内容类型:艺术作品图像及相关元数据
- 元数据包含:标题、描述、类别、评分、标签等
- 目标用户:新手和资深艺术家及艺术爱好者
语言信息
- 主要语言:英语(en)
- 备注:部分作品描述可能包含多语言内容
数据集结构
数据文件组成
- 图像文件:
- 存储于8个ZIP压缩包(images_00.zip至images_07.zip)
- 元数据文件:
- JSONL格式(side7.jsonl.zst)
- 包含作品ID、标题、描述、类别等信息
- 索引文件:
- CSV格式的归档索引文件
数据字段说明
| 字段名 | 描述 |
|---|---|
| id | 作品唯一标识符 |
| title | 作品标题 |
| description | 艺术家提供的作品描述 |
| image_url | 作品图像URL |
| category | 作品类别(如"Fan Art - Anime/Manga") |
| rating | 内容评级(如"Everyone") |
| class | 作品分类(如"Finished Work") |
| tags | 作品关联标签数组 |
| timestamp | 作品发布时间戳(Unix格式) |
数据划分
- 总条目数:7,610
- 划分方式:单一集合(无训练/验证/测试划分)
搜集汇总
数据集介绍
构建方式
Side7数据集构建于side7.com这一在线虚拟艺术画廊和社区平台,该平台汇聚了从新手到资深艺术家及艺术爱好者的丰富创作。数据集通过系统化采集平台上的艺术作品及其元数据构建而成,包含图像文件及对应的JSONL格式元数据文件。图像文件按8个ZIP归档文件存储,元数据则详细记录了每幅作品的ID、标题、描述、分类等关键信息,形成完整的艺术作品数字化档案。
特点
该数据集最显著的特点在于其艺术作品的多样性和丰富的元数据标注。7600余件作品涵盖不同风格、主题和技法,每件作品均附有艺术家提供的标题、详细描述和分类标签。元数据中特别包含内容分级、作品类型等结构化字段,为研究艺术风格演变、创作趋势分析提供了多维度数据支撑。英文为主的描述文本保持了语言一致性,同时保留了艺术家的个性化表达。
使用方法
使用该数据集时,需先解压图像ZIP归档文件,并与JSONL元数据文件建立映射关系。研究人员可通过作品ID实现图像与元数据的精准匹配,利用分类标签和评分字段进行艺术风格聚类分析。文本描述字段适用于跨模态学习任务,而时间戳信息支持创作时序研究。建议通过archive index CSV文件快速定位特定图像所在归档,提升数据访问效率。
背景与挑战
背景概述
Side7数据集源于side7.com这一线上虚拟艺术画廊与社区,汇聚了业余与专业艺术家及艺术爱好者的创作。该数据集由艺术作品图像及相关元数据构成,包括标题、描述、类别、评分和标签等信息,旨在为图像分类与图像到文本任务提供丰富资源。其创建背景反映了数字艺术社区蓬勃发展的趋势,为研究艺术作品的自动分类、内容理解及跨模态分析提供了独特的数据支持。数据集的结构化设计凸显了对艺术作品多维度特征捕捉的学术考量,体现了数字人文与计算机视觉交叉领域的研究价值。
当前挑战
该数据集面临的核心挑战在于艺术作品的语义复杂性。图像分类任务需克服风格多样性、主观标签不一致性等问题,而图像到文本转换则需处理艺术家描述语言的非标准化表达。数据构建过程中,元数据采集面临网页结构变迁导致的信息缺失风险,图像质量参差不齐亦增加了预处理难度。多模态对齐要求精确匹配视觉内容与文本描述,这对标注一致性提出了较高要求。此外,社区用户生成内容的版权声明差异,为数据集合法使用带来了潜在法律挑战。
常用场景
经典使用场景
在数字艺术领域,Side7数据集为研究人员提供了丰富的艺术作品及其元数据,成为图像分类和图像到文本生成任务的理想选择。该数据集包含多样化的艺术风格和类别,使得机器学习模型能够学习到广泛的艺术特征和语义关联。通过分析这些艺术作品及其描述,研究者可以探索艺术风格识别、内容生成等前沿课题。
衍生相关工作
基于Side7数据集,研究者已开展多项经典工作,包括艺术风格迁移算法、跨模态检索系统以及艺术图像自动标注工具的开发。这些工作不仅扩展了数据集的应用范围,还为数字艺术领域的智能化发展提供了技术基础。部分研究进一步探索了艺术作品的情感分析和美学评价,丰富了艺术计算的研究维度。
数据集最近研究
最新研究方向
在数字艺术与机器学习交叉领域,Side7数据集因其丰富的艺术作品元数据而成为研究热点。该数据集被广泛应用于图像分类与文本生成模型的训练,特别是在跨模态学习任务中,如基于文本描述的艺术作品生成或艺术作品风格迁移。近期研究聚焦于利用其多标签分类体系探索艺术作品风格与情感表达的深层关联,以及通过自然语言处理技术解析艺术家创作意图。随着AIGC技术的爆发式发展,该数据集在稳定扩散模型训练中的价值进一步凸显,为研究艺术创作规律与机器审美提供了独特样本。
以上内容由遇见数据集搜集并总结生成


