遇见数据集

ChnSentiCorp_htl_all, waimai_10k, online_shopping_10_cats, weibo_senti_100k, simplifyweibo_4_moods, dmsc_v2, yf_dianping, yf_amazon, dh_msra, ez_douban, baoxianzhidao, anhuidianxinzhidao, financezhidao, lawzhidao, liantongzhidao, nonghangzhidao

收藏
github2024-02-29 更新2024-05-31 收录
官方服务:

资源简介:

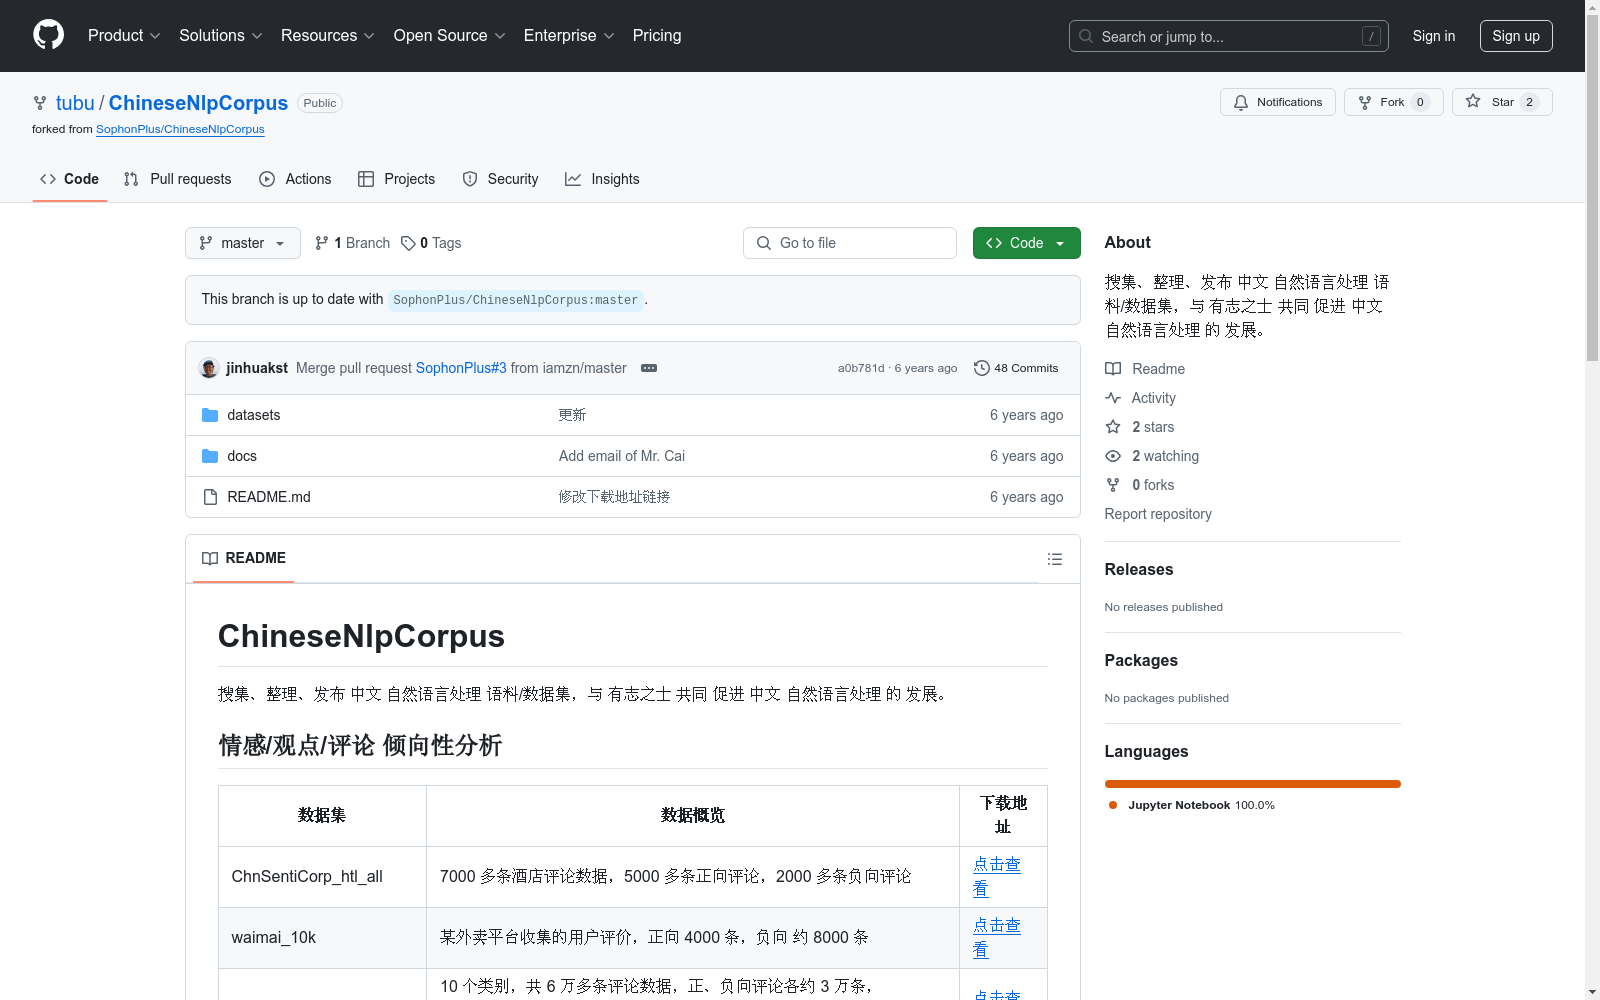
ChnSentiCorp_htl_all: 7000 多条酒店评论数据,5000 多条正向评论,2000 多条负向评论。waimai_10k: 某外卖平台收集的用户评价,正向 4000 条,负向 约 8000 条。online_shopping_10_cats: 10 个类别,共 6 万多条评论数据,正、负向评论各约 3 万条,包括书籍、平板、手机、水果、洗发水、热水器、蒙牛、衣服、计算机、酒店。weibo_senti_100k: 10 万多条,带情感标注 新浪微博,正负向评论约各 5 万条。simplifyweibo_4_moods: 36 万多条,带情感标注 新浪微博,包含 4 种情感,其中喜悦约 20 万条,愤怒、厌恶、低落各约 5 万条。dmsc_v2: 28 部电影,超 70 万 用户,超 200 万条 评分/评论 数据。yf_dianping: 24 万家餐馆,54 万用户,440 万条评论/评分数据。yf_amazon: 52 万件商品,1100 多个类目,142 万用户,720 万条评论/评分数据。dh_msra: 5 万多条中文命名实体识别标注数据(包括地点、机构、人物)。ez_douban: 5 万多部电影(3 万多有电影名称,2 万多没有电影名称),2.8 万 用户,280 万条评分数据。baoxianzhidao: 8000 多条保险行业问答数据,包括用户提问、网友回答、最佳回答。anhuidianxinzhidao: 15.6 万条电信问答数据,包括用户提问、网友回答、最佳回答。financezhidao: 77 万条金融行业问答数据,包括用户提问、网友回答、最佳回答。lawzhidao: 3.6 万条法律问答数据,包括用户提问、网友回答、最佳回答。liantongzhidao: 20.3 万条联通问答数据,包括用户提问、网友回答、最佳回答。nonghangzhidao: 4 万条农业银行问答数据,包括用户提问、网友回答、最佳回答。

ChnSentiCorp_htl_all: Over 7,000 hotel reviews, including more than 5,000 positive reviews and over 2,000 negative reviews. waimai_10k: User reviews collected from a food delivery platform, with 4,000 positive reviews and approximately 8,000 negative reviews. online_shopping_10_cats: Over 60,000 reviews across 10 categories, with roughly 30,000 positive and 30,000 negative reviews, covering books, tablets, mobile phones, fruits, shampoo, water heaters, Mengniu, clothing, computers, and hotels. weibo_senti_100k: Over 100,000 Sina Weibo posts with sentiment annotations, including approximately 50,000 positive and 50,000 negative reviews. simplifyweibo_4_moods: Over 360,000 Sina Weibo posts with sentiment annotations, covering four emotions: approximately 200,000 joyful posts, and around 50,000 each for anger, disgust, and sadness. dmsc_v2: Data from 28 movies, involving over 700,000 users and more than 2 million ratings/reviews. yf_dianping: Data from 240,000 restaurants, 540,000 users, and 4.4 million reviews/ratings. yf_amazon: Data from 520,000 products across more than 1,100 categories, 1.42 million users, and 7.2 million reviews/ratings. dh_msra: Over 50,000 Chinese named entity recognition annotations (including locations, organizations, and persons). ez_douban: Data from over 50,000 movies (30,000 with movie titles, 20,000 without), 28,000 users, and 2.8 million ratings. baoxianzhidao: Over 8,000 insurance industry Q&A data, including user questions, netizen answers, and best answers. anhuidianxinzhidao: 156,000 telecom Q&A data, including user questions, netizen answers, and best answers. financezhidao: 770,000 financial industry Q&A data, including user questions, netizen answers, and best answers. lawzhidao: 36,000 legal Q&A data, including user questions, netizen answers, and best answers. liantongzhidao: 203,000 China Unicom Q&A data, including user questions, netizen answers, and best answers. nonghangzhidao: 40,000 Agricultural Bank of China Q&A data, including user questions, netizen answers, and best answers.

创建时间:
2019-02-14
原始信息汇总

情感/观点/评论 倾向性分析

数据集 数据概览
ChnSentiCorp_htl_all 7000 多条酒店评论数据,5000 多条正向评论,2000 多条负向评论
waimai_10k 某外卖平台收集的用户评价,正向 4000 条,负向 约 8000 条
online_shopping_10_cats 10 个类别,共 6 万多条评论数据,正、负向评论各约 3 万条,包括书籍、平板、手机、水果、洗发水、热水器、蒙牛、衣服、计算机、酒店
weibo_senti_100k 10 万多条,带情感标注 新浪微博,正负向评论约各 5 万条
simplifyweibo_4_moods 36 万多条,带情感标注 新浪微博,包含 4 种情感,其中喜悦约 20 万条,愤怒、厌恶、低落各约 5 万条
dmsc_v2 28 部电影,超 70 万 用户,超 200 万条 评分/评论 数据
yf_dianping 24 万家餐馆,54 万用户,440 万条评论/评分数据
yf_amazon 52 万件商品,1100 多个类目,142 万用户,720 万条评论/评分数据

中文命名实体识别

数据集 数据概览
dh_msra 5 万多条中文命名实体识别标注数据(包括地点、机构、人物)

推荐系统

数据集 数据概览
ez_douban 5 万多部电影(3 万多有电影名称,2 万多没有电影名称),2.8 万 用户,280 万条评分数据
dmsc_v2 28 部电影,超 70 万 用户,超 200 万条 评分/评论 数据
yf_dianping 24 万家餐馆,54 万用户,440 万条评论/评分数据
yf_amazon 52 万件商品,1100 多个类目,142 万用户,720 万条评论/评分数据

FAQ 问答系统

数据集 数据概览
保险知道 8000 多条保险行业问答数据,包括用户提问、网友回答、最佳回答
安徽电信知道 15.6 万条电信问答数据,包括用户提问、网友回答、最佳回答
金融知道 77 万条金融行业问答数据,包括用户提问、网友回答、最佳回答
法律知道 3.6 万条法律问答数据,包括用户提问、网友回答、最佳回答
联通知道 20.3 万条联通问答数据,包括用户提问、网友回答、最佳回答
农行知道 4 万条农业银行问答数据,包括用户提问、网友回答、最佳回答
保险知道 58.8 万条保险行业问答数据,包括用户提问、网友回答、最佳回答
搜集汇总
数据集介绍
ChnSentiCorp_htl_all, waimai_10k, online_shopping_10_cats, weibo_senti_100k, simplifyweibo_4_moods, dmsc_v2, yf_dianping, yf_amazon, dh_msra, ez_douban, baoxianzhidao, anhuidianxinzhidao, financezhidao, lawzhidao, liantongzhidao, nonghangzhidao 数据集图片
构建方式
在中文自然语言处理领域,ChnSentiCorp_htl_all等数据集的构建依托于实际应用场景中的用户生成内容。这些数据集通过爬取和整理来自酒店评论、外卖平台评价、在线购物评论、微博情感表达、电影评分、餐馆评价、商品评论等多种来源的文本数据,确保了数据的多样性和代表性。每个数据集都经过严格的清洗和标注,以确保数据的质量和可用性。
特点
ChnSentiCorp_htl_all等数据集以其广泛的数据来源和丰富的标注信息著称。例如,ChnSentiCorp_htl_all包含7000多条酒店评论,其中正向和负向评论分别占5000多条和2000多条,为情感分析提供了坚实的基础。其他数据集如weibo_senti_100k和simplifyweibo_4_moods则提供了数十万条带有情感标注的微博数据,涵盖了多种情感类别,极大地丰富了情感分析的研究资源。
使用方法
这些数据集广泛应用于情感分析、命名实体识别、推荐系统和FAQ问答系统等领域。研究人员和开发者可以通过下载数据集,利用其丰富的标注信息进行模型训练和测试。例如,ChnSentiCorp_htl_all可用于训练和评估情感分类模型,而dh_msra则适用于中文命名实体识别任务。通过结合具体的研究需求,这些数据集能够有效提升自然语言处理模型的性能和泛化能力。
背景与挑战
背景概述
ChineseNlpCorpus是一个专注于中文自然语言处理的数据集集合,涵盖了情感分析、命名实体识别、推荐系统以及FAQ问答系统等多个领域。该数据集由多个子集组成,如ChnSentiCorp_htl_all、waimai_10k、online_shopping_10_cats等,每个子集都针对特定的应用场景进行了精心设计。这些数据集的创建旨在为中文自然语言处理研究提供丰富的语料资源,推动该领域的技术进步。通过整合来自不同平台和领域的数据,ChineseNlpCorpus为研究人员提供了多样化的实验环境,极大地促进了中文文本分析、情感识别、实体识别等任务的发展。
当前挑战
ChineseNlpCorpus在构建和应用过程中面临多重挑战。首先,情感分析数据集如ChnSentiCorp_htl_all和weibo_senti_100k需要处理中文文本的复杂语义和情感表达,尤其是在社交媒体和评论中,情感倾向往往隐含且多变,增加了标注和分类的难度。其次,命名实体识别数据集如dh_msra需要准确识别中文中的地点、机构、人物等实体,而中文的语法结构和实体命名规则与英文存在显著差异,增加了模型的训练难度。此外,推荐系统数据集如ez_douban和yf_dianping需要处理大规模的用户评分和评论数据,如何在稀疏数据中提取有效特征并生成个性化推荐是一个技术难点。最后,FAQ问答系统数据集如financezhidao和lawzhidao需要处理专业领域的问答数据,如何理解用户提问并提供准确的回答是构建智能问答系统的核心挑战。
常用场景
经典使用场景
在自然语言处理领域,ChnSentiCorp_htl_all等数据集广泛应用于情感分析任务。研究者利用这些数据集训练和评估情感分类模型,以识别和分类用户评论中的情感倾向。例如,酒店评论数据集ChnSentiCorp_htl_all被用于分析用户对酒店服务的满意度,从而帮助酒店改进服务质量。
衍生相关工作
基于这些数据集,研究者开发了多种经典的情感分析模型和算法。例如,利用weibo_senti_100k数据集,研究者提出了基于深度学习的微博情感分类模型。此外,simplifyweibo_4_moods数据集被用于多情感分类任务,推动了情感分析领域的多样化发展。这些工作不仅丰富了情感分析的研究内容,还为实际应用提供了技术支持。
数据集最近研究
最新研究方向
在中文自然语言处理领域,情感分析、命名实体识别和推荐系统等研究方向持续受到广泛关注。ChnSentiCorp_htl_all、waimai_10k等数据集为情感分析提供了丰富的酒店和外卖评论数据,推动了基于深度学习的细粒度情感分类技术的发展。dh_msra数据集在命名实体识别任务中表现突出,支持了多领域实体识别模型的优化。ez_douban、yf_dianping等推荐系统数据集则为个性化推荐算法的研究提供了大规模的用户行为数据,促进了跨领域推荐系统的创新。此外,FAQ问答系统数据集如baoxianzhidao、financezhidao等,为智能客服和知识图谱构建提供了重要支持,推动了问答系统的自动化和智能化进程。这些数据集的应用不仅提升了中文自然语言处理技术的精度和效率,也为相关领域的实际应用场景提供了有力支撑。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

