dsv4-flash-sm86-8x3090
收藏资源简介:
该数据集/资源库提供了在 8 块 RTX 3090 (SM86, 24GB) 显卡上运行 W4A16 量化版 DeepSeek-V4-Flash 模型的完整推理服务栈。内容包含:不同并发序列和上下文长度下的聚合解码吞吐量表格(1×262K 至 4×80K 上下文,聚合吞吐量 59.6–120.1 tok/s);预填充性能(262K 边界约 451 tok/s);模型权重来源(Intel/DeepSeek-V4-Flash-W4A16-AutoRound);详细的软件锁定(Python 3.12.12, PyTorch 2.11.0, CUDA 13.0.1, FlashInfer, Marlin MoE 等);启动脚本(最小复现与最大吞吐量);以及多份技术文档(模型构建、运行手册、漏洞利用基准测试、终端基准测试、上下文扩展路线图)。所有数据均通过确定的 needle 探测验证,确保一致性。该资源适用于需要复现或基准测试 DeepSeek-V4-Flash 模型在消费级 GPU 集群上推理性能的研究者和工程师。
This dataset/repository provides a complete inference service stack for running the W4A16 quantized version of the DeepSeek-V4-Flash model on 8 RTX 3090 (SM86, 24GB) GPUs. It includes: aggregated decoding throughput tables under different concurrent sequences and context lengths (1×262K to 4×80K context, aggregated throughput 59.6–120.1 tok/s); prefill performance (approximately 451 tok/s at 262K boundary); model weight source (Intel/DeepSeek-V4-Flash-W4A16-AutoRound); detailed software lock (Python 3.12.12, PyTorch 2.11.0, CUDA 13.0.1, FlashInfer, Marlin MoE, etc.); start scripts (minimum reproduction and maximum throughput); and multiple technical documents (model building, run manual, exploit benchmark, terminal benchmark, context extension roadmap). All data are verified by deterministic needle probing to ensure consistency. This resource is suitable for researchers and engineers who need to reproduce or benchmark the inference performance of DeepSeek-V4-Flash model on consumer-grade GPU clusters.
DeepSeek-V4-Flash on 8x RTX 3090 (SM86) 数据集详情
核心目标
在8张RTX 3090显卡(SM 8.6架构,单卡24GB显存)上运行DeepSeek-V4-Flash级别的W4A16量化模型,实现262K上下文长度与最高120 tok/s的聚合吞吐。该数据集主要提供服务配方、启动封装脚本以及实测的吞吐/上下文阶梯数据。
性能阶梯
不同并发序列数对应的上下文长度与吞吐表现如下:
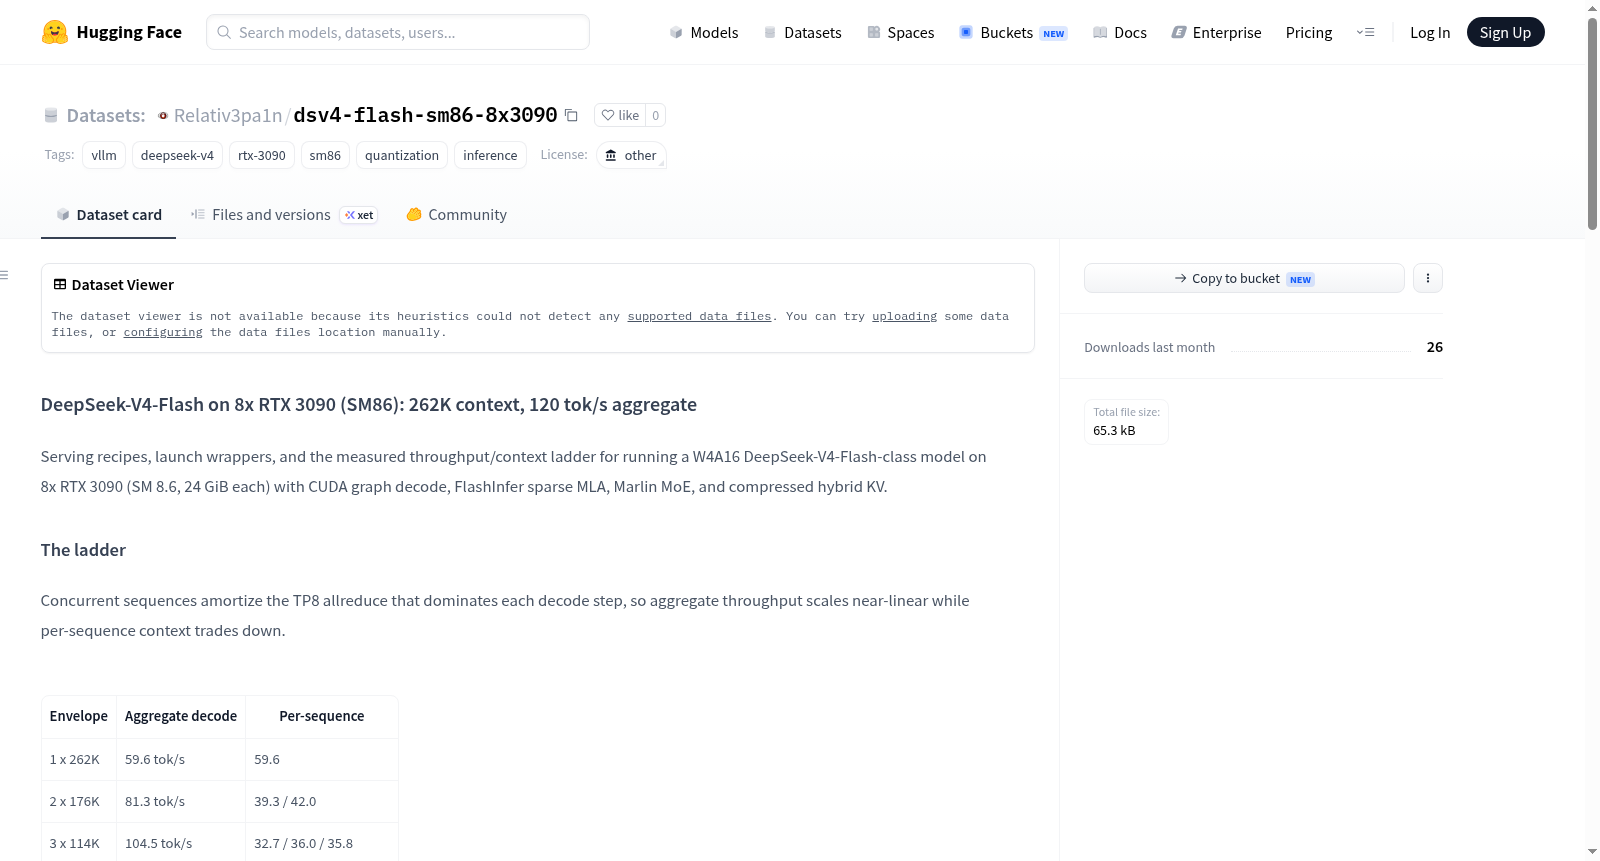
| 并发配置 | 聚合解码吞吐 | 每序列解码吞吐 |
|---|---|---|
| 1 × 262K | 59.6 tok/s | 59.6 tok/s |
| 2 × 176K | 81.3 tok/s | 39.3 / 42.0 tok/s |
| 3 × 114K | 104.5 tok/s | 32.7 / 36.0 / 35.8 tok/s |
| 4 × 80K | 120.1 tok/s | 29.2 / 30.3 / 30.3 / 30.2 tok/s |
- 所有数据均通过全上下文精确needle探针验证一致性
- 262K上下文极限下的预填充速度约为451 tok/s,并成功通过258K token needle测试
- 随着并发序列增加,聚合吞吐近似线性增长,每序列上下文相应减少
模型与量化
- 建议复现使用的公开检查点:Intel/DeepSeek-V4-Flash-W4A16-AutoRound
- 量化方案:AutoRound W4A16,group size 128
- 量化属于输入检查点属性,本仓库的SM86工作聚焦于服务栈
- 完整的abliterated变体构建链见
docs/MODEL_PREP.md,量化配置见reference/config.json
技术栈与软件版本
- Python 3.12.12,PyTorch 2.11.0+cu130,CUDA 13.0.1(以
TORCH_CUDA_ARCH_LIST=8.6重新编译) - FlashInfer
0.6.14+sm89.1(为SM86进行JIT编译) - 使用Marlin MoE、
kv_cache_dtype=fp8_ds_mla、attention_backend=FLASHINFER_MLA_SPARSE_DSV4 - 核心组件包括CUDA graph解码、FlashInfer稀疏MLA、Marlin MoE以及压缩混合KV
数据集内容
docs/MODEL_PREP.md:检查点构建链,包括官方FP8基础模型、rank-1 abliteration(固定工具、方向文件、参数)以及确定性无模型AutoRound W4A16配方docs/SM86_DSV4_RUNBOOK.md:硬件/软件固定版本、复现结果、启动命令、内存参数、验证清单及rank0 trace分解(每个graph step 18ms中17.5ms为TP8 allreduce)docs/EXPLOIT_BENCH.md:漏洞利用阶梯测试结果(ExploitBench v8-bench,3个已修补CVE,确定性评分器,T5全覆盖,零漏洞利用原语)docs/TERMINAL_BENCH.md:终端代理工作一致性校验(在未见过的测试框架下,5/18解决,多步工具循环完整)docs/SM86_256K_ROADMAP.md:上下文/序列阶梯方法论、NCCL矩阵、配置分析及内核工作顺序scripts/:已验证的启动封装脚本,启动时打印完整argv、git修订版本、导入来源及内存参数
快速复现
- 最小复现(262K上下文):运行
scripts/serve_sm86_262k_cudagraph.sh - 最大吞吐(80K上下文,4序列):运行
scripts/serve_sm86_80k_4seq_cudagraph.sh
实验构建方式
该技术栈由编排代理工作流构建:PAI(个人AI基础设施)负责管理设备、启动、测试和追踪,驱动GPT-5.5编码代理进行了约三周的迭代内核和后端工作。所有命令通过tmux终端复用器在编排笔记本电脑上执行,编码代理沙箱无外网,代码和文档通过本地Gitea传输。
参考来源
- DeepSeek-V4技术报告:https://arxiv.org/html/2606.19348v1
- CSA/HCA详解:https://prathamp.com/blog/deepseek-v4-csa-and-hca/
- Ampere社区分支:https://github.com/Lasimeri/vllm-dsv4-ampere
许可
启动封装脚本和文档遵循仓库许可证,模型权重遵循其上游许可证。