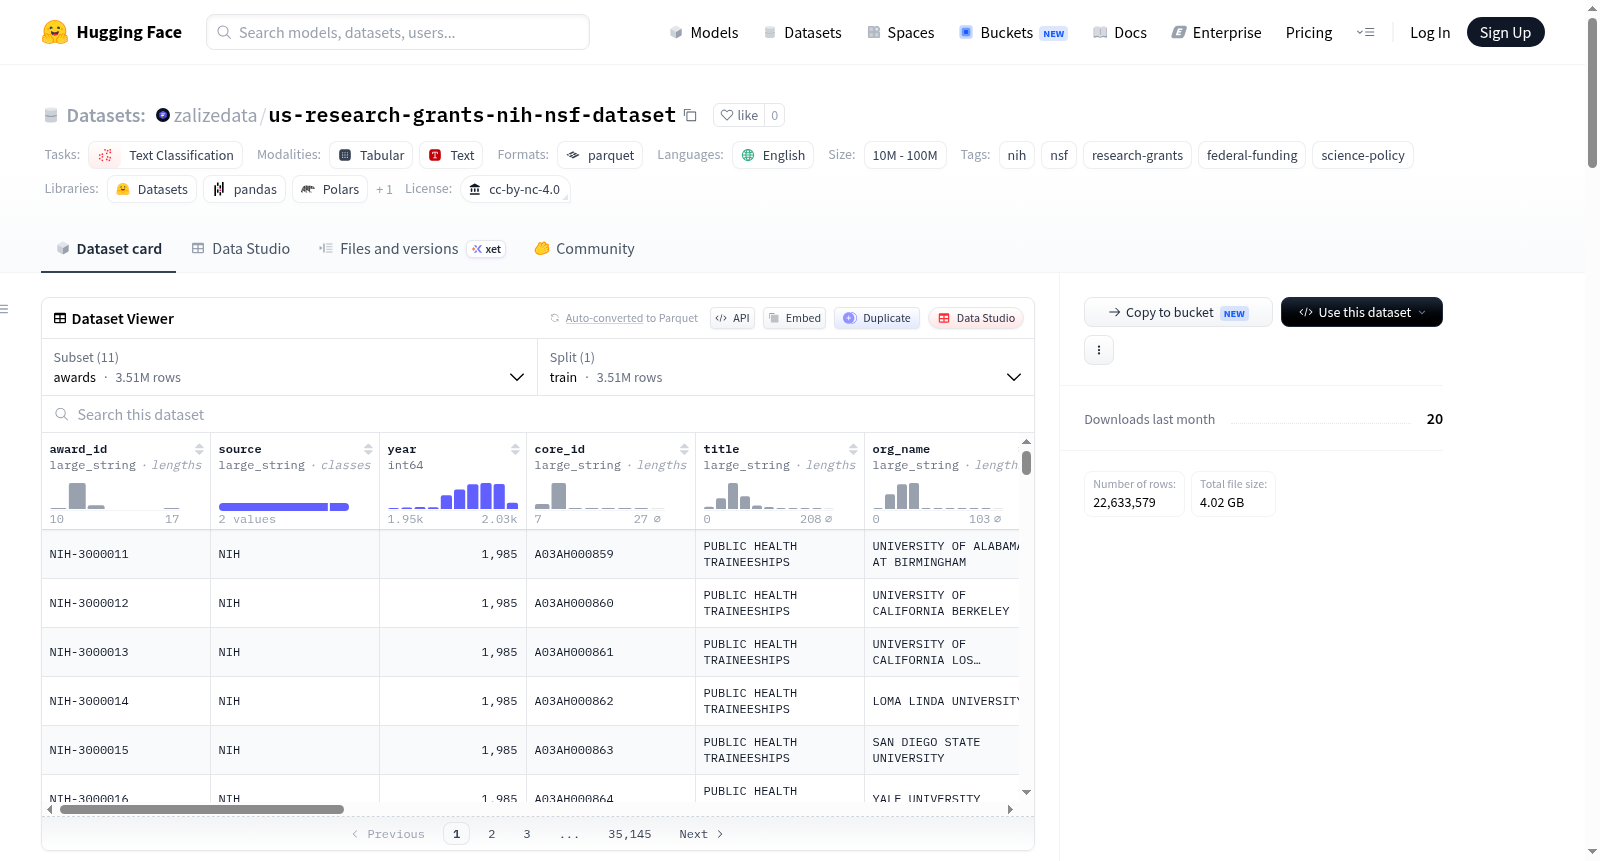
us-research-grants-nih-nsf-dataset
收藏资源简介:
该数据集整合了美国联邦研究资助数据,具体来自 NIH(美国国立卫生研究院)的 ExPORTER 项目资助和 NSF(美国国家科学基金会)的奖项数据,以分析就绪的表格形式呈现。数据集包含多个子表(配置),例如:awards(奖项总表)、nih_clinical_studies(NIH 临床研究)、nih_patents(NIH 专利)、nih_projects(NIH 项目)、nih_publications(NIH 出版物)、nih_publink(NIH 出版物链接)、nsf_awards(NSF 奖项)、org_year_funding(机构年度经费)、pi_award_edges(首席研究员与奖项关联)、pi_profiles(研究员档案)以及 project_publication_counts(项目发表计数)。总数据量超过 1000 万行(具体各表行数见 README 表格),采用 Parquet 格式存储,并提供多个压缩包(Tier S、M、L)供不同规模使用。数据覆盖金额、机构、研究人员和项目元数据,但不包含摘要全文。该数据集适用于资助格局与策略研究、大学及 PI 基准测试、技术转移与创新链分析,以及将资助与出版物、专利进行关联分析。数据遵循 CC BY-NC 4.0 许可(学术/个人使用免费,需注明出处并链接回 data.zalize.com),商业使用需获取商业许可。
This dataset integrates U.S. federal research funding data, specifically from NIH (National Institutes of Health) ExPORTER project grants and NSF (National Science Foundation) award data, presented in analysis-ready tabular format. It contains multiple sub-tables (configurations) such as: awards, nih_clinical_studies, nih_patents, nih_projects, nih_publications, nih_publink, nsf_awards, org_year_funding, pi_award_edges, pi_profiles, and project_publication_counts. The total data volume exceeds 10 million rows (specific row counts for each table are provided in the README table), stored in Parquet format, with multiple compressed packages (Tier S, M, L) for different scales. The data covers amounts, institutions, researchers, and project metadata, but does not include full abstracts. This dataset is suitable for funding landscape and strategy research, university and PI benchmarking, technology transfer and innovation chain analysis, as well as linking funding to publications and patents. The data is licensed under CC BY-NC 4.0 (free for academic/personal use with attribution and link back to data.zalize.com), and commercial use requires a commercial license.
US Research Grants (NIH + NSF) 数据集概述
基本信息
- 数据集名称: US Research Grants (NIH + NSF)
- 语言: 英语
- 许可证: CC BY-NC 4.0(学术/个人使用);商业使用需单独获得DataForge商业许可证
- 数据规模: 10M < n < 100M 行
- 任务类型: 文本分类
- 数据来源: NIH ExPORTER + NSF Awards API 官方批量数据
数据集内容
该数据集将美国联邦科研资助整理为可直接分析的数据表,涵盖NIH(美国国立卫生研究院)项目资助和NSF(美国国家科学基金会)奖项数据,包括金额、机构、研究人员及项目元数据(不含摘要全文)。
数据表配置(共11个)
| 表格配置名 | 行数 | 大小 |
|---|---|---|
awards |
3,514,467 | 250.1 MB |
nih_clinical_studies |
39,313 | 2.1 MB |
nih_patents |
92,343 | 4.4 MB |
nih_projects |
2,951,523 | 324.8 MB |
nih_publications |
3,078,034 | 518.9 MB |
nih_publink |
7,329,428 | 79.5 MB |
nsf_awards |
562,944 | 55.4 MB |
org_year_funding |
229,919 | 3.1 MB |
pi_award_edges |
3,866,665 | 136.9 MB |
pi_profiles |
532,881 | 21.1 MB |
project_publication_counts |
436,062 | 4.6 MB |
数据格式与加载方式
- 原生格式: Parquet(snappy压缩)
- 支持加载方式: pandas、polars、duckdb,以及Hugging Face
datasets库 - 提供CSV/JSONL副本、数据字典、数据说明书及QA报告
数据包层级
| 包名 | 层级 | 行数 | 大小 |
|---|---|---|---|
research_grants-tier1-S-2026-08-05.zip |
S(入门) | 42,609 | 5.9 MB |
research_grants-tier1-M-2026-08-05.zip |
M(研究) | 785,707 | 55.5 MB |
research_grants-tier1-L-2026-08-05.zip |
L(完整) | 22,633,579 | 2.32 GB |
应用场景
- 资助格局与资助策略研究
- 大学及首席研究员(PI)基准分析
- 技术转移与创新链分析
- 将资助与出版物和专利进行关联
引用方式
text DataForge (data.zalize.com), built from official NIH/NSF public data — https://data.zalize.com/datasets/us-research-grants-nih-nsf-dataset
DOI(Zenodo镜像): 10.5281/zenodo.21837780