blk-text-corpus
收藏资源简介:
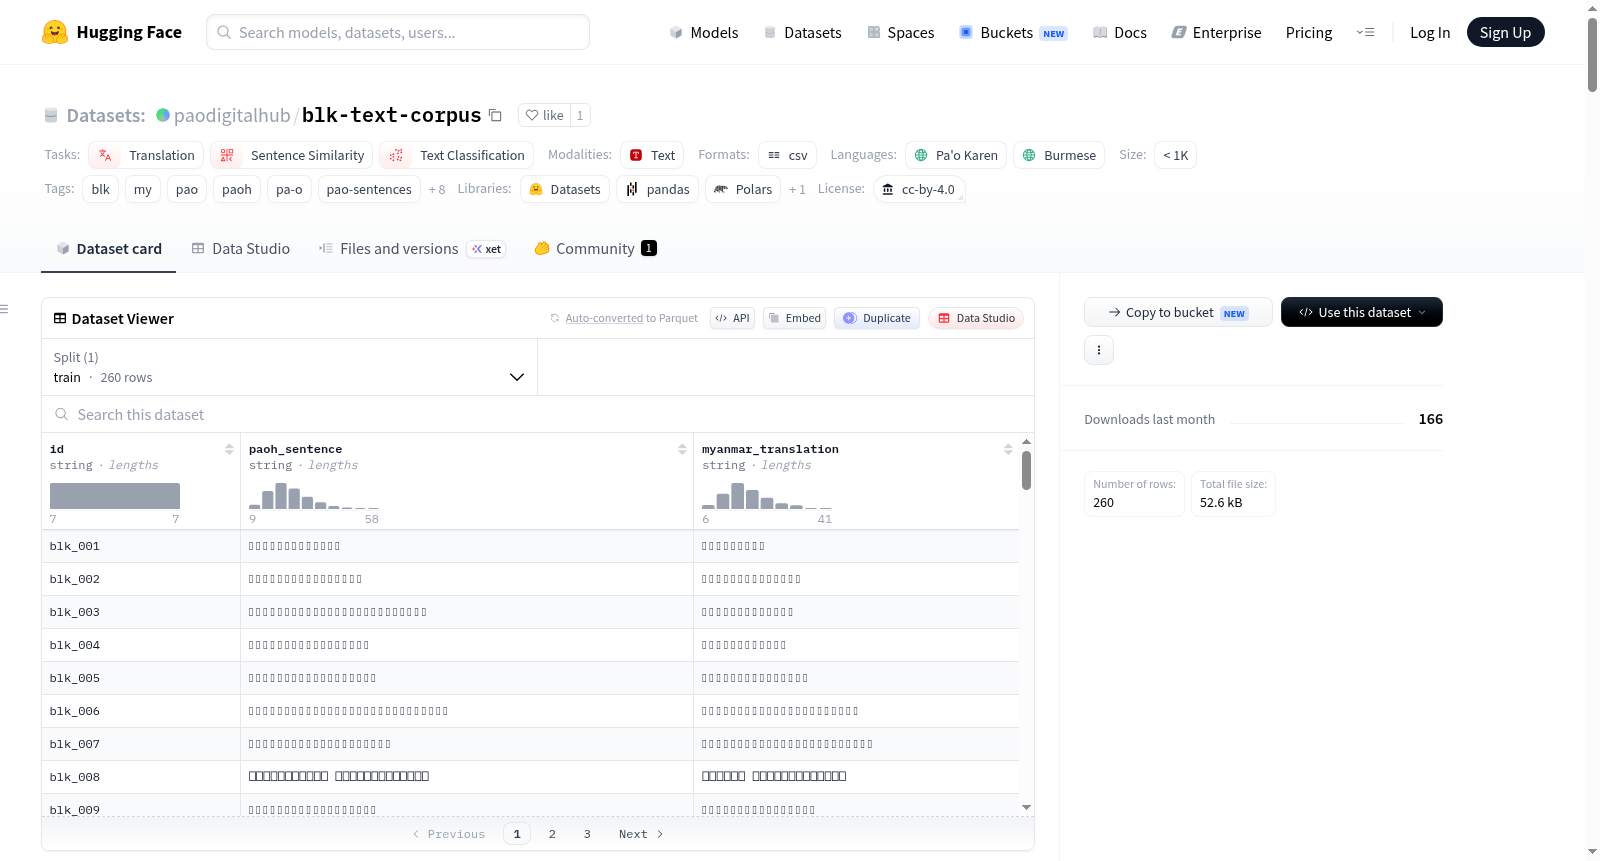
该数据集是 PaO Digital Hub 项目官方发布的 PaO 语(ISO 639-3: blk)与缅甸语(Myanmar)平行语料库,包含经过本地母语者验证的句子对。数据以 CSV 格式存储,采用 UTF-8 BOM 编码,包含三个字段:唯一句子标识符(id)、PaO 语验证文本(paoh_sentence)和准确的缅甸语翻译(myanmar_translation)。数据集规模小于 1000 条,可用于机器翻译、句子相似度计算和文本分类等任务。所有数据均经过 PaO Digital Hub 的标准化流程审核,确保可靠性和准确性。
This dataset is a parallel corpus of PaO (ISO 639-3: blk) and Myanmar languages officially released by the PaO Digital Hub project, containing sentence pairs verified by native speakers. The data is stored in CSV format with UTF-8 BOM encoding and includes three fields: unique sentence identifier (id), PaO verified text (paoh_sentence), and accurate Myanmar translation (myanmar_translation). The dataset size is less than 1000 entries and can be used for tasks such as machine translation, sentence similarity calculation, and text classification. All data has been reviewed by the standardized process of PaO Digital Hub to ensure reliability and accuracy.
Verified PaO (Blk) Text Corpus - PaO Digital Hub 数据集详情
数据集概述
这是一个官方的、经过验证的PaO语(ISO 639-3: blk)与缅甸语(Myanmar)平行句对数据集。数据由PaO当地母语者提供,并按照PaO Digital Hub的官方项目流程系统性地编制而成。
核心特点与可信度验证
| 特点 | 说明 |
|---|---|
| 母语来源 | 由PaO当地精通PaO文学的专业人士亲自发布/收集 |
| 官方验证 | 按照PaO Digital Hub标准流程审核的官方数据 |
| 标准化格式 | 依据ISO 639-3(blk)标准构建ID与数据结构 |
数据规模与类别
- 许可协议:cc0-1.0(公有领域)
- 语言:blk(PaO语)、my(缅甸语)
- 多语言性:多语种、翻译用途
- 数据集规模:少于1K条样本(n<1K)
- 任务类别:翻译、句子相似度、文本分类
数据结构
数据集以CSV格式存储,采用UTF-8 BOM编码,包含以下字段:
| 列名 | 类型 | 描述 |
|---|---|---|
id |
string | 唯一句子标识符(例如:blk_001) |
paoh_sentence |
string | 经过验证的PaO语文本 |
myanmar_translation |
string | 准确的缅甸语翻译 |
文件结构
text blk-text-corpus/ ├── README.md └── data/ └── paoh-sentences/ └── blk-sentences-001.csv
使用方式
可通过Hugging Face datasets 库加载数据集,或使用pandas直接读取CSV文件。数据集支持数据加载与转换,适用于构建PaO语-缅甸语平行语料库相关的自然语言处理任务。