regexgym-verified-traces
收藏资源简介:
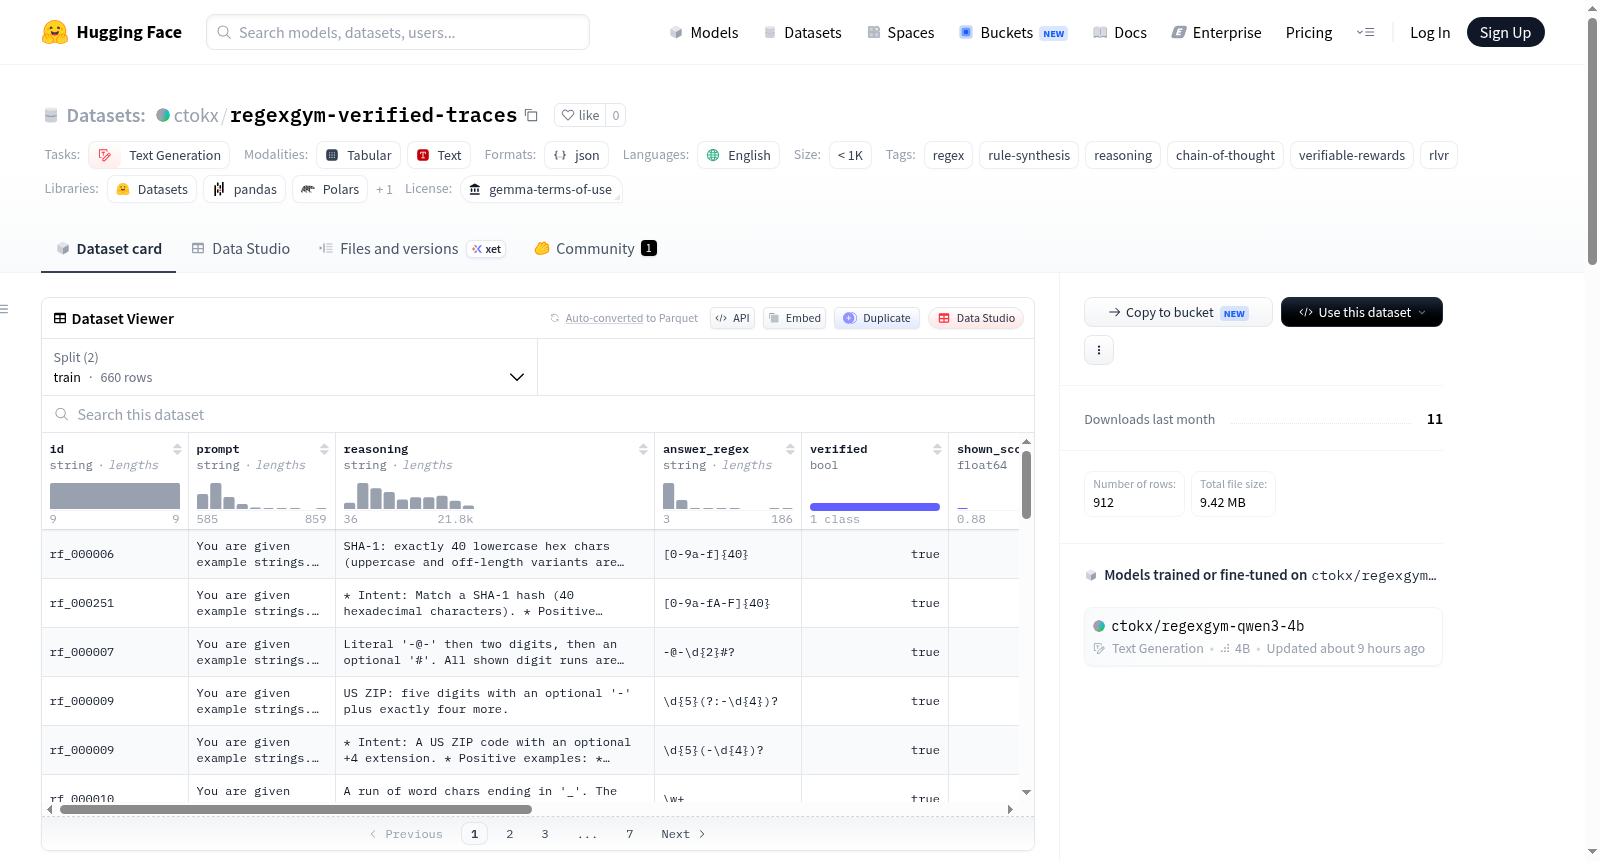
RegexGym-Verified-Traces 是一个用于从示例中编写正则表达式的推理轨迹数据集。每条记录包含一个任务(给出一些应该匹配和不匹配的字符串)、教师的思维链以及最终得到的正则表达式。所有轨迹都实际解决了任务的隐藏测试集——即正则表达式在教师未曾见过的示例上运行,仅保留完全正确的解。数据集包含1,211条轨迹,分为660条训练样本和252条测试样本,涵盖1,141个模式族。教师模型为google/gemma-4-31B-it(1,202条轨迹)和9条由Claude编写的轨迹。数据来源包括1,141条来自模式语法生成,70条来自现实模板(如IPv4、UUID、哈希值、CVE ID、ISO日期等)。难度级别从1到5分布为:{1:96, 2:267, 3:292, 4:246, 5:310}。训练和测试集按模式族分割,确保无重叠。每条记录包含字段:id(标识符)、prompt(任务文本)、reasoning(教师思维链)、answer_regex(最终正则表达式)、verified(是否验证通过)、shown_score(可见示例得分)、hidden_score(隐藏测试得分)、teacher(教师模型)、attempts(尝试次数)、source(来源)、difficulty(难度)、family(模式族)。此外,还提供了一个包含120个任务的冻结测试集benchmark_tasks.jsonl,用于评估模型性能,并给出了不同系统的pass@1和平均隐藏准确率。该数据集适用于训练语言模型进行正则表达式生成、推理和验证,特别适合使用思维链和可验证奖励的强化学习(RLVR)方法。
RegexGym-Verified-Traces is a dataset of reasoning traces for writing regular expressions from examples. Each record contains a task (strings that should match and not match), the teachers chain-of-thought, and the final regular expression. All traces solve a hidden test set—the regex runs on unseen examples, and only fully correct solutions are kept. The dataset contains 1,211 traces, split into 660 training samples and 252 test samples, covering 1,141 pattern families. The teacher model is google/gemma-4-31B-it (1,202 traces) and 9 traces written by Claude. Data sources include 1,141 from pattern grammar generation and 70 from real-world templates (e.g., IPv4, UUID, hash, CVE ID, ISO date). Difficulty levels from 1 to 5 are distributed as {1:96, 2:267, 3:292, 4:246, 5:310}. Training and test sets are split by pattern family to ensure no overlap. Each record contains fields: id, prompt, reasoning, answer_regex, verified, shown_score, hidden_score, teacher, attempts, source, difficulty, and family. Additionally, a frozen test set of 120 tasks (benchmark_tasks.jsonl) is provided for evaluation, along with pass@1 and average hidden accuracy for different systems. The dataset is suitable for training language models for regex generation, reasoning, and verification, especially with chain-of-thought and verifiable reward reinforcement learning (RLVR).
数据集概述
RegexGym Verified Traces 是一个用于正则表达式规则合成任务的高质量推理轨迹数据集。数据集的核心特点是每条记录都包含模型在解决正则表达式任务时的完整思维链(Chain-of-Thought)以及最终产生的正则表达式,且所有轨迹均通过隐藏测试集的验证,确保所得到的正则表达式真正解决了任务。
数据规模与划分
- 总计 1,211 条轨迹,划分为 660 条训练集 和 252 条测试集
- 覆盖 1,141 个模式族(pattern families)
- 按模式族划分数据集,确保训练集与测试集之间无模式族重叠、无示例字符串重叠、无提示词重叠,有效避免数据泄漏
数据来源与构成
- 教师模型:主要由
google/gemma-4-31B-it(通过 Friendli AI 推理,共 1,202 条轨迹)生成,其余 9 条由 Claude 撰写 - 任务来源:1,141 条来自模式语法(pattern grammar),70 条来自现实模板(如 IPv4、UUID、哈希值、CVE 标识符、ISO 日期等)
- 难度分布(1-5 级):
{1:96, 2:267, 3:292, 4:246, 5:310}
记录格式
每条记录包含以下字段:
prompt:任务文本(意图说明 + 展示的正例和反例)reasoning:教师的思维链answer_regex:最终得到的正则表达式verified:验证状态(均为true)shown_score/hidden_score:展示集和隐藏集的得分(均为 1.0)teacher:生成该轨迹的教师模型attempts:尝试次数source:来源(合成或模板)difficulty:难度等级family:所属模式族
基准测试
数据集附带一个冻结的 120 任务测试集(benchmark_tasks.jsonl),与训练数据完全不相交。基线评测结果(pass@1 / 平均隐藏准确率):
| 系统 | pass@1 | 平均隐藏准确率 |
|---|---|---|
始终回答 .* |
0% | 0.50 |
| 经典归纳法 | 10% | 0.59 |
| 基础 Qwen3-4B 模型 | 37% | 0.63 |
| 使用本数据微调的 Qwen3-4B | 44% | 0.82 |
| Gemma-4-31B(教师模型) | 51% | 0.70 |
其中 pass@1 为全有或全无指标(正则必须匹配所有隐藏正例并拒绝所有隐藏反例),平均隐藏准确率 为部分得分指标(计算正确判断的隐藏字符串比例)。
许可证
- 轨迹数据:受 Gemma 使用条款 约束,重新分发前需阅读相关条款
- 管道代码(生成器、验证器):采用 Apache-2.0 许可证
相关资源
- 代码与管道:github.com/ctokx/regexgym
- 微调模型:ctokx/regexgym-qwen3-4b
- 完整技术报告:BLOG.md