
遇见数据集

MCG-NJU/VideoChat3-LV116k

收藏
Hugging Face2026-07-19 更新2026-07-22 收录
官方服务:

资源简介:

VideoChat3-LV116K是用于VideoChat3的长视频指令数据集,旨在通过长时上下文监督来补充短学术视频数据,其中证据可能稀疏、延迟并分布在多个视频片段中。该数据集通过长视频合成流水线构建:筛选候选长视频的视觉质量、语义内容和时序连贯性;将视频分割成可管理的时序片段,对每个片段进行注释和质量检查;将验证后的片段描述组装成全视频监督。基于此证据记录,流水线合成长视频字幕、长视频问答数据和时序标注。数据以JSONL注释文件形式提供,大多数原始视频未重复存储,但SciVideo视频已包含在仓库中,其他来源视频需从原始数据集中解析。数据来源包括CinePile、LongVideoDB、SciVideo_Long和SciVideo_Short数据集。

VideoChat3-LV116K is a long video instruction dataset for VideoChat3, which aims to supplement short academic video datasets via long-context supervision, where supporting evidence may be sparse, delayed and scattered across multiple video segments. This dataset is constructed through a long video synthesis pipeline: first, filter the visual quality, semantic content and temporal coherence of candidate long videos; then, split the videos into manageable temporal segments, and conduct annotation and quality inspection for each segment; finally, assemble the validated segment descriptions into full-video supervision signals. Leveraging this evidence recording mechanism, the pipeline generates long video subtitles, long video question-answering (QA) data and temporal annotations. The data is provided in the form of JSONL annotation files. Most raw videos are not stored redundantly, but SciVideo videos are already included in the repository, while videos from other sources need to be parsed from the original dataset. The data sources include CinePile, LongVideoDB, SciVideo_Long and SciVideo_Short datasets.
提供机构:
MCG-NJU
搜集汇总
数据集介绍
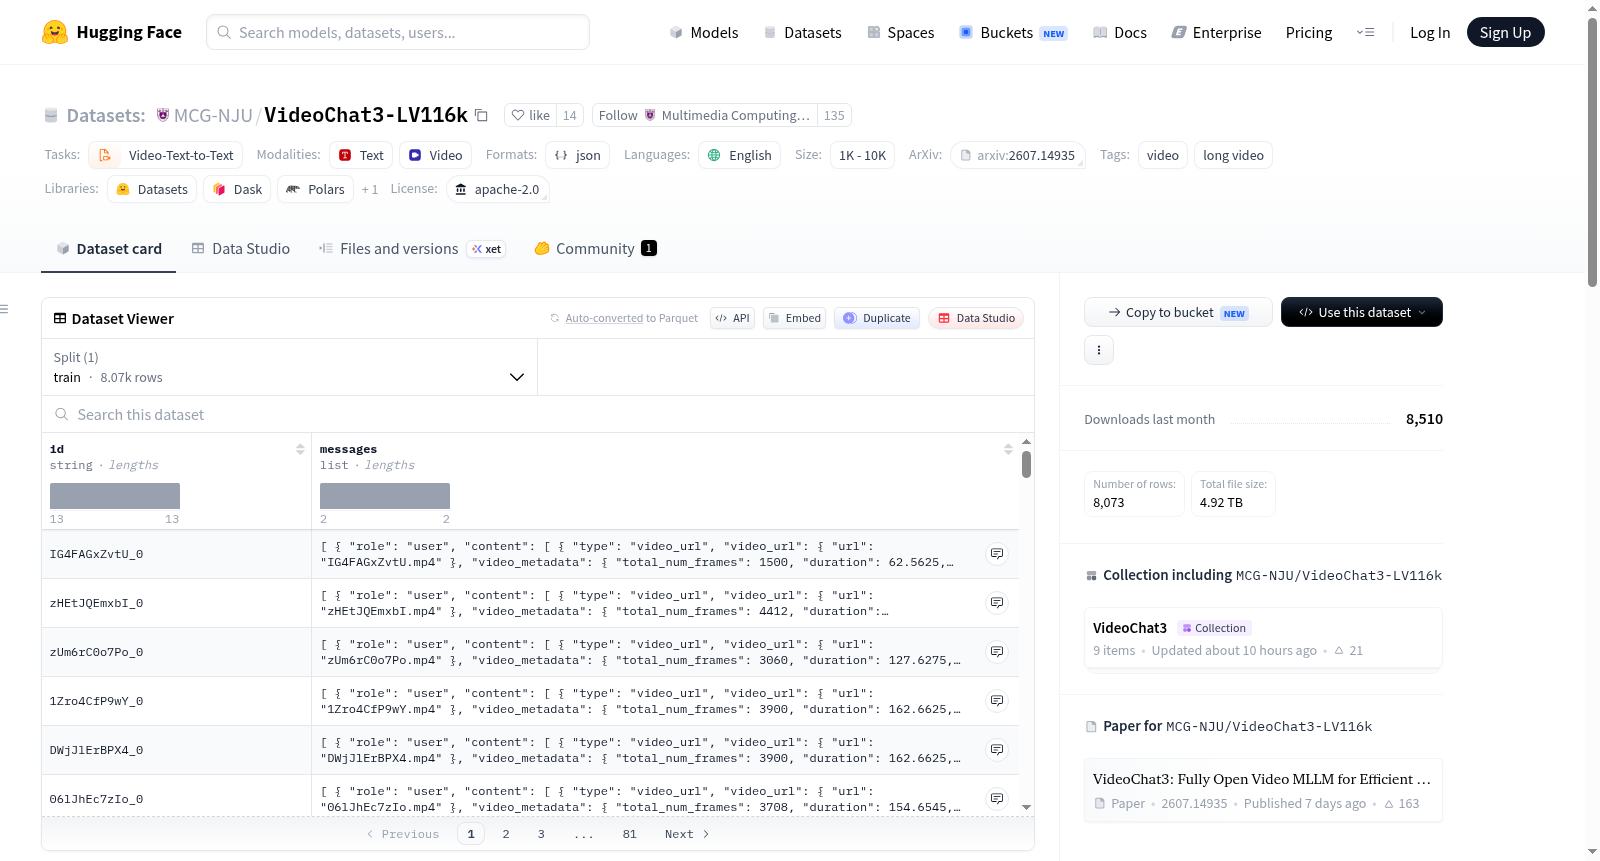
MCG-NJU/VideoChat3-LV116k 数据集图片
构建方式
VideoChat3-LV116k是专为增强多模态大语言模型对长视频理解能力而构建的高质量指令数据集。其构建依托一套精心设计的长视频合成流水线,首先从CinePile、LongVideoDB及自收集的SciVideo等多个来源中,筛选出视觉质量高、语义丰富且时序连贯的候选长视频。随后,将视频切分为可管理的时域片段,独立标注并审验每一片段质量,最终将验证有效的片段描述整合为完整的视频级监督信号。基于此证据账本,该流水线进一步生成长视频描述、长视频问答数据以及时序定位标注,形成覆盖多维度理解的116k条指令对。
特点
该数据集的显著特色在于对长时域上下文的深度建模,弥补了传统学术数据集偏重短视频理解的不足。其数据涵盖电影总结与问答、长视频时间线定位以及科学视频理解等多种类型,证据分布稀疏、延迟且跨片段,极大考验模型的长程时序建模能力。数据集严格验证各阶段质量,同步提供完整的标注映射文件lv116k.json,便于研究者追溯各样本的原始视频来源及组织方式。此外,大部分原始视频以独立仓库形式重新上传,保障数据可复现性,同时维持来源数据集的知识产权归属。
使用方法
数据集以JSONL格式提供标注文件,用户可通过lv116k.json映射文件关联标注与对应视频源。CinePile与LongVideoDB来源的视频需从原作者处解析,而SciVideo_Long与SciVideo_Short视频则直接释出于本仓库。使用者可将视频文件与标注JSONL按结构存放,便于加载至视频-文本多模态框架中。推荐搭配VideoChat3模型及论文中阐述的长视频理解流水线进行训练与评测,以充分发挥其在长时域问答与定位任务上的效用。
背景与挑战
背景概述
VideoChat3-LV116K是由南京大学多媒体计算组(MCG-NJU)联合多位研究者于2026年发布的大规模长视频指令数据集,旨在应对现有视频多模态大语言模型(Video MLLM)在长时程语义理解上的局限。该数据集围绕“长视频证据稀疏、延迟且跨片段分布”这一核心研究问题,通过整合CinePile、LongVideoDB及自收集的SciVideo等资源,构建了涵盖摘要、问答与时间定位的全面标注体系。其诞生填补了长视频监督数据的空白,为发展可高效处理长时间依赖的视频理解模型奠定了关键数据基础,对推动通用视频人工智能研究具有重要影响力。
当前挑战
该数据集所解决的领域挑战主要在于长视频理解中的时间证据稀疏性与语义延展性,传统短片段模型难以有效捕捉跨多段落的关联信息。构建过程中面临的挑战包括:从异构视频源中筛选出具有视觉质量、内容连贯性及语义多样性的候选长视频;设计合理的时间分段策略以确保每个片段可被精准标注,同时维持整体叙事结构的完整性;建立质量验证机制以剔除低质量描述,并最终将分散的片段证据整合为统一的视频监督信号,实现长视频字幕、问答及时序定位的高效合成。
常用场景
经典使用场景
VideoChat3-LV116k数据集专为长视频理解任务而构建,其经典用途集中在训练和评估能够处理跨时序稀疏、延迟及分布式证据的多模态大语言模型。该数据集通过长视频合成流水线,将高质量视频分割为可管理的时序片段,并整合片段级标注为完整的视频监督信号,从而支持长视频字幕生成、长视频问答以及时序定位等核心任务。研究者常将其作为补充学术短视频数据的关键资源,以增强模型对较长时间上下文的感知与推理能力。
实际应用
在实际应用中,VideoChat3-LV116k数据集赋能了多种需要长视频深度理解的场景。例如,在电影摘要与问答领域,模型可依托该数据学习从数十分钟影片中提取核心情节、人物关系和事件脉络,辅助影视内容分析或自动生成影评。在科学视频(SciVideo)处理中,它支持对长时实验记录或教学讲解的自动摘要与关键步骤定位,助力科研资料归档与知识抽取。此外,安防监控中的长序列事件检测、会议记录摘要等场景也可受益于其提供的时序推理训练范式。
衍生相关工作
该数据集已衍生出多项经典研究工作,最核心的是其所属的VideoChat3项目,后者是一个完全开源的多模态大语言模型框架,旨在实现高效且通用的视频理解。基于VideoChat3-LV116k,研究者进一步探索了长视频中的时序基础模型训练策略,并产出了多种视频问答与定位基准的改进方法。此外,该数据集所采用的合成流水线设计思路,被后续工作借鉴用于构建跨领域的长视频标注集,如电影、纪录片和科学演讲等视频类型的多任务学习数据,推动了视频理解领域数据生成范式的标准化与规模化。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

