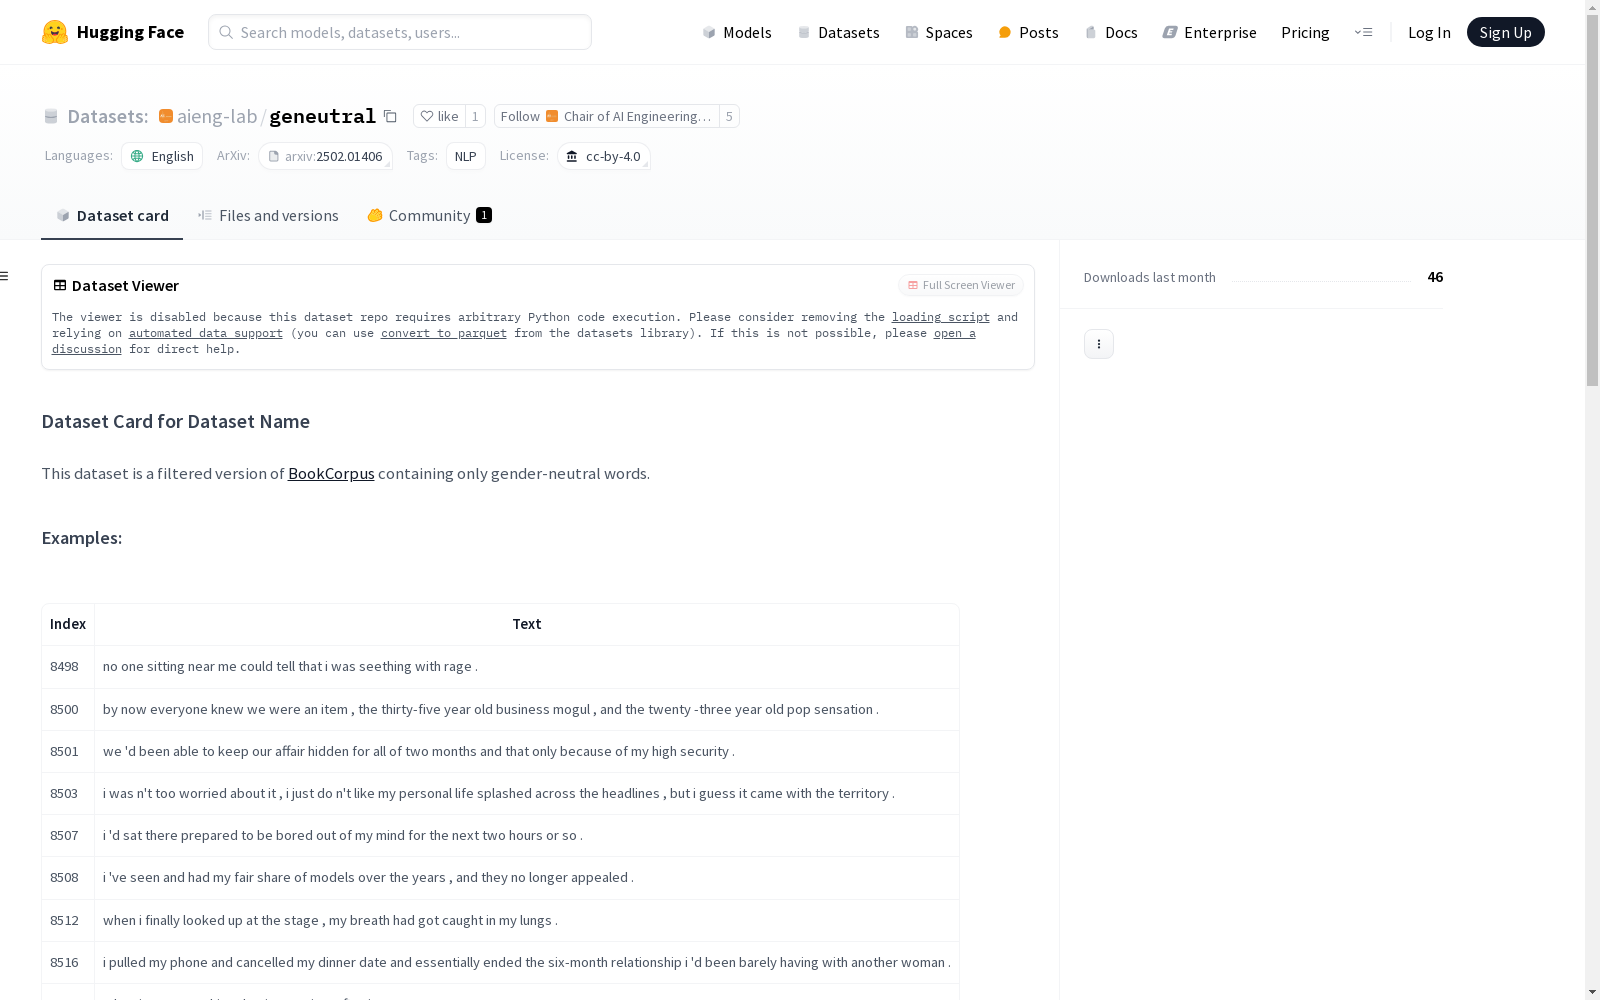
geneutral
收藏资源简介:
该数据集是BookCorpus的过滤版本,仅包含性别中立的词汇。它适用于训练和评估语言模型,特别是在评估性别偏见和性别中立模型在掩码语言建模(MLM)任务中的表现时。数据集的创建过程包括从BookCorpus数据集中过滤出满足特定条件的条目,如每个条目至少包含50个字符,不包含特定性别代词和名词等。
This dataset is a filtered version of the BookCorpus corpus, containing only gender-neutral vocabulary. It is suitable for training and evaluating language models, particularly for assessing gender bias and the performance of gender-neutral models in Masked Language Modeling (MLM) tasks. The dataset was developed by filtering eligible entries from the original BookCorpus dataset, with specific criteria including each entry containing at least 50 characters and excluding specific gender pronouns and nouns.
数据集概述
数据集基本信息
- 数据集名称: aieng-lab/geneutral
- 语言: 英文
- 数据集特征:
- 特征名称:text
- 数据类型:字符串
- 数据划分:
- 训练集
- 字节大小:722,953,083 bytes
- 示例数量:7,896,455
- 训练集
- 下载大小: 462,066,705 bytes
- 数据集大小: 722,953,083 bytes
- 配置:
- 配置名称:default
- 数据文件路径:data/train-*
- 标签: NLP
- 许可证: cc-by-4.0
数据集详细信息
- 存储库: github.com/aieng-lab/gradiend
- 论文:

- 原始数据: BookCorpus
使用场景
- 适用于训练和评估语言模型,特别是在性别偏见和性别中性模型中进行掩码语言建模(MLM)任务。
数据集创建
- 通过过滤BookCorpus数据集创建,仅保留满足以下条件的条目:
- 每个条目至少包含50个字符
- 不包含aieng-lab/namextend中的名称
- 不包含性别特定的代词(如he/she/him/her/his/hers/himself/herself)
- 不包含根据gendered-word dataset中的2421个复数扩展条目所定义的性别特定名词
引用
-
BibTeX:
@misc{drechsel2025gradiendmonosemanticfeaturelearning, title={{GRADIEND}: Monosemantic Feature Learning within Neural Networks Applied to Gender Debiasing of Transformer Models}, author={Jonathan Drechsel and Steffen Herbold}, year={2025}, eprint={2502.01406}, archivePrefix={arXiv}, primaryClass={cs.LG}, url={https://arxiv.org/abs/2502.01406}, }