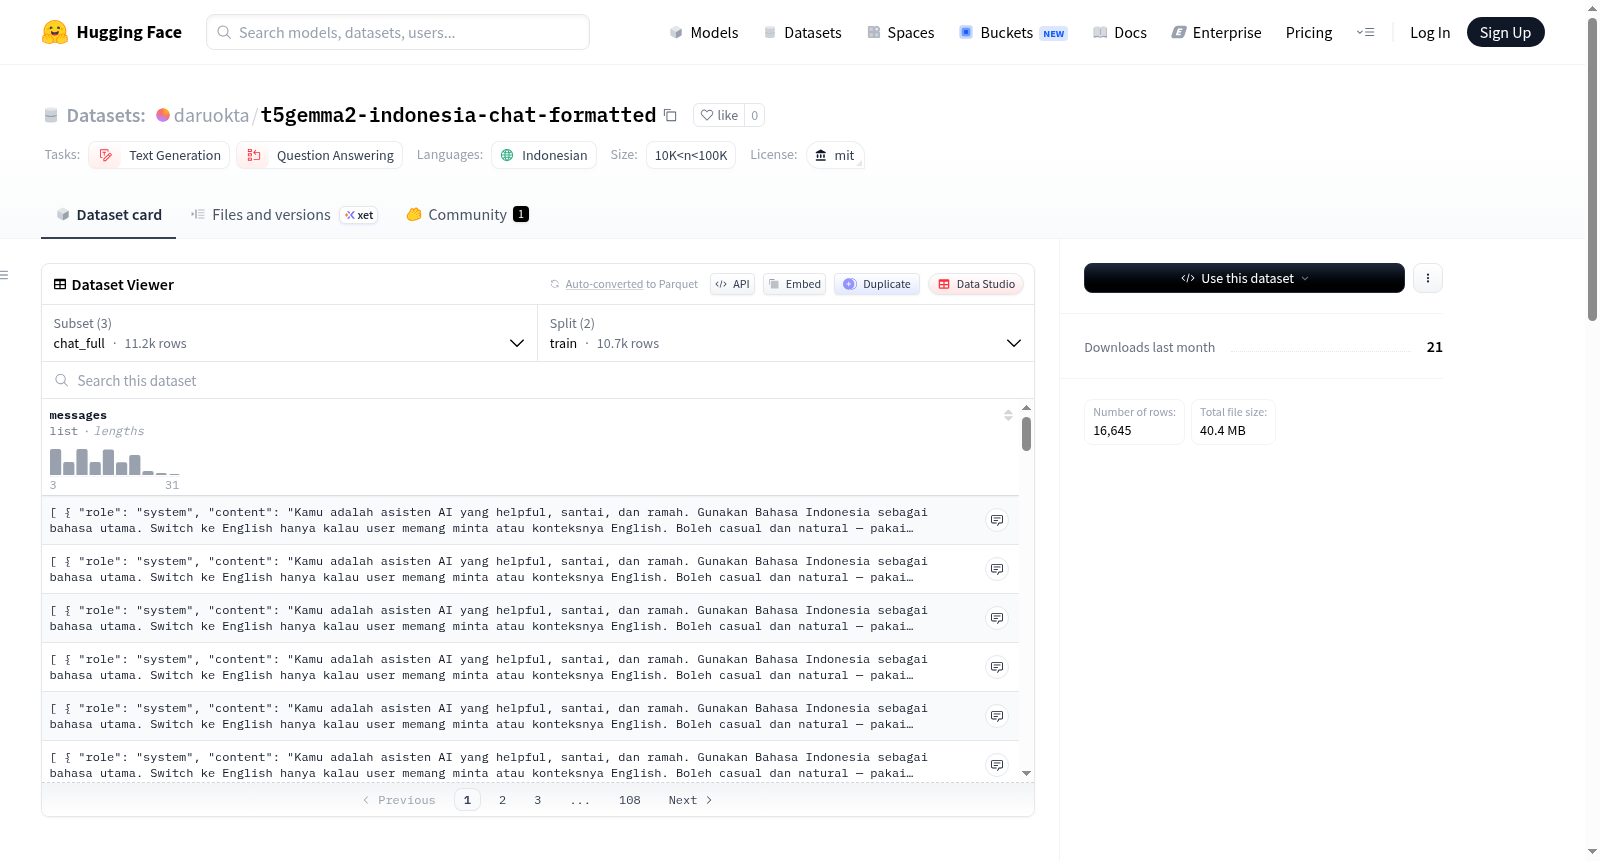
t5gemma2-indonesia-chat-formatted
收藏资源简介:
T5Gemma-2 印尼语聊天与问答数据集是一个高质量的印尼语多轮对话和阅读理解数据集,专门为序列到序列(Seq2Seq)模型(如 T5-Gemma / T5-Gemma-2)的指令调优而设计。数据集包含超过 15,000 个多轮对话和基于文档的问答,涵盖日常生活、技术、常识和结构化文档分析等多样化主题。数据集已预先格式化为标准的 OpenAI/ChatML 消息列表,可直接用于微调。数据集结构分为三个子集:1. `chat_seed`:包含 1,030 个手动整理的多轮对话种子数据;2. `chat_full`:包含约 10,000 个扩展的多轮非正式和正式对话;3. `indoqa_documents`:包含约 4,000 个基于印尼语文档的阅读理解和事实问答示例。每个条目包含一个名为 `messages` 的列,其中是一个消息对象列表(`role` 和 `content` 字段)。数据集总样本量约为 15,000 个,语言为印尼语(Bahasa Indonesia),格式为标准 ChatML 字典列表(`role` 和 `content`),创建于 2026 年 5 月。
The T5Gemma-2 Indonesian Chat and QA Dataset is a high-quality Indonesian-language multi-turn dialogue and reading comprehension dataset specifically designed for instruction tuning of sequence-to-sequence (Seq2Seq) models such as T5-Gemma / T5-Gemma-2. The dataset contains over 15,000 multi-turn dialogues and document-based question answering (QA) samples, covering diverse topics including daily life, technology, common sense, and structured document analysis. The dataset has been pre-formatted as standard OpenAI/ChatML message lists and can be directly used for fine-tuning. The dataset is structured into three subsets: 1. `chat_seed`: Contains 1,030 manually curated multi-turn dialogue seed data; 2. `chat_full`: Contains approximately 10,000 expanded multi-turn informal and formal dialogues; 3. `indoqa_documents`: Contains approximately 4,000 reading comprehension and factual QA examples based on Indonesian-language documents. Each entry includes a column named `messages`, which is a list of message objects with `role` and `content` fields. The dataset has a total of approximately 15,000 samples, in Bahasa Indonesia, formatted as standard ChatML dictionary lists with `role` and `content` fields, and was created in May 2026.
数据集概述:T5Gemma-2 Indonesian Chat & QA Dataset
该数据集是一个高质量的印尼语多轮对话与阅读理解数据集,专为序列到序列(Seq2Seq)模型的指令微调而设计,例如 T5-Gemma 和 T5-Gemma-2。
数据集信息
- 语言:印尼语(Bahasa Indonesia)
- 许可证:MIT
- 任务类别:文本生成、问答
- 数据集大小:10,000 < n < 100,000
- 总样本数:约 15,000 条
- 创建时间:2026年5月
数据集结构
数据集分为三个不同的子集:
chat_seed:原始的 1,030 条人工精心策划的多轮对话种子数据。chat_full:约 10,000 条经过增强的多轮日常及正式对话数据。indoqa_documents:约 4,000 条基于印尼语文档的阅读理解与事实性问答示例。
每条数据包含一个名为 messages 的列,该列是一个消息对象列表,包含以下字段:
role:说话者角色(system、user或assistant)。content:对话的实际文本。
数据划分
chat_full:训练集(chat_full/train-*)和验证集(chat_full/validation-*)chat_seed:仅训练集(chat_seed/train-*)indoqa_documents:训练集(indoqa_documents/train-*)和验证集(indoqa_documents/validation-*)
数据格式
数据采用标准的 ChatML 格式,即字典列表(role 和 content),可直接用于微调。加载示例(需使用 Hugging Face datasets 库):
python
from datasets import load_dataset
加载完整对话数据集
ds_chat = load_dataset("daruokta/t5gemma2-indonesia-chat-formatted", "chat_full")
加载 IndoQA 阅读理解数据集
ds_qa = load_dataset("daruokta/t5gemma2-indonesia-chat-formatted", "indoqa_documents")