
遇见数据集

hf-audio/open-asr-leaderboard

收藏
Hugging Face2026-06-26 更新2026-04-05 收录
官方服务:

资源简介:

该数据集是ESB(开放ASR排行榜)测试集的排序和Parquet格式版本,源自open-asr-leaderboard/datasets-test-only数据集。它包含九个配置:ami、common_voice、earnings22、gigaspeech、librispeech、spgispeech、tedlium、voxpopuli和voxpopuli_cleaned_aa,每个配置都按音频长度排序,并将数据格式从自定义加载脚本转换为安全的Parquet格式。数据集用于自动语音识别(ASR)系统的评估,每个数据点包括音频(采样率16kHz)、转录文本、唯一ID、数据集名称和音频长度(秒)。音频已分段适合训练,转录经过纠错处理(如去除垃圾标记、转换标点符号)。测试集的转录未提供,需通过Hugging Face空间提交预测结果进行评分。所有数据集可自由访问,但Common Voice、GigaSpeech和SPGISpeech需同意特定使用条款。数据集还附带一个8小时的诊断数据集,用于跨域验证。ESB数据集涵盖多种领域(如有声书、会议、TED演讲)和说话风格(如叙述、即兴),总训练时长从78小时到4900小时不等。

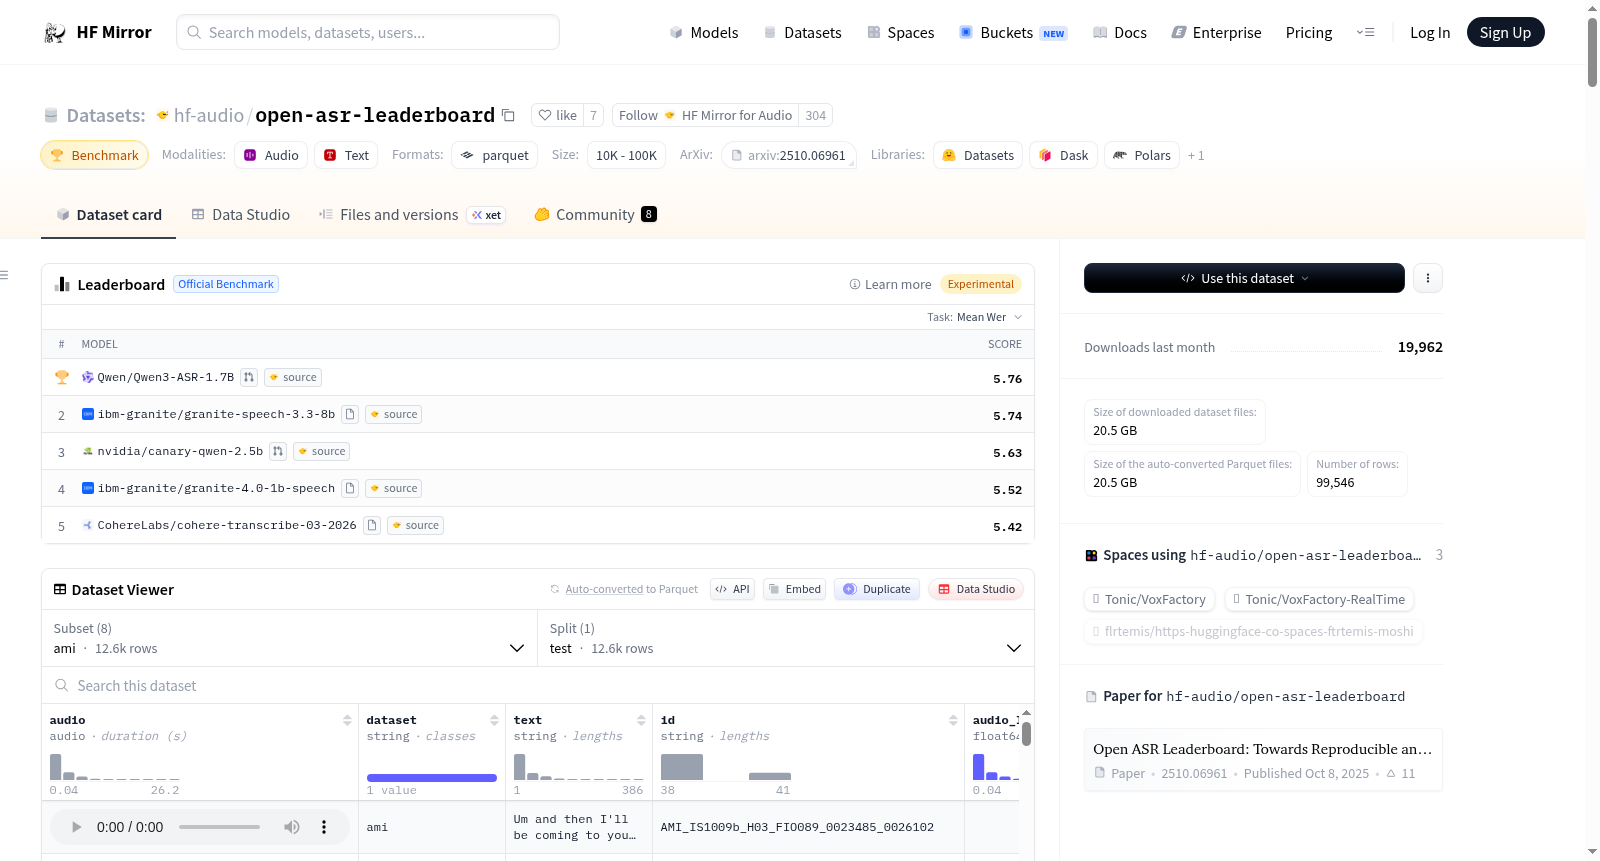
This dataset is a sorted, Parquet-formatted version of the ESB (Open ASR Leaderboard) test set, derived from the open-asr-leaderboard/datasets-test-only dataset. It consists of nine configurations: ami, common_voice, earnings22, gigaspeech, librispeech, spgispeech, tedlium, voxpopuli, and voxpopuli_cleaned_aa. Each configuration is sorted by audio length, with the data format converted from custom loading scripts to secure Parquet format. This dataset is designed for evaluating automatic speech recognition (ASR) systems. Each data point includes audio with a 16kHz sampling rate, transcript text, unique ID, dataset name, and audio length measured in seconds. Audio segments are optimized for training, and transcripts have been post-processed with corrections such as removing garbage markers and standardizing punctuation marks. Transcripts for the test set are not publicly provided; predictions must be submitted via Hugging Face Spaces for official scoring. All datasets are freely accessible, but Common Voice, GigaSpeech, and SPGISpeech require users to agree to specific terms of use. Additionally, the dataset package includes an 8-hour diagnostic dataset for cross-domain validation. The ESB dataset covers diverse domains including audiobooks, meetings, TED talks, and various speaking styles such as narration and impromptu speech, with total training durations ranging from 78 hours to 4900 hours across different configurations.
提供机构:
hf-audio
搜集汇总
数据集介绍
hf-audio/open-asr-leaderboard 数据集图片
构建方式
在自动语音识别领域,构建一个全面且标准化的评估基准对于推动技术进步至关重要。open-asr-leaderboard数据集通过整合八个广泛使用的公开语音识别测试集,包括LibriSpeech、Common Voice、VoxPopuli等,形成了一个统一的评估框架。其构建过程采用了系统化的数据整理方法,从原始数据源加载各子集后,统一将音频采样率标准化为16kHz,并计算每条音频的时长信息。随后,数据按照音频长度进行降序排列,并将存储格式转换为更安全、高效的Parquet格式,确保了数据加载的便捷性与处理过程的可复现性。
特点
该数据集的核心特征在于其高度的集成性与多样性,涵盖了从有声读物、会议录音到公开演讲、播客等多种语音领域和说话风格,为评估模型在不同场景下的鲁棒性提供了丰富素材。所有音频数据均经过预处理,分割为适合模型训练的片段,并配有经过纠错处理的文本转录,确保了数据质量的统一性。数据集结构设计清晰,每个样本均包含音频路径、波形数组、转录文本、唯一标识符及所属子集名称,便于研究者进行精确的索引与调用。
使用方法
使用该数据集进行模型评估或训练时,研究者可通过Hugging Face Datasets库以简洁的代码行加载任意子集,例如调用`load_dataset("esb/datasets", "librispeech", split="test")`即可获取LibriSpeech的测试数据。加载后的数据对象可直接用于训练或评估脚本,音频文件在访问时自动解码并重采样至指定频率。需要注意的是,对于测试集,转录文本不予提供,研究者需将模型预测结果提交至指定平台进行自动化评分。部分子集如Common Voice、GigaSpeech等在使用前需遵循其特定许可协议,完成相应的访问授权流程。
背景与挑战
背景概述
在自动语音识别(ASR)领域,构建标准化、可复现的评估基准是推动技术进步的关键。Open ASR Leaderboard数据集由Hugging Face社区的研究人员于2025年创建,旨在整合多个权威语音数据集,形成一个统一的、透明的多领域ASR评估平台。该数据集汇集了LibriSpeech、Common Voice、GigaSpeech等八个核心数据集,覆盖了从有声读物、播客到会议录音等多种语音领域和说话风格。其核心研究问题在于解决以往ASR评估中存在的领域偏差、评估标准不一致以及结果难以复现的难题,为研究人员提供了一个全面、公平的性能比较框架,显著提升了ASR系统评估的科学性与可靠性。
当前挑战
该数据集致力于解决自动语音识别领域内模型泛化能力评估的挑战,其核心在于如何设计一个能够公平、全面衡量ASR系统在不同领域(如朗读、自发性对话、演讲)和不同声学条件下性能的基准。具体挑战包括:处理来自八个独立数据集的语音在录音质量、说话人背景、文本规范(如标点符号处理、大小写)方面的巨大异质性;确保评估过程的可复现性与透明度,避免因数据预处理或评估流程的差异导致结果偏差。在构建过程中,挑战主要集中于数据整合与标准化,例如将不同格式的原始音频统一转换为16kHz采样率,对转录文本进行一致的错误校正与规范化处理,同时需严格遵守各源数据集复杂的许可协议与使用条款,确保数据分发的合法合规性。
常用场景
经典使用场景
在自动语音识别领域,open-asr-leaderboard数据集作为标准化评估基准,其经典使用场景在于为各类ASR模型提供统一、全面的性能测试平台。该数据集整合了八个不同领域和风格的语音测试集,涵盖从朗读式有声书到自发式会议讨论的多样化语音样本,研究人员能够通过单一接口加载这些数据,便捷地评估模型在多种真实场景下的识别准确率与鲁棒性。这种集成化设计极大简化了跨领域语音识别系统的对比实验流程。
衍生相关工作
围绕该数据集已衍生出多项经典研究工作,特别是基于其构建的开放ASR排行榜(Open ASR Leaderboard)本身已成为领域内重要的成果展示与比较平台。相关研究通过利用该数据集的多领域测试集,深入探索了端到端语音识别模型的领域自适应、少样本学习以及长语音处理等前沿课题。此外,数据集的标准格式也促进了诸如Whisper、Wav2Vec 2.0等主流开源模型在其上的系统性评估与性能基准的建立,推动了整个语音识别社区向更透明、可比较的方向发展。
数据集最近研究
最新研究方向
在自动语音识别领域,open-asr-leaderboard数据集作为标准化评估基准,正推动着多领域、多风格语音识别技术的前沿探索。该数据集整合了LibriSpeech、Common Voice、GigaSpeech等八个涵盖有声读物、会议、演讲等多样化场景的测试集,为模型在复杂声学环境与多口音条件下的鲁棒性提供了统一度量。当前研究热点聚焦于利用该基准进行跨领域自适应学习、长序列语音处理以及低资源场景下的泛化能力评估,特别是在金融会议、自发对话等专业领域,其标准化测试流程显著提升了研究成果的可比性与可复现性,加速了端到端语音识别模型向实用化迈进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

