tri-fraud-alerts-india
收藏资源简介:
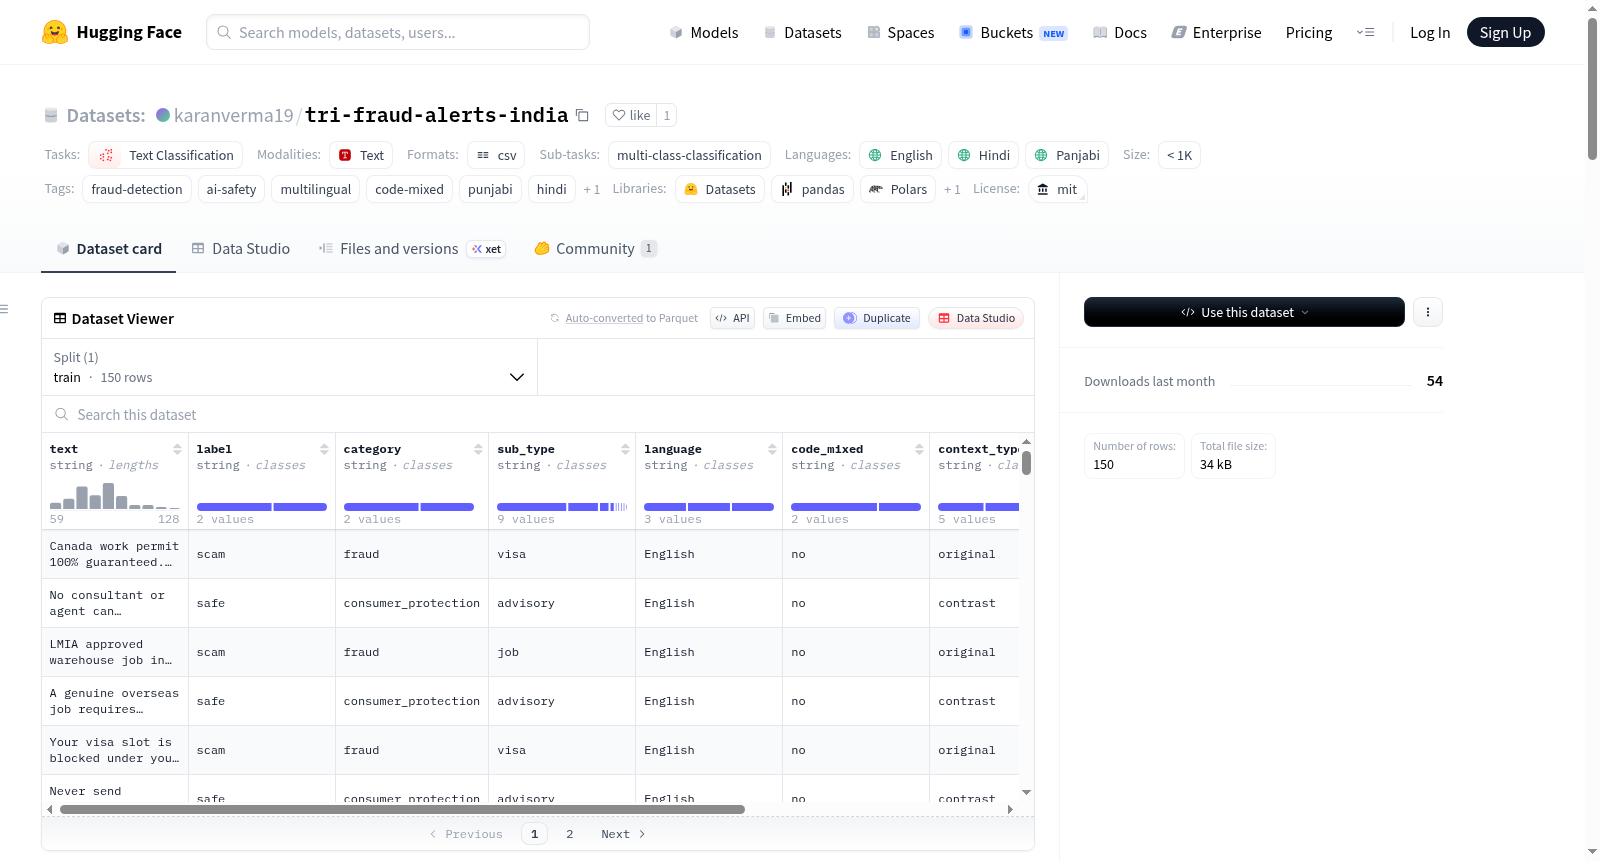
该数据集是一个三语种(旁遮普语-印地语-英语)的欺诈与消费者保护数据集,专为印度旁遮普等地区的欺诈检测任务设计。数据集包含旁遮普语、印地语和英语的文本,许多样本为这些语言的混合使用(code-mixed)。其独特之处在于通过对比示例、负样本空间和边缘案例,帮助模型更好地区分欺诈与安全信息。数据集结构包括文本、标签(诈骗/安全)、类别(欺诈/消费者保护)、子类型(签证、工作、OTP等)、语言、是否混合语言、上下文类型(原始/对比/负样本/边缘案例)、推理标签和难度等级。关键观察发现,许多欺诈信息依赖于紧迫性、权威声称和保证结果等信号。数据集的局限性在于其为合成数据,且主要关注移民相关欺诈模式。最新版本(v2)着重提升决策边界和语言混合的真实性,而非扩大数据规模。
This dataset is a trilingual (Punjabi-Hindi-English) fraud and consumer protection dataset, specifically tailored for fraud detection tasks in regions including Punjab, India. The dataset contains texts in Punjabi, Hindi, and English, with a large number of samples being code-mixed across these languages. Its unique design helps models better distinguish between fraudulent and legitimate information via contrastive examples, negative sample spaces, and edge cases. The dataset structure includes text, label (fraudulent/legitimate), category (fraud/consumer protection), sub-type (visa, job, OTP, etc.), language, code-mixing status, context type (original/contrastive/negative sample/edge case), inference label, and difficulty level. Key observations indicate that many fraudulent messages rely on signals such as urgency, authority claims, and guaranteed outcomes. The limitations of this dataset are that it consists of synthetic data and primarily focuses on immigration-related fraud patterns. The latest version (v2) prioritizes improving the authenticity of decision boundaries and code-mixed language over expanding the dataset size.
数据集概述
数据集基本信息
- 数据集名称:Trilingual (Punjabi–Hindi–English) Fraud & Consumer Protection Dataset
- 数据集标识:karanverma19/tri-fraud-alerts-india
- 许可证:MIT
- 支持的语言:英语 (en)、印地语 (hi)、旁遮普语 (pa)
- 任务类别:文本分类
- 具体任务:多类别分类
- 标签:欺诈检测、AI安全、多语言、语码混合、旁遮普语、印地语、英语
数据集目标与特点
- 目标:解决印度旁遮普等地区欺诈检测的复杂性,这些地区的消息通常使用旁遮普语、印地语或两种语言混合,而非标准英语。
- 核心特点:
- 包含对比性示例:成对出现看似相似但意图不同的消息,旨在帮助模型理解“为何”是诈骗,而非仅识别“什么”像诈骗。
- 包含负样本:包含正常、安全通信的示例,以防止系统过度标记。
- 包含边缘案例:包含意图不明显、语言微妙的边界案例,以贴近真实场景。
- 反映真实语言使用:大量数据包含旁遮普语-印地语-英语的语码混合,体现了印度北部的实际交流方式。
数据集结构
数据集中每条记录包含以下字段:
text:文本内容label:标签(scam / safe)category:类别(fraud / consumer_protection)sub_type:子类型(visa, job, otp等)language:语言code_mixed:是否为语码混合context_type:上下文类型(original / contrast / negative / edge_case)reasoning_tag:推理标签difficulty:难度
关键观察
- 数据集中的许多欺诈消息依赖于以下信号:
- 紧急性(如“立即行动”)
- 权威性声明(如“使馆关系”)
- 保证性结果(如“100%签证”)
- 这些信号通常嵌入在语码混合的语言中,增加了检测难度。
开发与迭代
- 初始版本问题:模式重复、诈骗信号过于明显、安全示例有限。
- 改进措施:
- 跨类别添加对比对。
- 包含中性及建议性消息。
- 引入紧急性、权威性、保证性结果等推理标签。
- 改进旁遮普语和印地语-英语混合的措辞,使其更自然。
- 当前迭代重点:未增加数据集大小,重点在于提升模型区分诈骗与安全消息的清晰度。
- 添加了更多意图不明显的微妙边缘案例。
- 扩展了社会认同和虚假权威等推理模式。
- 改善了旁遮普语-印地语混合措辞的自然度。
- 使诈骗与安全消息之间的对比更清晰。
- 质量评估:经过Adaptive Data评估,等级从E提升至A,质量分数从2.0提升至9.8(约390%的改进)。
局限性
- 数据集是合成的,并非来自真实用户日志。
- 可能未涵盖所有地区方言变体。
- 主要关注移民及相关欺诈模式。
伦理说明
- 所有样本均基于公开报告的欺诈案例中观察到的模式合成生成。
- 不包含任何个人或敏感数据。