tibbi-makaleler-rag-veritabani
收藏资源简介:
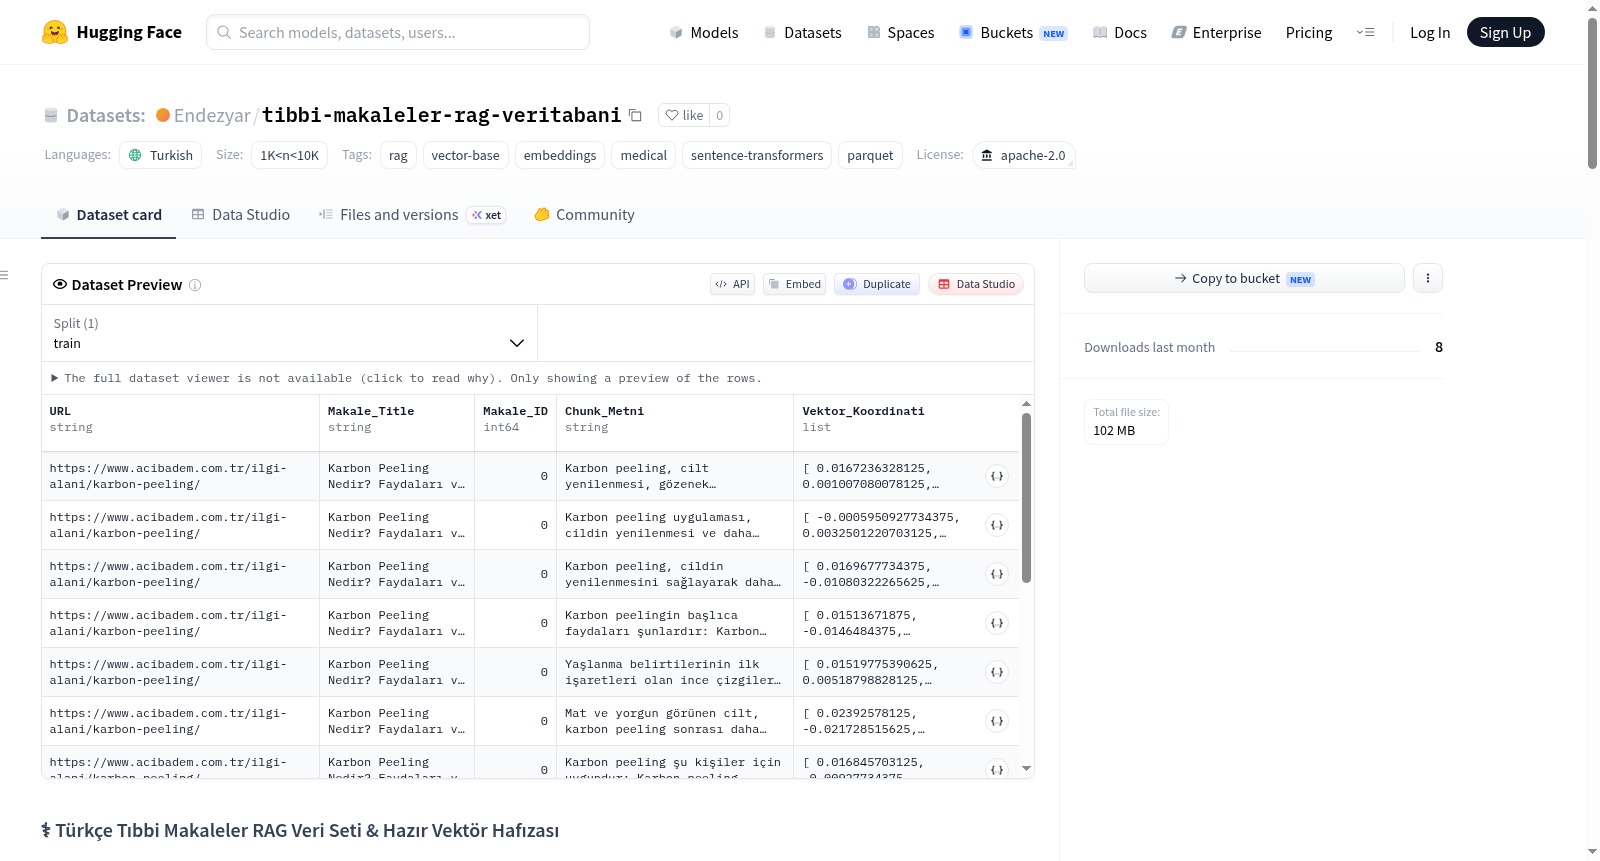
该数据集是土耳其语医学文章的RAG(检索增强生成)数据集,包含预处理后的文本数据以及预构建的向量数据库。数据来源于土耳其语医学文章,经过清洗、字段裁剪(保留url、title、text)、智能文本分块(递归字符分块,块大小1500字符,重叠300字符)和向量化(使用magibu/embeddingmagibu-200m模型生成768维嵌入向量)。数据集规模在1000到10000条样本之间,以Parquet格式存储,可通过Hugging Face Datasets库加载。此外,还提供了预构建的ChromaDB向量数据库(HNSW索引,支持余弦和L2距离),以及包含文本块和对应向量坐标的Parquet/CSV文件。该数据集专为土耳其语医学领域的语义搜索、问答系统和RAG应用设计,可直接用于检索增强生成流水线,无需额外计算嵌入。
This dataset is a RAG (Retrieval-Augmented Generation) dataset for Turkish medical articles, containing preprocessed textual data and pre-built vector database. The data originates from Turkish medical articles, undergoing cleaning, field trimming (retaining url, title, text), intelligent text chunking (recursive character chunking, chunk size 1500 characters, overlap 300 characters), and vectorization (using magibu/embeddingmagibu-200m model to generate 768-dimensional embedding vectors). The dataset size ranges from 1000 to 10000 samples, stored in Parquet format, and can be loaded via Hugging Face Datasets library. Additionally, it provides a pre-built ChromaDB vector database (HNSW index, supporting cosine and L2 distances), as well as Parquet/CSV files containing text chunks and corresponding vector coordinates. This dataset is specifically designed for semantic search, question answering systems, and RAG applications in the Turkish medical domain, allowing direct use in retrieval-augmented generation pipelines without additional embedding computation.
土耳其语医学文章RAG数据集与预构建向量数据库
项目概述
该数据集是Magibu应用人工智能架构培训框架下开发的一个端到端数据工程项目,旨在将土耳其语医学文章完全适配于RAG(检索增强生成)架构和向量空间搜索。核心目标不仅是存储原始医学文本,还包括将文本进行语义分块、转换为768维向量坐标,并提供可供毫秒级搜索的预构建ChromaDB向量数据库。
技术架构与处理流程
系统架构包含5个主要步骤:
- 原始数据集
- 清洗与列裁剪(仅保留url、title、text列)
- 智能文本分块(基于字符的递归切分)
- 向量转换(使用magibu/embeddingmagibu-200m模型,768维)
- 向量数据库索引(ChromaDB HNSW / L2距离)
关键技术细节
| 技术组件 | 具体实现 |
|---|---|
| 嵌入模型 | magibu/embeddingmagibu-200m(768维语义空间) |
| 文本分块 | 使用LangChain RecursiveCharacterTextSplitter,块大小1500字符,重叠300字符,保留段落、句子和单词边界以保障语义完整性 |
| 向量数据库 | ChromaDB(PersistentClient模式,SQLite/HNSW索引) |
| 搜索算法 | 近似最近邻(ANN)/ 余弦与L2距离 |
| 数据存储格式 | Parquet(列式存储,高压缩与快速I/O),使用train分割结构的DatasetDict |
| 阈值设定 | 距离阈值设为1,当最近邻距离超过1时系统发出警告;若前5个结果中部分低于阈值,仅返回低于1的结果 |
相关GitHub链接
- RAG模块创建:Rag_Modolü_Oluşturma.ipynb
- RAG模块使用:Rag_Modülü_Kullanma.ipynb
仓库内容与文件结构
该数据仓库提供3种主要格式以满足不同使用场景:
| 文件/结构 | 格式 | 描述 |
|---|---|---|
data/(HF数据集) |
.parquet |
可通过datasets.load_dataset()直接加载的干净、裁剪后的原始数据集(含train分割) |
vektor_veritabanim.zip |
.zip |
包含预计算的768维向量的预构建ChromaDB数据库文件夹 |
tibbi_makaleler_vektorlu |
.parquet / .csv |
文本块(chunks)及其对应的768维向量坐标列表 |
向量数据库与ANN的优势
传统数据库执行单词匹配(类似CTRL+F),而此仓库中的向量数据库衡量语义相似性。例如,搜索"Kanser"时,即使句子中不包含该词,也能通过向量空间中的距离相似性立即找到包含"tümör"(肿瘤)或"onkoolojik tedavi"(肿瘤治疗)的句子。暴力搜索的每次查询复杂度为O(N),而通过ChromaDB的ANN索引,即使在1000万文档中搜索时间也能保持在毫秒级别。
可复现性
为保证数据选择和抽样过程中伪随机生成器的稳定性,使用了seed=42参数。即使在不同环境中重新运行,也能获得完全相同的样本和向量排列。
数据集元数据
- 许可证:Apache-2.0
- 语言:土耳其语(tr)
- 规模:1K < n < 10K
- 标签:RAG、向量数据库、嵌入、医学、sentence-transformers、Parquet格式