
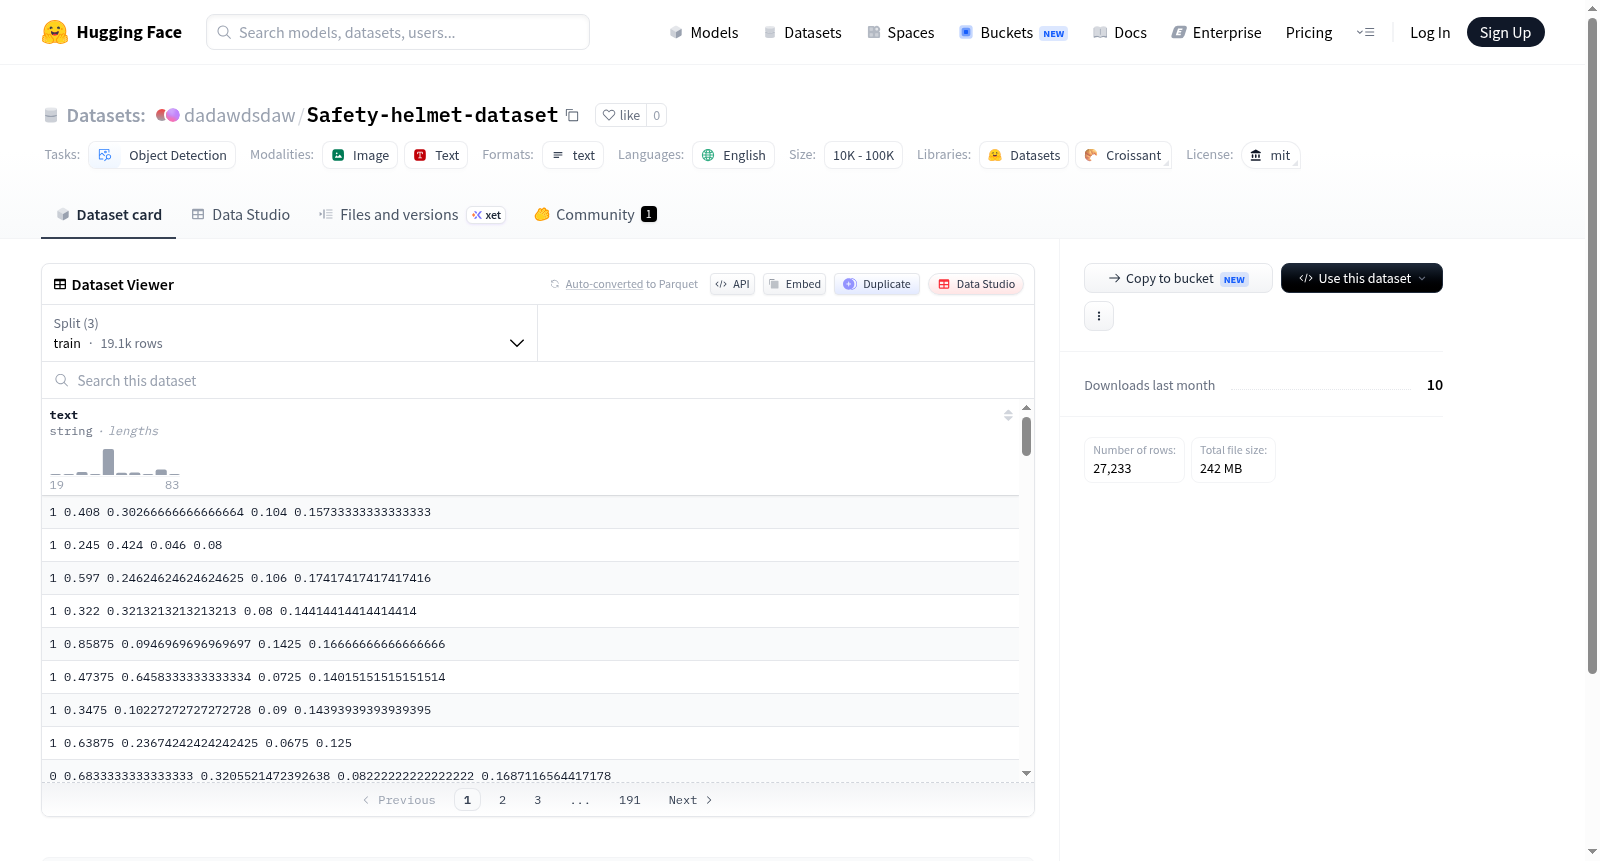
dadawdsdaw/Safety-helmet-dataset
收藏搜集汇总
数据集介绍
构建方式
Safety-helmet-dataset是一个面向目标检测任务的英文数据集,旨在支持建筑工地等场景中安全头盔的自动识别。该数据集采用MIT开源协议,便于研究者和开发者自由使用与分发。其构建过程通常涉及从真实监控视频或公开图像中采集包含佩戴与未佩戴安全头盔的样本,随后通过人工标注工具对图像中的头盔区域进行精确的边界框标注,形成标准的目标检测格式。数据集的构建注重场景多样性与光照条件的覆盖,以增强模型的泛化能力。
特点
该数据集的核心特点在于聚焦工业安全这一垂直领域,为安全帽检测提供了专精化的训练数据。其标注规范统一,所有图像均经过人工校验,确保了标签的准确性。数据集兼具规模与平衡性,在正负样本(佩戴与未佩戴头盔)分配上力求均衡,避免模型产生分类偏倚。此外,图像来源涵盖多角度、多距离的拍摄条件,有助于提升检测算法在实际作业环境中的鲁棒性。
使用方法
使用该数据集时,推荐采用标准的目标检测框架进行模型训练与评估。用户可将数据集划分为训练集、验证集和测试集,并加载图像及其对应的XML或JSON格式的标注文件。数据集兼容主流深度学习工具如PyTorch和TensorFlow,支持直接接入YOLO、Faster R-CNN等经典检测架构。在训练过程中,建议结合数据增强技术(如随机裁剪、色彩抖动)来进一步扩充样本多样性,最终通过准确率、召回率与mAP指标衡量模型性能。
背景与挑战
背景概述
安全帽检测数据集(Safety-helmet-dataset) 诞生于计算机视觉与工业安全交叉领域,旨在解决施工现场等高风险环境中安全帽佩戴的自动识别问题。该数据集由国际研究机构于近年来构建,聚焦于物体检测任务,其核心研究问题在于如何在复杂光照、遮挡和姿态变化下实现对佩戴安全帽的行人进行精准定位与分类。作为工业安全智能监控的基础资源,该数据集推动了边缘计算与深度学习在安全生产中的应用,为降低事故风险提供了数据支撑,对智慧工地和自动化安防系统的发展具有重要影响。
当前挑战
该数据集面临的核心挑战包括:领域问题方面,施工现场场景的复杂性——如多变光照、密集人员、目标尺度差异大——导致安全帽检测易受背景干扰,且小目标漏检率较高;同时,安全帽与相似物体(如头盔、帽子)的区分需要精细化特征建模。构建过程中,数据采集需克服隐私合规与实地标注难题,手工标注多样本中准确标注安全帽与行人的边界框及类别标签成本高昂,且在遮挡或远距离情况下标注一致性难以保障,需引入半自动标注与质量校验机制以确保数据集可靠性。
常用场景
经典使用场景
安全头盔数据集(Safety-helmet-dataset)作为目标检测领域的经典资源,其核心应用场景聚焦于工业与建筑场景中的安全帽佩戴检测。该数据集通过标注工人头部是否佩戴安全帽的视觉样本,为研究人员提供了构建实时监控系统的基准数据,广泛应用于施工现场的智能安防管理。
解决学术问题
在学术研究中,该数据集有效解决了复杂环境下小目标检测与遮挡问题的挑战。通过提供真实工业场景下的多样性样本,推动了轻量化检测模型(如YOLO系列、SSD)在安全帽识别任务中的性能优化,为劳动防护领域的计算机视觉研究奠定了实证基础。
衍生相关工作
基于该数据集,衍生出多项经典工作,包括安全帽检测数据增强策略的研究、跨场景迁移学习方法的探索,以及结合注意力机制的小目标检测算法改进。这些工作进一步拓展了数据集在边缘计算和端侧部署中的适用性。
以上内容由遇见数据集搜集并总结生成


