aparte-titler-gold
收藏资源简介:
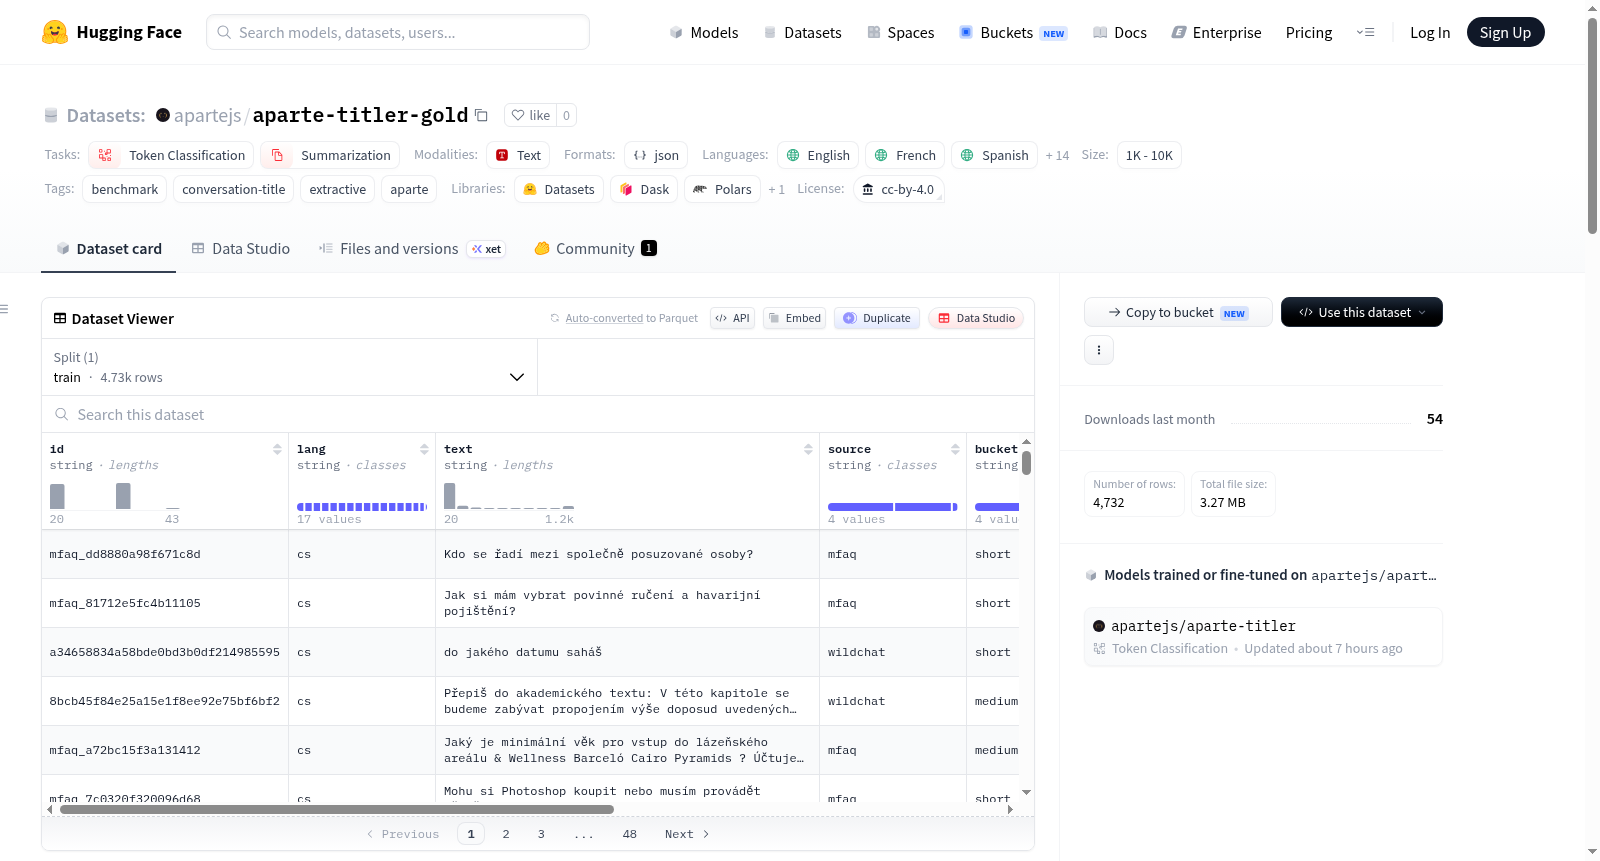
aparte-titler-gold 是 aparte-titler 项目的一部分,是一个用于抽取式会话标题生成(extractive conversation titling)的基准测试数据集。该数据集包含来自17种语言的4,732条消息,其中4,247条已评分。每条消息是对话中的第一条消息,任务是从该消息中逐字复制3-5个词作为标题。数据格式为 JSONL 文件,每行一个 JSON 对象,包含以下字段:id(消息ID)、lang(语言)、text(消息文本,截断至1200字符)、source(来源数据集)、bucket(消息长度类别:short、medium、long、very_long)、title(主要参考标题,由Claude模型生成)、impossible(布尔值,表示消息是否无法提取3个有用词)、off_language(布尔值,表示消息是否不是其文件对应的语言)、references(所有可用的参考标题及其标注者和字符偏移)。多个大型语言模型(如Claude、Gemma)作为标注者提供了参考标题。评估指标为词级别F1,计算候选标题与参考标题的匹配度,排除impossible和off_language的行。数据来自多个来源,包括WildChat、OASST2、Aya、MFAQ等。该数据集仅作为测试集使用,不可用于训练。参考标题和注释以CC BY 4.0许可发布,消息内容保留各自来源的原始许可。
Aparte-titler-gold is part of the aparte-titler project, a benchmark dataset for extractive conversation titling. The dataset contains 4,732 messages from 17 languages, of which 4,247 are scored. Each message is the first message in a conversation, and the task is to verbatim copy 3-5 words from the message as the title. The data format is JSONL, with each line being a JSON object containing the following fields: id (message ID), lang (language), text (message text, truncated to 1200 characters), source (source dataset), bucket (message length category: short, medium, long, very_long), title (primary reference title generated by the Claude model), impossible (boolean indicating whether the message cannot extract 3 useful words), off_language (boolean indicating whether the message is not in the language of its file), references (all available reference titles with annotators and character offsets). Multiple large language models (e.g., Claude, Gemma) served as annotators providing reference titles. The evaluation metric is word-level F1, measuring the match between candidate titles and reference titles, excluding rows with impossible or off_language. Data comes from multiple sources, including WildChat, OASST2, Aya, MFAQ, etc. This dataset is only used as a test set and cannot be used for training. Reference titles and annotations are released under the CC BY 4.0 license, while message content retains the original licenses from their respective sources.
aparte-titler-gold 数据集概述
基本信息
- 许可证:CC BY-4.0(参考标题与标注部分,© 2026 Paul Richez)
- 语言:包含 17 种语言(英语、法语、西班牙语、德语、葡萄牙语、意大利语、荷兰语、波兰语、瑞典语、丹麦语、芬兰语、捷克语、罗马尼亚语、挪威语、匈牙利语、克罗地亚语、立陶宛语)
- 任务类型:token 分类(token-classification)、摘要(summarization)
- 数据规模:1,000 < N < 10,000
- 数据集配置:默认配置,数据文件为
gold/*.jsonl
核心用途
作为 提取式对话标题生成 的基准测试集:给定对话的第一条消息,生成一个从该消息中逐词复制的 3 至 5 个词的标题。共包含 17 种语言的 4,732 条消息,其中 4,247 条被评分,每条消息包含一个或多个由前沿模型盲注并逐词校验的参考标题。
重要提示:此数据集是 aparte-titler 模型的测试集,禁止用于训练。
数据格式
每行一个 JSON 对象,字段含义如下:
| 字段 | 含义 |
|---|---|
id, lang, text, source |
消息内容(截断至 1,200 字符)、语言及来源数据集 |
bucket |
消息长度类别:short(<100字符)、medium(<400)、long(<1,500)、very_long |
title |
主要参考标题:由 Claude (Fable) 从消息中按顺序复制的 3–5 个词 |
impossible |
当消息无法提取出 3 个有意义的词时为 true(如问候语、乱码、原始代码),评分时跳过该行 |
off_language |
当消息语言与文件标注语言不符时为 true,评分时跳过该行 |
references |
所有可用参考标题,格式为 [{annotator, title, spans}],spans 为标题各词在消息中的字符偏移量 |
标注者信息
- claude-fable-5-1:覆盖全部 17 种语言(盲注、单次生成、机械验证每个词均存在于原文且顺序正确、大小写精确匹配)
- gemma-4-e2b-it:覆盖全部 17 种语言(模型训练阶段的教师模型,使用生产环境提示词)
- 英语额外标注者:claude-opus(原始标注)、claude-sonnet、gemma-4-26b-a4b-it、gemma-4-12b-it
- 法语额外标注者:claude-sonnet
评分数据与语言分布
各语言已评分/总数统计(完整数据见 counts.json):英语 296/300、法语 293/300、西班牙语 282/300、德语 234/282、葡萄牙语 288/300、意大利语 263/300、荷兰语 201/243、波兰语 268/296、瑞典语 282/300、丹麦语 267/300、芬兰语 228/300、捷克语 277/300、罗马尼亚语 289/300、挪威语 238/300、匈牙利语 263/300、克罗地亚语 184/197、立陶宛语 94/114。
未评分的 485 行中,403 行为 impossible,84 行为 off_language。
评测指标
采用 词级 F1 分数,比较候选标题与参考标题(词转为小写并去除标点),排除 impossible 和 off_language 行。仅使用主要参考标题进行报告,使教师模型与其他模型在同一标准下被评分。
- 两位在全部语言可用的标注者之间的 F1 一致性为 0.61–0.82(真实对话语言的区间为 0.61–0.72,简短 FAQ 风格数据更高)
- 该任务允许多个合理的标题,真实对话场景下高于约 0.75 的分数不再具有区分意义
- 若需更公平的单条消息评分,可对
references取最大值
局限说明
主要参考标题来自单一标注者,因此分数衡量的是系统复现该标注者的程度。在 9% 的消息上,两位可用标注者生成的标题完全没有共同词——常见于“指令+粘贴文档”型消息,一位标注者按任务命名,另一位按文档命名,规则无法解决此类情况。
构建方法
消息来源与训练数据相同的池子(但无重叠),并按长度类别平衡采样。标注规则的详细说明及机械验证方法见标注协议文档。每位标注者独立查看消息,规则为“3–5 个词,逐词精确复制,按消息顺序,主语优先,跳过请求类词汇”,输出被机械校验直到每个词都能在消息中逐字找到。教师模型的标题来自其正常生产运行。
数据来源与许可
- 参考标题和标注:CC BY 4.0(© 2026 Paul Richez)
- 原始消息保留其来源数据集的许可:
- WildChat-4.8M(ODC-BY)
- OASST2(Apache 2.0)
- Aya(Apache 2.0)
- MFAQ(CC0)
- 英语和法语消息来自 WildChat-1M(ODC-BY)