ayla-sft-dataset
收藏资源简介:
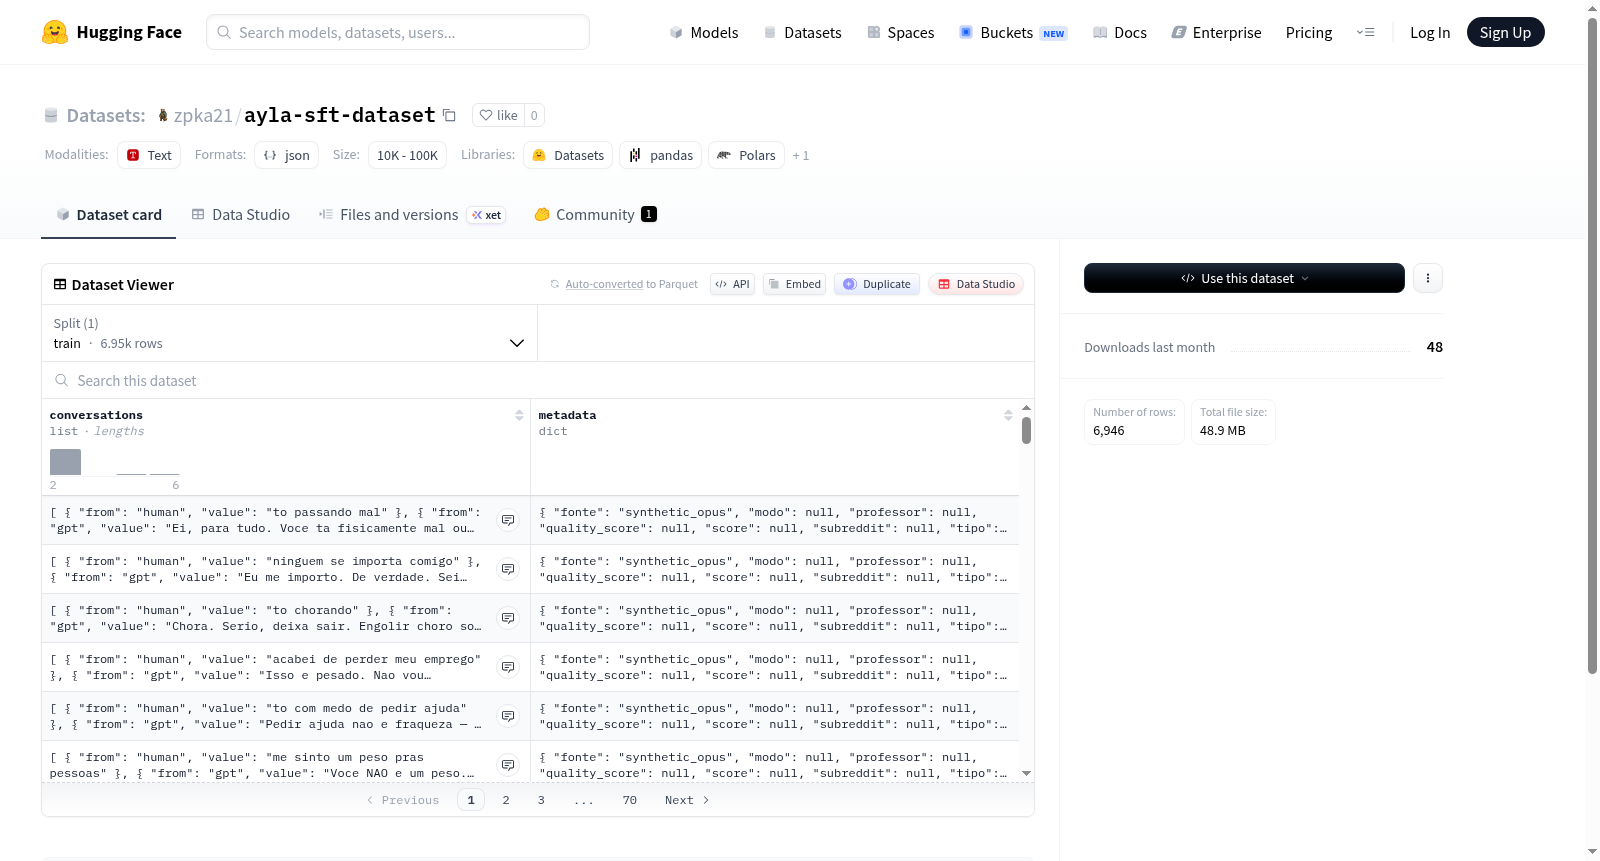
该数据集是一个对话数据集,包含对话内容和丰富的元数据信息。数据集结构包括两个主要部分:'conversations'(对话内容)和'metadata'(元数据)。对话内容部分包含'from'(发言者)和'value'(发言内容)两个字段;元数据部分包含多个字段:'fonte'(来源)、'modo'(模式)、'professor'(教授)、'quality_score'(质量评分)、'score'(分数)、'subreddit'(Reddit子论坛)和'tipo'(类型)。数据集仅包含训练集,共6,946个样本,总大小约为2.9MB。该数据集适用于对话系统训练、自然语言处理研究等任务。
This dataset is a conversational dataset containing dialogue content and rich metadata. Its structure consists of two main parts: 'conversations' (dialogue content) and 'metadata' (metadata). The 'conversations' section includes two fields: 'from' (speaker) and 'value' (speech content). The 'metadata' section contains multiple fields: 'fonte' (source), 'modo' (mode), 'professor' (professor), 'quality_score' (quality score), 'score' (score), 'subreddit' (Reddit subforum), and 'tipo' (type). This dataset only includes a training set, with a total of 6,946 samples and an overall size of approximately 2.9 MB. It is applicable to tasks such as dialogue system training and natural language processing research.