
LieUr/Qwen2-0.5B-Instruct_arc_oai_contrastive
收藏官方服务:
资源简介:
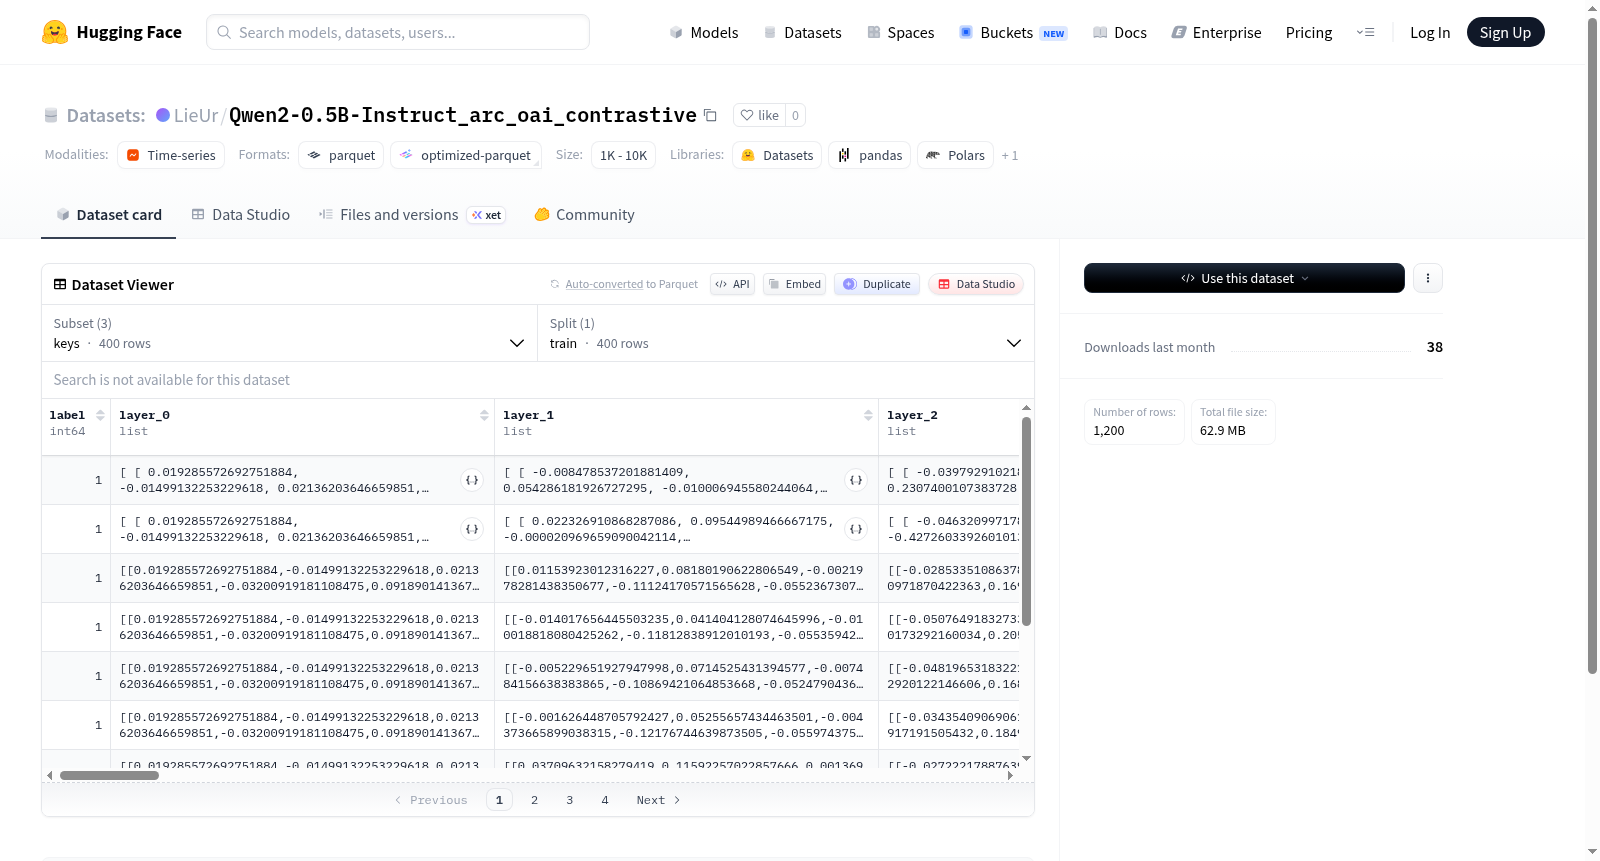
该数据集包含三个子集:keys、residuals和values。每个子集有400个训练样本,每个样本包含一个整数标签(label)和24个层(layer_0到layer_23)的浮点数表示。其中keys和values子集的层表示为二维浮点数列表,residuals子集的层表示为一维浮点数列表。该数据集可能用于研究神经网络(如Transformer)的中间层激活或残差流。
This dataset contains three subsets: keys, residuals, and values. Each subset has 400 training samples, each with an integer label and 24 layers (layer_0 to layer_23) of float representations. The layers in keys and values are 2D lists of floats, while in residuals they are 1D lists. This dataset is likely used for studying intermediate activations or residual streams of neural networks (e.g., Transformers).
提供机构:
LieUr搜集汇总
数据集介绍
构建方式
该数据集基于Qwen2-0.5B-Instruct模型对ARC(AI2 Reasoning Challenge)数据集进行推理,并通过OpenAI的对比学习框架提取中间层表示而构建。具体而言,针对ARC数据集中的每个样本,模型在推理过程中被诱导生成正确与错误的两种答案,随后采集这两种状态下的模型隐藏层激活值。数据集包含三个子配置:keys、residuals和values,分别对应注意力机制的键矩阵、残差流状态以及值矩阵的激活值。每个子配置均保存了模型从第0层到第23层共24个Transformer层的中间特征,以float32格式存储,并附有对应的标签(label),用于区分正误样本。训练集共包含400个样本,每个样本代表了模型在某一推理状态下的完整层激活快照。
特点
该数据集的核心特点在于其分层精细且多维度的架构设计。所有配置均完整捕捉了Qwen2-0.5B-Instruct模型24个Transformer层的内部动态,为研究语言模型在推理过程中的内部表征演化提供了高分辨率的观测窗口。keys与values配置以嵌套列表形式存储每层的二维激活矩阵,保留了注意力机制的空间结构信息;residuals配置则以一维列表形式呈现残差流状态,简化了后续分析。数据集规模精巧,400个样本覆盖了正确与错误推理路径的对比,使其特别适合用于探究模型决策机制、进行可解释性分析以及训练基于激活特征的代理模型。
使用方法
用户可通过HuggingFace的datasets库加载该数据集。加载时需指定config_name参数为'keys'、'residuals'或'values'之一,以选择对应的中间表示子集。例如,使用load_dataset('Qwen2-0.5B-Instruct_arc_oai_contrastive', 'keys')即可获取注意力键矩阵数据。每个样本包含label字段(整数标签)以及layer_0至layer_23共24个字段,分别对应各层的激活值。对于keys和values配置,每层数据为二维列表(形状为[batch_size, hidden_dim]),而residuals配置为一维列表(形状为[hidden_dim])。数据可直接用于训练分类器、进行层间表征相似性分析,或作为探针任务的输入特征。
背景与挑战
背景概述
该数据集名为Qwen2-0.5B-Instruct_arc_oai_contrastive,创建于2024年,由阿里云Qwen团队基于其研发的Qwen2-0.5B-Instruct模型构建,聚焦于大规模语言模型内部表征的对比分析。核心研究问题在于探索模型在不同层次隐藏状态中编码的语义与逻辑关系,特别是通过对比学习范式对ARC(AI2 Reasoning Challenge)数据集中的复杂推理任务进行解构。数据集提供了keys、residuals和values三种配置,分别对应注意力机制中的键、残差流和值向量,每个配置包含400个样本,覆盖模型24层(layer_0至layer_23)的浮点型特征,为理解Transformer架构中推理链路的动态演化提供了高解析度的神经表征资源。该数据集的出现填补了面向指令微调模型内部状态与外部推理任务对齐的实证空白,对可解释人工智能与模型安全领域具有范式意义。
当前挑战
当前面临的挑战主要来自两个维度。领域问题层面,ARC任务要求模型完成超越简单事实检索的复合推理,但现有对比分析多聚焦于表层语义差异,难以捕捉多步逻辑链中知识迁移的断层现象,亟需从隐藏状态中提取因果关联特征。构建过程中,数据规模(仅400条样本)与特征维度过高(每层768维)之间的失衡加剧了过拟合风险,同时残差流配置下3.44MB的数值空间对噪声过滤算法提出严苛要求。此外,不同层间表征的异构性导致层际可比性下降,如何设计标准化协议以统一跨层语义度量,成为利用该数据集进行跨任务泛化的核心瓶颈。
常用场景
经典使用场景
在自然语言处理与可解释人工智能的交叉领域中,Qwen2-0.5B-Instruct_arc_oai_contrastive数据集为探究语言模型内部表征机制提供了独特的资源。该数据集记录了Qwen2-0.5B-Instruct模型在ARC(AI2 Reasoning Challenge)数据集上的逐层隐藏状态,包含残差流、键与值等关键表示。研究者可借助该数据,通过对比分析不同层级的语义编码差异,揭示语言模型在执行复杂推理任务时的信息流动态。经典使用场景包括分析模型中间层对常识知识的编码方式、追踪注意力机制在推理步骤中的贡献,以及评估不同训练指令对模型内部表征的影响。
解决学术问题
该数据集有效解决了语言模型神经机制研究中普遍面临的‘黑箱’困境,为理解模型推理路径提供了实证基础。在学术领域,它助力研究者探索模型如何将外部指令内化为内部计算逻辑,并解答了‘模型在哪个层次捕获了关键推理模式’这一核心问题。通过精细化的层间表征对比,数据集推动了关于模型泛化能力、知识存储与检索机制的讨论。其意义在于,不仅为诊断模型错误提供了精细诊断工具,还促进了可解释性方法的理论建构,使得从表征视角评估与改进语言模型成为可能。
衍生相关工作
基于该数据集,学界涌现了一系列探究语言模型内部结构的前沿工作。例如,有研究利用层间残差分析提出了‘推理轨迹追踪方法’(Reasoning Trajectory Tracing),能够可视化模型在多层间的信息传递路径。另有工作结合对比学习框架,通过分析键与值矩阵的演化规律,提出了‘关键感知蒸馏’(Key-Aware Distillation)技术,有效提升了小模型的推理能力。此外,该数据集还支撑了关于模型知识层级分布的理论验证,催生了如‘深度可解释框架’(Deep Interpretability Framework)等系统性工具,为后续研究奠定了实证基础。
以上内容由遇见数据集搜集并总结生成


