
遇见数据集

apollo-11-air-to-ground-transcript

收藏
Hugging Face2026-08-22 更新2026-08-23 收录
官方服务:

资源简介:

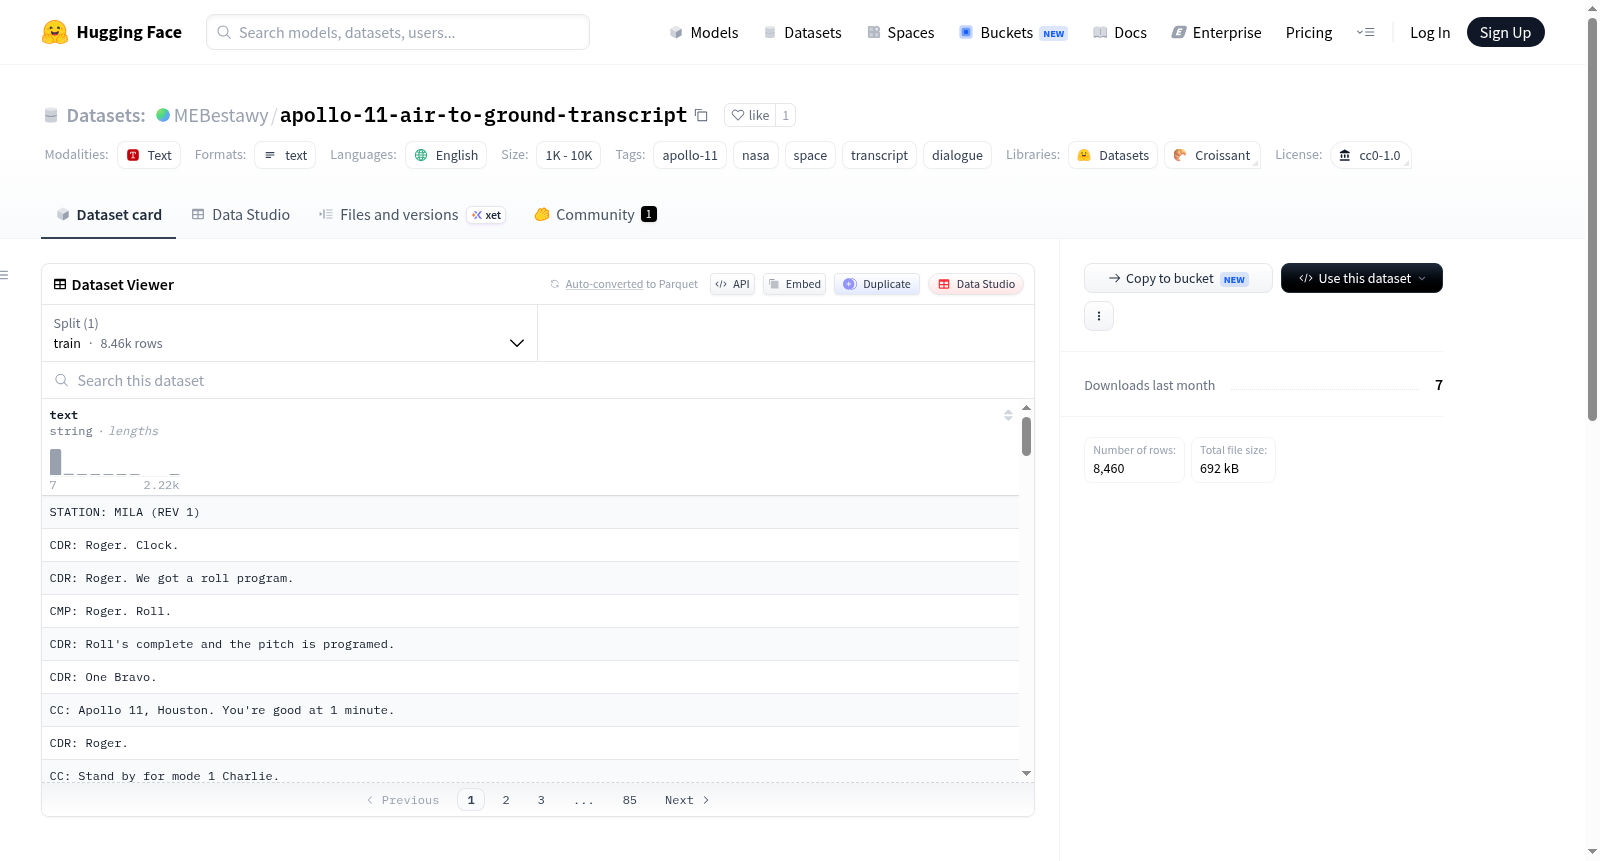
Apollo 11 空对地转录数据集,源自 NASA 阿波罗 11 号技术空对地语音传输(GOSS NET 1)的公共领域转录文本,经清理后形成。数据集包含 8460 行对话,每行以“说话人: 消息”的格式呈现,其中保留了说话人标签、地面站标签(如“STATION: MILA (REV 1)”)以及表示语音模糊的标记(如“...”、“-”、“- -”、“***”),但删除了引言文字、时间戳、磁带/页码标题、编辑注释和休息时段标记。该数据集适用于对话分析、自然语言处理、太空任务历史研究等任务,文件格式为纯文本,大小约 688 KB。

Apollo 11 Air-to-Ground Transcript Dataset, derived from the public domain transcript of NASA Apollo 11 technical air-to-ground voice transmissions (GOSS NET 1), cleaned. The dataset contains 8460 lines of dialogue, each in the format "Speaker: message", retaining speaker labels, ground station labels (e.g., "STATION: MILA (REV 1)"), and markers for speech ambiguity (e.g., "...", "-", "- -", "***"), but removing introductory text, timestamps, tape/page number titles, editorial notes, and rest period markers. The dataset is suitable for dialogue analysis, natural language processing, space mission history research, etc. The file format is plain text, size about 688 KB.

创建时间:
2026-08-22
原始信息汇总

数据集概述

数据集名称:Apollo 11 Air-to-Ground Transcript(阿波罗11号空地通话记录)

许可证:CC0-1.0(公共领域)

语言:英语

标签:阿波罗11号、NASA、太空、通话记录、对话

数据规模:少于1,000条(n<1K)

内容说明

该数据集包含经过清洗的阿波罗11号技术空地语音传输(GOSS NET 1)对话记录。每一行代表一条话语,格式为 说话者: 消息。地面站标记保留为 STATION: MILA (REV 1) 的形式。

数据来源

数据源自 NASA ALSJ 的 阿波罗11号技术空地语音转录,是这一公共领域转录文本的清洗衍生版本。

清洗规则

保留内容

  • 说话者标签
  • 地面站标签
  • 语音中断标记(...-- -***

移除内容

  • 引言文本
  • 时间戳
  • 磁带/页面标题
  • 编辑者注释
  • 休息期标记

文件信息

  • 文件名:apollo-11-air-to-ground-transcript.txt
  • 行数:8,460行
  • 文件大小:约688 KB

使用示例

python from pathlib import Path text = Path("apollo-11-air-to-ground-transcript.txt").read_text() lines = text.splitlines()
搜集汇总
数据集介绍
apollo-11-air-to-ground-transcript 数据集图片
构建方式
该数据集源自NASA历史网站公开的阿波罗11号技术空对地语音传输记录,经过清洗与结构化处理而成。原始转录文本涵盖了任务期间地面站与航天器之间的全部对话,数据构建过程中保留了说话人标签、地面站标签及乱码标记,同时剔除了时间戳、页面页眉、编辑注释及休息时段标记等非语音信息。每一行代表一条独立的话语,格式为“说话人:消息”,地面站标记如“STATION: MILA (REV 1)”亦被保留。最终生成包含8,460行、约688 KB的纯文本文件,确保了语音数据的连贯性与可读性。
使用方法
该数据集的使用极为便捷,支持直接以文本形式加载与分析。用户可通过Python的pathlib模块读取整个文件,并使用splitlines方法将内容按行拆分,以便逐条处理对话。数据集适用于自然语言处理中的对话系统训练、历史语音传输分析、以及航天领域的人机交互研究等场景。其简洁的格式亦便于转换为其他结构(如JSON或CSV),以整合进更复杂的数据处理流程。鉴于其公共领域属性,使用者可自由修改与分发,无需顾虑版权限制。
背景与挑战
背景概述
阿波罗11号任务作为人类首次登月的壮举,其技术空地语音传输记录承载着极高的历史与科学价值。该数据集源自NASA阿尔忒弥斯月球科学杂志(ALSJ)所公开的公共领域转录文本,经深度清洗后,每行以‘说话人:消息’的格式呈现,保留了说话人标签、地面站标记及语音失真标记,剔除了时间戳与编辑注释等冗余信息,共计8,460行文本。此数据集的构建,旨在为语言技术、对话系统及太空史研究提供高质、规范的语料基础,其发布对自然语言处理在特殊领域语料的标准化处理具有示范意义。
当前挑战
领域挑战方面,该数据集聚焦于特定历史事件的语音转录,面临背景噪声、专业术语、口语化表达及信号失真等复杂情况,为语音识别与文本分析带来技术挑战。构建过程中的挑战则在于原始转录的清洗与格式化,需平衡保留关键信息与去除干扰元素,确保数据的一致性与可用性。此外,公开语料的版权与伦理考量亦需谨慎处理,CC0-1.0许可的采用虽促进了共享,但如何在此框架下兼顾数据完整性与历史准确性,仍是持续优化的方向。
常用场景
经典使用场景
该数据集收录了阿波罗11号任务期间航天员与地面控制中心之间完整的技术性空地语音传输记录,文本按发言者与地面站标注进行了清洗与格式化,适用于自然语言处理领域中的对话系统研究、语音识别后的文本分析以及历史语料库建设。研究人员可基于此语料开展领域术语挖掘、会话结构解析、异常通信模式检测等经典任务,亦可作为航天工程人机交互研究的基准数据源。其经典使用场景集中于对任务关键阶段(如发射、入轨、登月及返回)沟通内容的细粒度解析,通过话语序列的重构与标注,支撑对任务决策过程的量化理解。
解决学术问题
该数据集解决了航天领域历史文献数字化与结构化不足的学术痛点,为跨学科研究提供了可复用的高信度语料。具体而言,它推动了计算语言学中低资源领域对话建模的研究进展,使得非通用领域的口语对话(含噪声、中断与专业术语)得以被系统分析。同时,该语料为任务型对话中的错误检测与恢复机制研究提供了罕见的真实案例,有助于探索在极端高压力环境下人类沟通的鲁棒性特征,从而推动人因工程与认知科学的相关理论验证。
实际应用
在实际应用中,该数据集可作为航天任务模拟训练系统的参考文本,用于生成高逼真度的通信场景,辅助航天员与地面控制人员熟悉任务通信协议与应对异常情况。此外,其内容可被整合进历史教育平台或科普展示系统,为公众提供亲历登月过程的沉浸式体验。对于语音识别技术企业,该语料可用于开发针对专业领域、噪音环境及非标准发音的定制化语言模型,提升相关技术在航空航天、应急指挥等垂直行业的实用性能。
数据集最近研究
最新研究方向
Apollo 11空地通信语音转录数据集作为人类航天史珍贵语料的数字化典藏,在自然语言处理与历史档案研究交叉领域焕发新生。当前前沿方向聚焦于利用该数据集构建高保真对话系统训练基准,尤其针对噪声环境下的语音识别和说话人分离任务;同时,它也成为分析早期太空任务中宇航员与地面控制中心交互模式、技术术语体系及应急沟通策略的关键语料。随着大语言模型对领域特定语料需求的激增,该数据集正被用于微调航天领域智能助手,以支持任务模拟训练与知识图谱构建,其CC0许可协议更促进了跨学科研究的开放共享,有力推动了数字人文学科对载人航天社会技术系统的深度解析。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

