
Usenet-Corpus-1980-2013-Full-Samples
收藏官方服务:
资源简介:
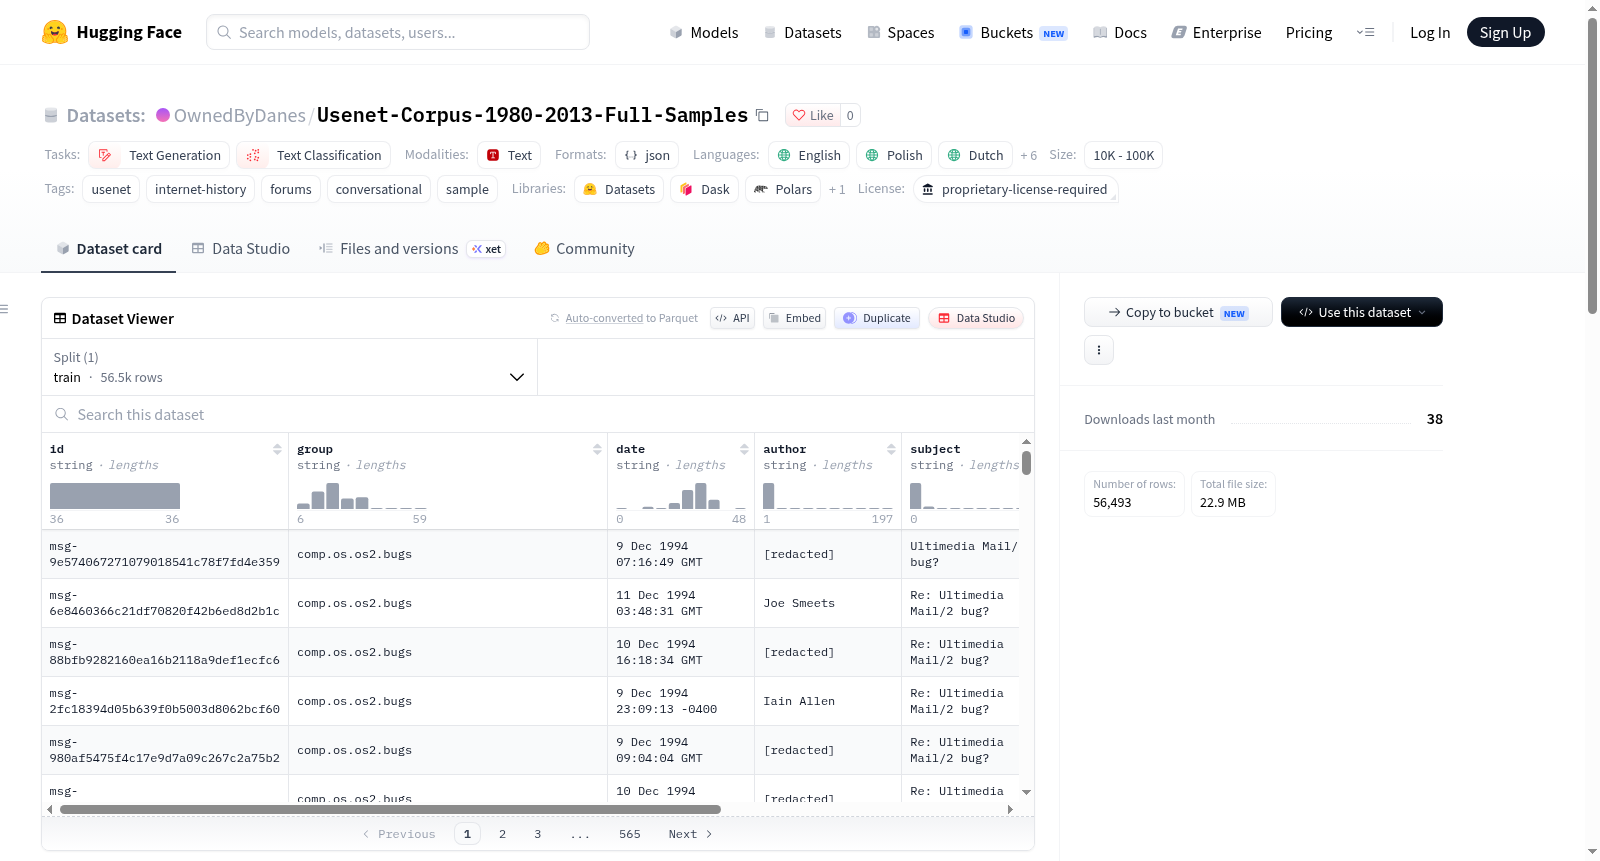
Usenet Corpus 1980–2013 — Full (Samples) 是一个从完整 Usenet 语料库(1980-2013年)中抽取的样本数据集,旨在提供可浏览的展示样本。完整语料库包含4.08亿条帖子、1030亿个词符,采用商业许可。该样本包含11个 gzip 压缩的 JSON Lines 文件:每个主要新闻组层级(如 alt、comp、misc 等)各约5000条帖子(alt 层级约2000条),同时提供 Big 8 组合样本和所有层级组合样本(各约9000条帖子)。帖子选自至少包含3条帖子的完整对话线程,以确保讨论的连贯性,因此样本偏向于多帖子线程,不代表完整语料库的分布。每条记录包含以下字段:id(稳定帖子标识符)、group(新闻组名称)、date(RFC 2822日期)、author(作者显示名,电子邮件已编辑)、subject(主题行)、text(帖子正文)。数据来源自清洁去重后的语料库:去除了二进制附件和 alt.binaries.* 组的帖子,排除了成人新闻组,编辑了作者电子邮件地址,将原始 Message-ID 替换为哈希值,并移除了 ClamAV 识别的恶意软件内容。内容保持原始历史文本,可能包含冒犯性、偏见或错误信息,应作为原始历史资料对待。该样本仅用于评估,不授予使用、复制、重新分发或训练的权利。适用任务包括文本生成和文本分类。
创建时间:
2026-09-08
搜集汇总
数据集介绍
构建方式
该样本数据集源自1980至2013年间Usenet平台的 cleaned 语料库,遵循完整对话线程的提取逻辑,仅保留至少包含三篇帖子的讨论链,以呈现连贯的交流语境。每个层级独立抽取约五千篇帖子,ALT层级约两千篇,另设Big 8及全层级混合样本各约九千篇。所有帖子经过去重、移除二进制附件与alt.binaries.*组、排除成人组、脱敏作者邮箱、哈希化Message-ID,并剔除匹配ClamAV恶意软件签名的内容,最终以压缩JSON Lines格式存储。
特点
该数据集聚焦于前网络时代的Usenet长文讨论,涵盖英语、波兰语、荷兰语、西班牙语、法语、意大利语、德语、俄语和日语等多语种内容,涉及文本生成与文本分类任务。其显著特点在于以完整线程为单元组织样本,而非孤立帖子,从而保留对话的上下文连贯性。字段结构包含稳定的帖子标识、新闻组、原始日期、脱敏作者名、主题及正文,内容保持历史原貌,未加审查,可能含有冒犯性或偏见性表述,适宜作为历史语料研究。
使用方法
该数据集作为预览样本,适用于浏览、评估及小规模实验。用户可通过HuggingFace数据集接口加载gzip压缩的JSON Lines文件,逐行解析JSON对象以获取帖子元数据与正文。使用时需注意其许可为专有许可,仅限评估目的,不得用于训练、复制或再分发。若需完整语料或对话结构,可分别访问门控的全量清洗数据集及线程化伴生数据集,商业用途须另行获取书面授权。
背景与挑战
背景概述
作为前万维网时代规模最为宏大的分布式讨论系统,Usenet自1980年诞生起便承载了跨语言、跨地域的公共话语,其文本被视为研究互联网早期社会互动与语言演化的珍贵一手史料。Usenet-Corpus-1980-2013-Full-Samples由OwnedByDanes LLC构建并发布,旨在将1980年至2013年间逾4.08亿篇帖子、1030亿词元的清洗后语料以可浏览样本形式开放预览。该数据集聚焦长文本、多语种的论坛对话,为文本生成与文本分类任务提供了具有历史纵深与对话结构的语料基础,对计算语言学、数字人文及互联网历史研究具有重要的基础性意义。
当前挑战
在领域问题层面,该样本需应对数十年来非规范文本带来的语言漂移、多语种混杂及未审核内容中的偏见与冒犯性表达,这对模型的鲁棒性与公平性构成严峻考验。在构建过程中,原始存档包含大量二进制附件、成人组及恶意内容,须经去重、匿名化与ClamAV病毒特征扫描等复杂清洗流程;同时,样本刻意选取至少三帖的完整讨论串以保证可读性,与全语料以单帖为主的真实分布形成偏差,如何平衡展示价值与统计代表性亦构成显著挑战。
常用场景
经典使用场景
在互联网历史与计算语言学的交叉视域下,该数据集常被用于长文本生成与文本分类任务的基准构建。因其收录了1980至2013年间Usenet新闻组的完整讨论线索,研究者可借助多层级、多语种的帖子样本,训练能够捕捉长篇对话结构与主题漂移的生成模型,或对帖子进行话题、立场及年代归属的分类实验。样本刻意保留至少三帖的完整线程,使模型得以观察论证展开与回复引用的语用特征,从而为对话建模提供贴近早期网络社区真实交互形态的语料基础。
实际应用
在应用层面,该数据集可服务于社交媒体分析、档案检索与内容审核系统的开发。企业或研究机构可利用其构建早期论坛风格的对话代理、训练跨年代的主题追踪工具,或评估模型对过时俚语与敏感历史表述的识别能力。新闻档案机构亦可借助帖子元数据实现专题化检索与时间线可视化。由于样本以可读性为筛选导向,产品团队能够快速开展原型验证,而完整许可语料则支撑大规模商业级模型的预训练与领域适配。
衍生相关工作
围绕该数据集,已衍生出若干经典工作方向。其线程化伴随仓库催生了对话结构解析与引文网络分析的研究;完整许可语料则被用于训练早期网络语域的语言模型,并促进了去标识化与内容安全过滤的技术讨论。部分学者利用其多语种子集开展跨语言论坛行为比较,另有工作聚焦于长尾新闻组的社区消亡预测。这些衍生研究共同拓展了Usenet语料在计算社会科学与历史语言学中的应用边界。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


