
遇见数据集

AlexandreSheva/rukopys-curated-mvp

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

RUKOPYS Curated MVP是一个乌克兰手写识别数据集,是原始RUKOPYS数据集的任务就绪衍生版本,专门用于乌克兰手写文档AI处理。该数据集将原始RUKOPYS版本转换为可重复的训练工件,支持全页视觉语言微调、裁剪级手写文本转录和布局检测。数据集内容包含元数据文件、区域注释、视觉语言模型微调示例、YOLO格式布局检测数据等,适用于端到端手写文本识别(HTR)流程,包括模型训练、推理和评估。数据集涵盖多种来源,如档案、学校作业和大学考试,并包含不同类型区域(如手写文本、公式、表格等),适用于乌克兰语手写文档的解析、布局检测和OCR/HTR基准测试。

RUKOPYS Curated MVP is a Ukrainian handwriting recognition dataset, a task-ready curated derivative of the original RUKOPYS dataset for Ukrainian handwritten document AI. It transforms the raw RUKOPYS release into reproducible training artifacts for full-page vision-language fine-tuning, crop-level handwriting transcription, and layout detection. The dataset includes files such as metadata.jsonl, regions.jsonl, VLM and page SFT examples, and YOLO-format layout detection data, supporting an end-to-end HTR pipeline for model training, inference, and evaluation. It covers various sources like archives, school assignments, and university exams, with region types including handwritten text, formulas, and tables, and is recommended for Ukrainian handwritten page parsing, layout detection, and OCR/HTR benchmarking.
提供机构:
AlexandreSheva
搜集汇总
数据集介绍
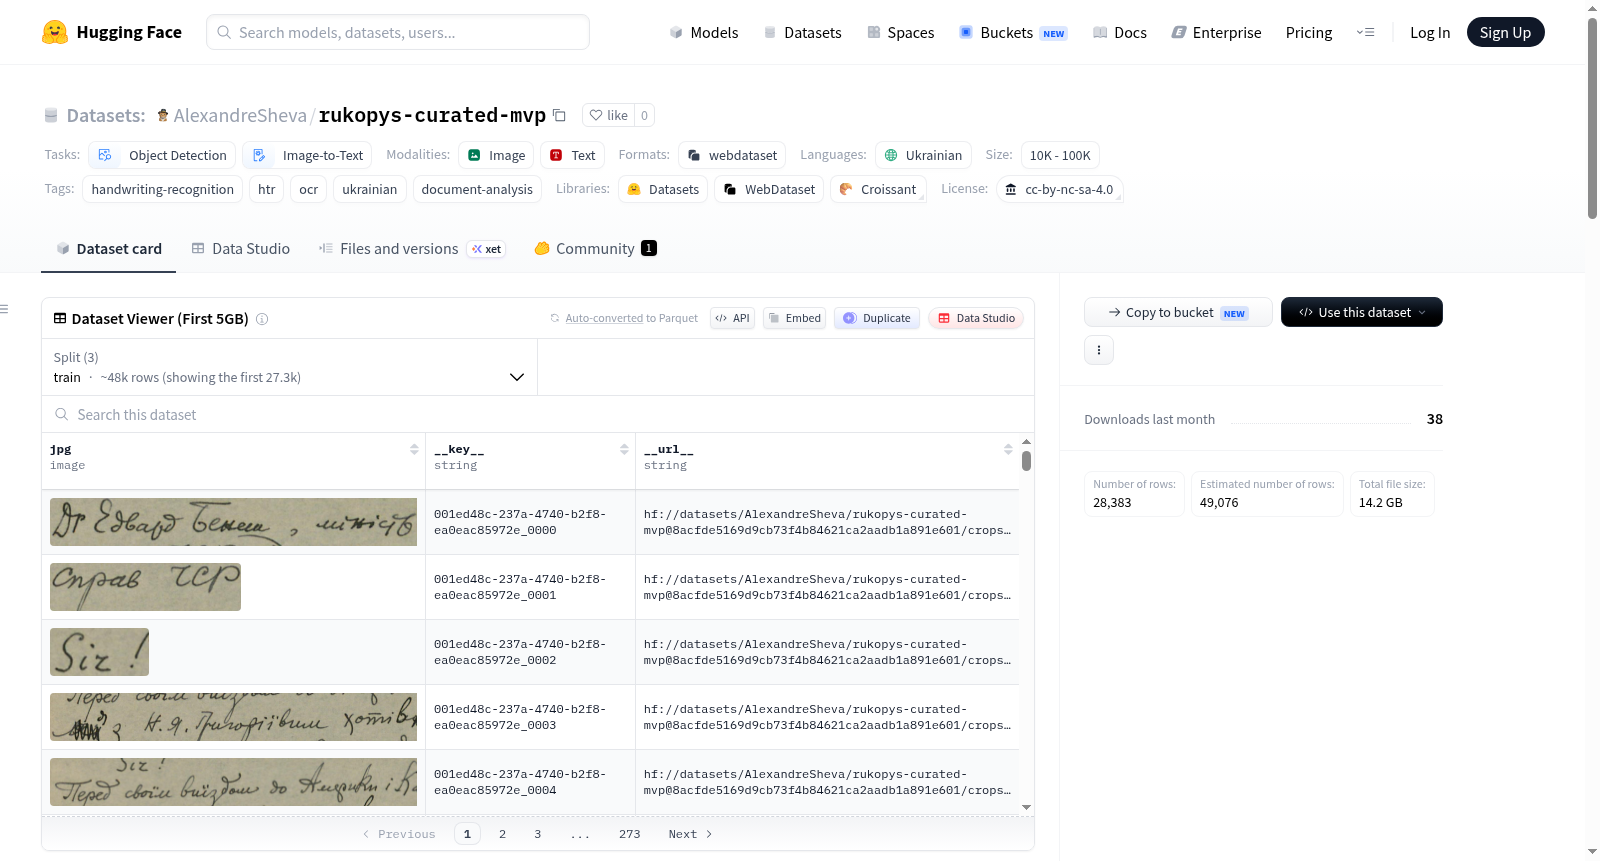
AlexandreSheva/rukopys-curated-mvp 数据集图片
构建方式
RUKOPYS Curated MVP数据集源于乌克兰天主教大学发布的原始RUKOPYS数据集,旨在为乌克兰语手写文档识别提供可直接用于训练的标准化资源。构建过程首先从原始数据中提取2715个页面和39420个区域注释,进而生成多种格式的训练制品:包括全页面图像到结构化JSON的监督微调样本、裁剪区域级别的转录样本,以及YOLO格式的布局检测数据集。每条数据依据注释来源分配不同的质量权重,其中人工标注者权重为1.0,志愿者为0.75,自动生成为0.35,以此确保训练数据的可靠性。最终产物以元数据JSONL、区域JSONL、裁剪图像和打包清单等形式组织,便于后续的模型训练与推理评估。
特点
该数据集的核心特色在于其多任务适配性与结构化输出能力,不仅支持全页面图像到JSON的视觉-语言微调,还能服务于裁剪区域的逐行转录、YOLO格式的布局检测实验以及区域级分析过滤。数据来源横跨档案、口述、学校和大学四类场景,覆盖手写文本、公式、表格、图像等八种区域类型,其中手写区域占比高达79%,为模型提供了丰富的上下文多样性。通过引入质量权重机制,数据集实现了对注释可信度的量化区分,从而为训练更加鲁棒的识别模型奠定基础。此外,数据集明确从原始数据中生成可复现的训练制品,确保了实验的可重复性。
使用方法
使用者可根据具体任务灵活选择数据集的不同子集:对于视觉-语言模型的微调,可直接使用全页面SFT样本(2330条)或裁剪区域SFT样本(38832条)进行监督学习;若需训练布局检测器,则可借助预生成的YOLO格式数据与标注文件。数据集以JSONL和目录结构存储,便于与常见的深度学习框架(如PyTorch、HuggingFace Transformers)集成。推荐的典型应用包括乌克兰语手写文档的端到端解析、文档区域布局检测、OCR后处理基准测试,以及构建从原始数据到模型产物的可复现AI流水线。通过引用原始RUKOPYS数据集,用户可在学术研究中合法使用本数据集。
背景与挑战
背景概述
在数字化文档处理与文化遗产保护领域,手写文本识别(Handwriting Text Recognition, HTR)始终是光学字符识别(OCR)技术中极具挑战性的分支,尤其是针对非拉丁语系的语言,如乌克兰语,其复杂的字母形态与丰富的连笔书写方式进一步加剧了识别的难度。由乌克兰天主教大学(Ukrainian Catholic University)的研究团队Dmytro Voitekh、Volodymyr Zmiivskyi与Oleksii Molchanovskyi于2026年创建的RUKOPYS数据集,首次大规模覆盖了从1920年代档案手稿到2025年现代学校作业的乌克兰语手写样本,旨在填补乌克兰语手写识别领域标注数据的空白。该数据集不仅为端到端的手写文档理解提供了基础,还通过衍生版本RUKOPYS Curated MVP进一步支持全页面视觉-语言微调、裁剪级转录与布局检测等任务,极大地推动了乌克兰语文档AI研究的可复现性与工程化落地,成为该领域的重要基准资源。
当前挑战
RUKOPYS Curated MVP数据集所解决的核心领域挑战在于乌克兰语手写文档的自动解析,包括整页图像的结构化JSON输出、不同来源(如档案、听写、作业)的书写风格变异、以及手写与打印、公式、表格等混合区域的布局检测。在构建过程中,研究团队面临多重困难:原始RUKOPYS数据因来源多样性(archive、dictation、school、university)而导致书写质量与噪声水平差异悬殊,需设计合理的质量控制权重(如注释者权重1.0、志愿者0.75、自动0.35);同时,数据集需从原始非结构化格式转换为适用于YOLO目标检测与语言模型微调的多任务格式(包括VLM SFT与Page SFT),并确保28个区域类型(涉及手写、公式、图像等)的标注一致性。此外,仅2715页文档对应39420个区域的高密度标注,对标注成本与数据清洗策略提出了严格要求。
常用场景
经典使用场景
在手写文档智能化分析这一前沿领域,rukopys-curated-mvp数据集凭借其精心设计的全页面图像到结构化JSON的标注范式,成为训练视觉语言模型(VLM)进行乌克兰语手写页面解析的经典选择。该数据集提供了2330条全页面SFT样本与38832条裁剪区域转录样本,使研究者能够直接开展端到端的图像理解与文本生成联合建模。不仅如此,其内置的YOLO格式布局检测数据更是为手写文档区域定位提供了标准化的训练基础,无论是标注行、公式还是表格,都能通过该数据集实现高精度检测。这种多层次、多任务兼容的数据组织形式,使得该数据集在文档智能处理中扮演着不可替代的基石角色。
实际应用
在现实世界的应用场景中,rukopys-curated-mvp数据集为乌克兰语历史档案的数字活化提供了技术引擎。无论是1920年代档案馆藏中泛黄纸页上的手写记录,还是当代学校考试中学生笔迹各异的答卷,该数据集训练出的模型均可实现高效的自动转录与结构化提取。具体而言,基于该数据集开发的系统已被用于处理教育领域的作业批改、大学入学考试的手写答案解析,以及档案机构中对老式乌克兰语手稿的数字化建档。其全页面解析能力还使得复杂文档中公式、表格与图像元素的联合理解成为可能,大幅提升了政府文书流转与学术资料整理等场景下的自动化水平。
衍生相关工作
围绕该数据集的独特设计,一系列具有影响力的研究工作应运而生。其中,基于其全页面SFT格式衍生出的乌克兰语手写文档视觉语言模型,展现了超越传统分步式OCR流水线的端到端理解能力。另有研究利用其YOLO格式布局检测数据,开发了针对手写文档中公式区域与表格结构的轻量化检测器,显著降低了计算开销。此外,该数据集的三级质量权重体系启发了多项关于噪声数据对HTR模型影响的分析工作,推动了一系列自适应数据筛选与加权训练策略的提出。这些衍生工作不仅深化了乌克兰语手写识别的技术谱系,也为其在小语种文档AI领域树立了方法论的标杆。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

