
ScaleAI/DrugDiscoveryBench-Preview
收藏官方服务:
资源简介:
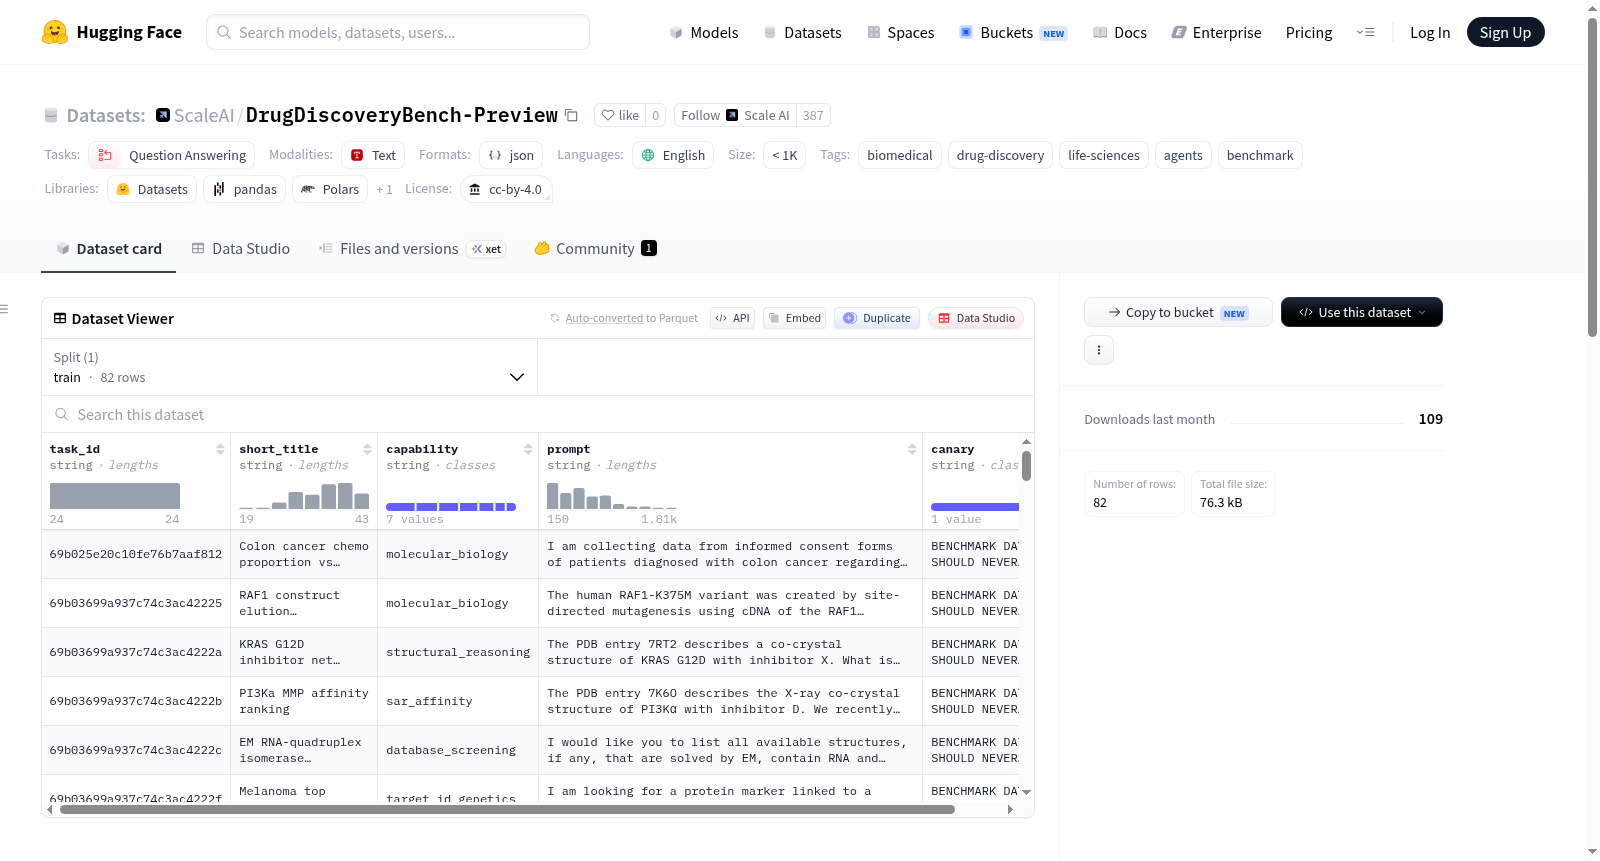
DrugDiscoveryBench是一个基准测试,包含82个专家编写的、基于执行的任务,涵盖早期药物发现和生命科学工作流程(目标识别与遗传学、数据库筛选、专利挖掘、化学信息学、结构推理、SAR与亲和力、分子生物学)。每个任务要求代理执行多步骤生物医学调查并产生简洁的最终答案。
DrugDiscoveryBench is a benchmark containing 82 expert-written, execution-based tasks covering early-stage drug discovery and life science workflows, including target identification and genetics, database screening, patent mining, cheminformatics, structural reasoning, SAR and affinity, and molecular biology. Each task requires the agent to perform multi-step biomedical investigations and generate concise final answers.
提供机构:
ScaleAI搜集汇总
数据集介绍
构建方式
DrugDiscoveryBench-Preview是基于早期药物发现与生命科学工作流程精心构建的基准数据集,由82项专家撰写的可执行任务组成。这些任务涵盖靶点识别与遗传学、数据库筛选、专利挖掘、化学信息学、结构推理、构效关系与亲和力分析以及分子生物学七大能力范畴。数据集以JSONL格式存储,每条记录包含任务标识符、简要标题、能力类别、任务提示及污染检测金丝雀字符串,为多步骤生物医学探究提供了标准化的测试框架。
特点
该数据集的核心特色在于其专业性与任务导向性:所有任务均由领域专家设计,强调执行导向,要求智能体完成复杂的多步推理并输出简洁答案。作为预览版本,它开放了任务提示与元数据,但不包含真实答案与评分标准,有效防止训练数据泄露。此外,数据集内置了金丝雀字符串,便于在训练语料中检测其存在,确保了基准测试的纯洁性与评估的公正性。
使用方法
研究人员可直接使用本预览版数据集观察任务分布与提示内容,以理解药物发现领域的关键挑战。对于模型评估,则需申请访问完整的gated版本DrugDiscoveryBench,该版本包含人工审核的真实答案及结果/过程评分标准。使用时需注意,应避免在模型训练中引入该数据,可通过金丝雀字符串过滤文档。数据集以JSONL格式加载,支持按能力类别进行细粒度分析,适用于智能体系统的能力测试与对比研究。
背景与挑战
背景概述
药物研发是一个高度复杂且成本高昂的领域,传统方法依赖于专家经验与大量的湿实验验证,效率低下。近年来,随着人工智能技术的飞速发展,利用大语言模型和智能体系统辅助药物发现已成为研究热点,然而现有基准测试多聚焦于通用问答或单一任务,缺乏对端到端多步骤药物研发流程的系统评估。DrugDiscoveryBench(预览版)由ScaleAI于近期发布,涵盖82项专家撰写的、基于执行验证的任务,覆盖靶点识别与遗传学、数据库筛查、专利挖掘、化学信息学、结构推理、构效关系与亲和力、分子生物学等七大核心能力,旨在评估智能体在早期药物发现全流程中的表现。该基准填补了领域内缺乏综合性、执行导向评估体系的空白,为药物研发智能体的标准化测试提供了重要参考,推动AI在生命科学领域的深入应用。
当前挑战
DrugDiscoveryBench所解决的领域问题核心挑战在于药物研发流程的复杂性与长链条特性,现有模型难以在缺乏专业指导和反馈的情况下自主完成多步推理与数据整合,且不同子任务间依赖关系紧密,任何环节的误差均可能导致最终结论失效。在构建过程中,数据集面临诸多困难:任务设计需由领域专家手工编写,确保每个问题均贴近实际研发场景且具备执行可验证性,82个任务的规模虽小但耗费大量人力与时间;考虑数据集可能被用于模型训练,引入了污染检测金丝雀标识;为保障评估的公正性,完整基准需包含标准答案与评分细则,当前仅发布提示以供预览,完整版需经人工审核访问,平衡了开放性与安全性间的矛盾。
常用场景
经典使用场景
DrugDiscoveryBench-Preview作为药物发现领域的专用基准测试集,其核心应用场景在于评估AI智能体在早期药物研发流程中的多步推理与执行能力。该数据集精心设计了82个由领域专家撰写的任务,涵盖靶点识别与遗传学、数据库筛选、专利挖掘、化学信息学、结构推理、构效关系与亲和力分析以及分子生物学等七大核心能力维度。每个任务都要求智能体完成复杂的生物医学调研并给出精简的最终答案,因此它特别适合用于衡量大语言模型在专业、多步、执行导向的生物医学问答任务上的表现。
实际应用
在工业界的实际应用中,该数据集为制药公司和AI初创企业提供了一个标准化的测试平台,用以诊断和优化药物研发AI助手的性能。例如,研发团队可以利用其中的数据库筛选和专利挖掘任务来评估系统在真实文献检索与知识整合中的效率,或通过结构推理与SAR任务测试模型在分子设计与活性预测环节的准确性。此外,数据集中的靶点识别与分子生物学任务还能帮助验证AI系统在跨学科生物医学知识融合方面的综合能力,从而指导企业更有针对性地改进其智能药物发现平台。
衍生相关工作
该数据集的发布直接催生了多个前沿研究方向:首先,基于其任务定义和评估框架,研究人员开始探索如何构建更鲁棒的药物发现智能体,例如结合外部知识库检索与分子模拟工具的多模态代理系统。其次,其详尽的领域能力分类激励了针对特定子任务(如构效关系推理或专利文本挖掘)的专用模型训练工作。最后,该数据集严格的污染控制机制也启发了社区开发更多带有canary标记的专业领域基准,推动了科学评估方法论的发展,形成了从单一基准到评估体系化的良性延伸效应。
以上内容由遇见数据集搜集并总结生成


