
遇见数据集

marin-community/grug-moe-mix-swarm

收藏
Hugging Face2026-07-10 更新2026-07-22 收录
官方服务:

资源简介:

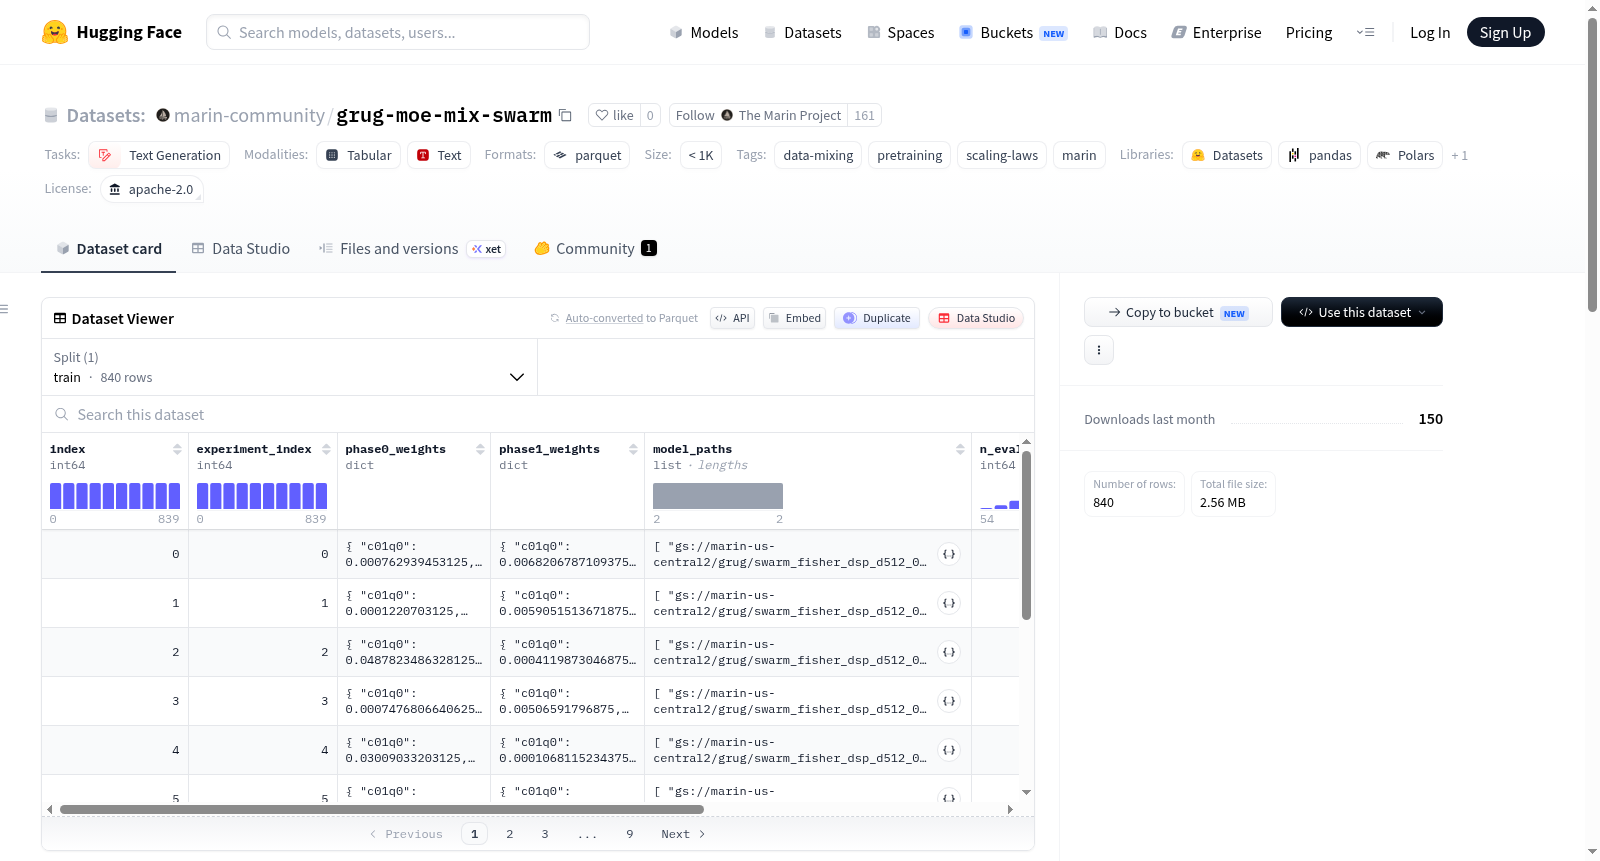
Grug-MoE Fisher-DSP Mix Swarm (840 runs) 是一个包含840个MoE预训练运行的数据集,源自Grug-MoE Fisher-DSP数据混合群(维度512,运行于TPU/us-central2)。每个运行在168个数据桶的不同数据混合上进行训练;该群用于回归混合权重→评估损失,并预测优化的预训练混合。数据集包含实验索引、阶段0和阶段1的混合权重(字典格式,总和为1)、模型路径、评估任务数量、宏观比特每字节(bpb)以及每个任务的评估结果(以JSON字符串存储)。数据仅包含元数据(混合权重、评估损失、检查点路径字符串),不包含模型权重本身。

Grug-MoE Fisher-DSP Mix Swarm (840 runs) is a dataset containing 840 MoE pre-training runs, derived from the Grug-MoE Fisher-DSP data mixture swarm with a dimension of 512, deployed on TPU/us-central2. Each run is trained on distinct data mixtures across 168 data buckets; this dataset is designed to regress mixture weights, evaluate corresponding losses, and predict optimized pre-training mixtures. The dataset includes experimental indices, mixture weights for Stage 0 and Stage 1 (formatted as a dictionary with a sum of 1), model paths, the number of evaluation tasks, macro bits per byte (bpb), and per-task evaluation results stored as JSON strings. The dataset only contains metadata including mixture weights, evaluation losses, and checkpoint path strings, and does not include the model weights themselves.
提供机构:
marin-community
搜集汇总
数据集介绍
marin-community/grug-moe-mix-swarm 数据集图片
构建方式
Grug-MoE Fisher-DSP Mix Swarm数据集源自一项大规模数据混合优化实验,共包含840次独立的MoE预训练运行,每次运行均基于168个数据桶(datakit buckets)生成独特的数据混合权重,并通过两阶段训练(phase-0与phase-1)完成。数据集以Parquet格式存储,每一行记录对应一次实验的混合权重、评估损失及检查点路径,权重字段以字典形式呈现,确保自描述性。所有实验均在TPU集群(us-central2)上执行,混合策略源自production_swarm_168p最优混合列表,评估结果通过lm-eval框架获取,最终构成一个用于回归分析数据混合权重与损失之间关系的完整集合。
特点
该数据集的核心特色在于其系统性探索了数据混合对模型性能的影响,包含168个细粒度数据桶(按语义聚类CC与质量等级Q划分),覆盖从高质量到低质量的多样化语料源。每行记录同时提供phase-0与phase-1两阶段混合权重,支持分析动态混合策略的影响。评估指标不仅包含全局宏观bpb(macro_bpb),还提供每个任务级别的bpb、准确率等细粒度结果,便于多维度分析。此外,数据集规模虽小(840行),但每行承载的混合信息高度浓缩,特别适用于研究数据混合与损失之间的函数关系,为优化预训练数据配比提供实证基础。
使用方法
用户可通过HuggingFace Datasets库直接加载数据,使用load_dataset('marin-community/grug-moe-mix-swarm', split='train')即可获取训练集。每条记录中的evals字段为JSON字符串,需通过json.loads()解析为任务级评估结果字典,而phase_weights字段可直接作为字典使用,方便提取特定数据桶的权重值。数据集主要用于回归建模,以macro_bpb为目标变量,以混合权重为特征,预测最优混合比例。同时,model_paths字段提供检查点路径(私有存储桶)用于模型复现,但需注意模型权重本身不包含在数据集中,仅存储路径引用。
背景与挑战
背景概述
在大规模语言模型预训练过程中,数据混合策略对模型性能的影响至关重要。现有研究多聚焦于固定数据配比,忽略了不同数据源之间复杂的相互作用。为系统性地探索数据混合的最优解,Marin团队于2023年构建了Grug-MoE Fisher-DSP Mix Swarm数据集,该数据集记录了840次MoE预训练实验,每次实验采用不同的数据混合方案,包含168个数据桶的权重分配,并以bits-per-byte为回归目标。该工作通过将混合权重与评估损失之间的映射关系进行回归分析,成功预测出优化的预训练混合比例,为数据混合领域提供了可复现的实证基准,对理解和设计高效预训练数据策略具有重要参考价值。
当前挑战
该数据集主要应对两大挑战。首先,数据混合优化本身存在高维搜索空间,168个数据桶的权重组合导致传统枚举方法计算成本极高,且各数据源之间的非线性交互效应难以建模,直接限制了模型在不同下游任务上的泛化能力。其次,构建过程中面临大规模实验的管理难题,包括在TPU集群上协调840次独立运行、确保不同混合下训练过程的稳定性,以及统一评估协议以便跨实验对比,同时还需处理检查点存储与路径引用的一致性,这些工程复杂性远超过小规模消融实验的范畴。
常用场景
经典使用场景
Grug-MoE Fisher-DSP Mix Swarm数据集为混合专家(MoE)语言模型的预训练数据混合优化研究提供了关键的实验支撑。该数据集记录了840次在168个数据桶上探索不同混合权重的预训练运行结果,通过系统性地变化训练数据配比,助力研究者揭示数据组成与模型最终评估损失之间的内在关联。其经典范式是构建数据混合权重到模型性能(如字节级困惑度)的回归映射,进而预测出能显著降低损失的优化混合方案,为大规模预训练中的数据选择策略提供了可量化的实验基础。
衍生相关工作
基于本数据集衍生的经典工作主要围绕数据混合回归与最优预测展开。研究者利用其840次运行的评估损失与混合权重记录,开发了多种统计或神经网络回归器,用以学习从混合向量到性能指标的映射,并成功预测出超越单次运行的优化混合。相关方法被推广至动态数据选择、课程学习以及多任务学习中的数据调度领域,例如后续工作借鉴其数据桶划分思想构建了细粒度的质量分层体系,或将其回归框架适配于不同规模的MoE架构,进一步验证了数据混合优化对模型训练可扩展性的关键作用。
数据集最近研究
最新研究方向
在语言模型预训练领域,数据混合比例的优化成为提升模型性能的关键突破口。Grug-MoE Fisher-DSP Mix Swarm数据集记录了840次MoE预训练实验,通过系统性地扰动168个数据桶的混合权重,构建了从混合策略到评估损失的回归映射。这一工作紧密关联scaling laws与数据质量自动筛选的前沿探索,其核心价值在于利用大规模受控实验揭示不同数据源对最终模型损失的贡献规律,为自动化最优预训练数据配比提供了实证基础。该数据集的出现,标志着数据混合优化从经验调参迈向系统性定量研究的重要一步。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

