
MohitK/indian_food_images
收藏官方服务:
资源简介:
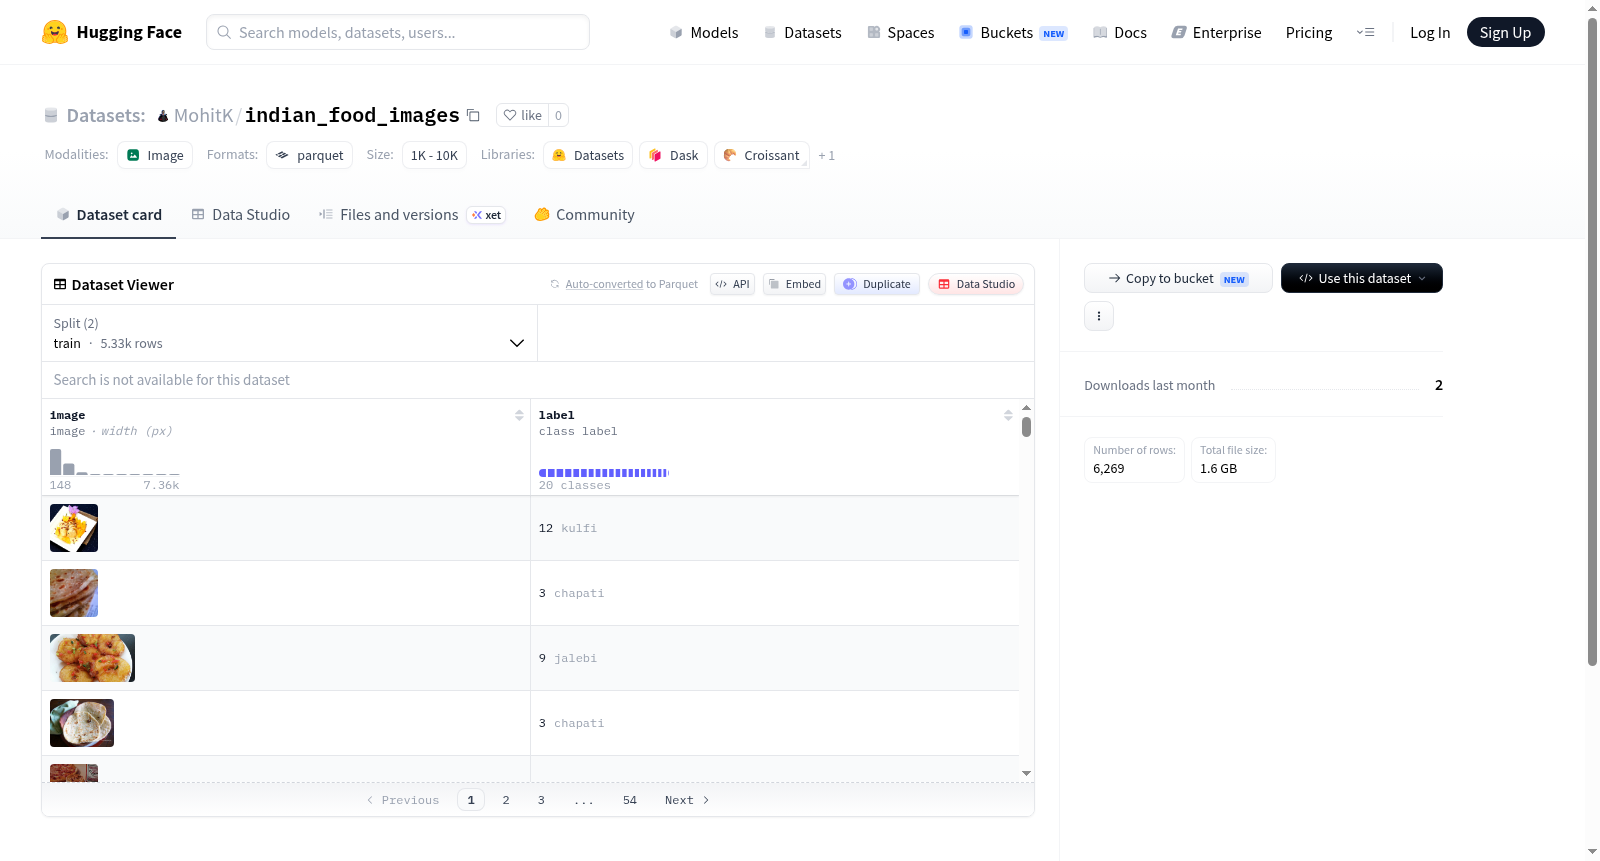
该数据集名为indian_food_images,包含印度食物的图像数据。数据集的特征包括图像和标签,标签对应不同的印度食物类别,如汉堡、黄油馕、茶等。数据集分为训练集和测试集,训练集包含5328个样本,测试集包含941个样本。此外,还提供了数据集的总下载大小和总大小。
该数据集名为indian_food_images,包含印度食物的图像数据。数据集的特征包括图像和标签,标签对应不同的印度食物类别,如汉堡、黄油馕、茶等。数据集分为训练集和测试集,训练集包含5328个样本,测试集包含941个样本。此外,还提供了数据集的总下载大小和总大小。
提供机构:
MohitK原始信息汇总
数据集概述
数据集名称
- 名称: indian_food_images
数据集特征
- 特征:
- image: 图像数据
- label: 分类标签
- 类别名称:
- 0: burger
- 1: butter_naan
- 2: chai
- 3: chapati
- 4: chole_bhature
- 5: dal_makhani
- 6: dhokla
- 7: fried_rice
- 8: idli
- 9: jalebi
- 10: kaathi_rolls
- 11: kadai_paneer
- 12: kulfi
- 13: masala_dosa
- 14: momos
- 15: paani_puri
- 16: pakode
- 17: pav_bhaji
- 18: pizza
- 19: samosa
- 类别名称:
数据集分割
- 分割:
- train:
- 样本数量: 5328
- 数据大小: 1622005508.6394334 字节
- test:
- 样本数量: 941
- 数据大小: 251982030.3925666 字节
- train:
数据集大小
- 下载大小: 1599894487 字节
- 数据集总大小: 1873987539.032 字节
搜集汇总
数据集介绍
构建方式
印度饮食文化博大精深,其丰富多样的菜肴在全球享有盛誉。为促进计算机视觉在美食识别领域的发展,研究者构建了名为MohitK/indian_food_images的数据集。该数据集通过系统收集并标注印度常见食品图像而成,涵盖20个类别,包括burger、butter_naan、chai、chapati、chole_bhature等经典菜品。数据来源广泛,经过人工筛选与清洗,确保图像质量与标签准确性。数据集划分为训练集和测试集,分别包含5328和941个样本,总大小约为1.87GB,为模型训练提供了充足的素材。
特点
该数据集具有鲜明的领域特色与实用价值。其类别覆盖了印度街头小吃、主食、甜品及饮品等多元饮食场景,如jalebi、masala_dosa、samosa等标志性食品,反映了印度饮食的多样性。图像以原始像素形式存储,标签采用整数编码,便于直接用于分类任务。数据集规模适中,训练集与测试集比例约为5.6:1,平衡了学习效率与评估可靠性。这种精心设计的结构使得该数据集成为研究印度美食识别的理想基准。
使用方法
使用该数据集时,用户可通过HuggingFace Datasets库便捷加载。首先安装datasets库,然后调用load_dataset函数指定数据集名称MohitK/indian_food_images,即可获取训练集和测试集。每个样本包含image字段(PIL Image对象)和label字段(整数类别标签)。用户可直接将其输入深度学习框架(如PyTorch或TensorFlow)进行图像分类模型训练,或结合数据增强技术提升泛化能力。此外,数据集支持自定义拆分与过滤,灵活适配不同研究需求。
背景与挑战
背景概述
印度饮食文化以其丰富的香料、地域多样性及复杂的烹饪技艺闻名于世,然而在计算机视觉领域,针对印度菜肴的细粒度图像识别研究长期滞后于西方菜系。MohitK/indian_food_images数据集由研究者Mohit K.于近年创建,旨在填补这一空白,核心研究问题聚焦于如何通过深度学习模型精准区分外观相似但风味迥异的印度美食,例如将masala_dosa与idli或chole_bhature与dal_makhani进行区分。该数据集包含5328张训练图像和941张测试图像,覆盖20个常见印度菜品类别,如samosa、pav_bhaji、jalebi等,其发布为跨文化食品图像分析提供了标准化基准,推动了多类别分类算法在亚洲食品领域的发展,并吸引了学术界对非西方饮食视觉特征挖掘的关注。
当前挑战
该数据集所解决的领域问题在于印度菜肴的视觉特征高度重叠,例如chapati与butter_naan在纹理和颜色上相似,而fried_rice与masala_dosa的形态差异细微,传统图像分类模型易因类别间模糊边界导致混淆。构建过程中面临的挑战包括:图像来源的多样性不足,部分类别(如kulfi)样本数量稀少,导致类别不平衡;数据标注依赖人工,可能存在主观偏差,例如对pizza与burger这类外来食品的界定;此外,拍摄条件(如光照、角度、背景)缺乏标准化,增加了模型泛化的难度。这些挑战要求研究者开发更鲁棒的特征提取与数据增强策略,以应对印度食品图像固有的复杂性和噪声。
常用场景
经典使用场景
该数据集汇集了20类常见印度食品的高质量图像,涵盖从街头小吃到传统主食的丰富类别,为计算机视觉领域的细粒度图像分类任务提供了极具地域特色的基准测试平台。研究者可借此探索跨文化食物识别中的视觉特征提取与类别区分策略,尤其在处理纹理复杂、色彩多样的南亚菜肴时,该数据集成为验证模型泛化能力的重要工具。
实际应用
实际应用中,该数据集可赋能智能餐饮系统的构建,例如支持手机应用程序实现拍照即识别的印度菜品推荐与营养分析,助力健康管理。此外,它还能应用于自动化厨房设备中的食材识别与烹饪指导,以及旅游场景下的文化导览服务,帮助用户快速理解陌生菜肴的名称与成分。
衍生相关工作
基于该数据集,研究者已衍生出多项经典工作,包括面向印度饮食文化的零样本食谱检索系统、融合多模态信息的菜品热量估算模型,以及针对低分辨率图像优化的轻量级分类网络。这些工作进一步拓展了数据集在跨模态学习与移动端部署等前沿领域的应用边界,巩固了其作为南亚食物视觉研究基石的地位。
以上内容由遇见数据集搜集并总结生成


