beyond/chinese_clean_passages_80m
收藏资源简介:
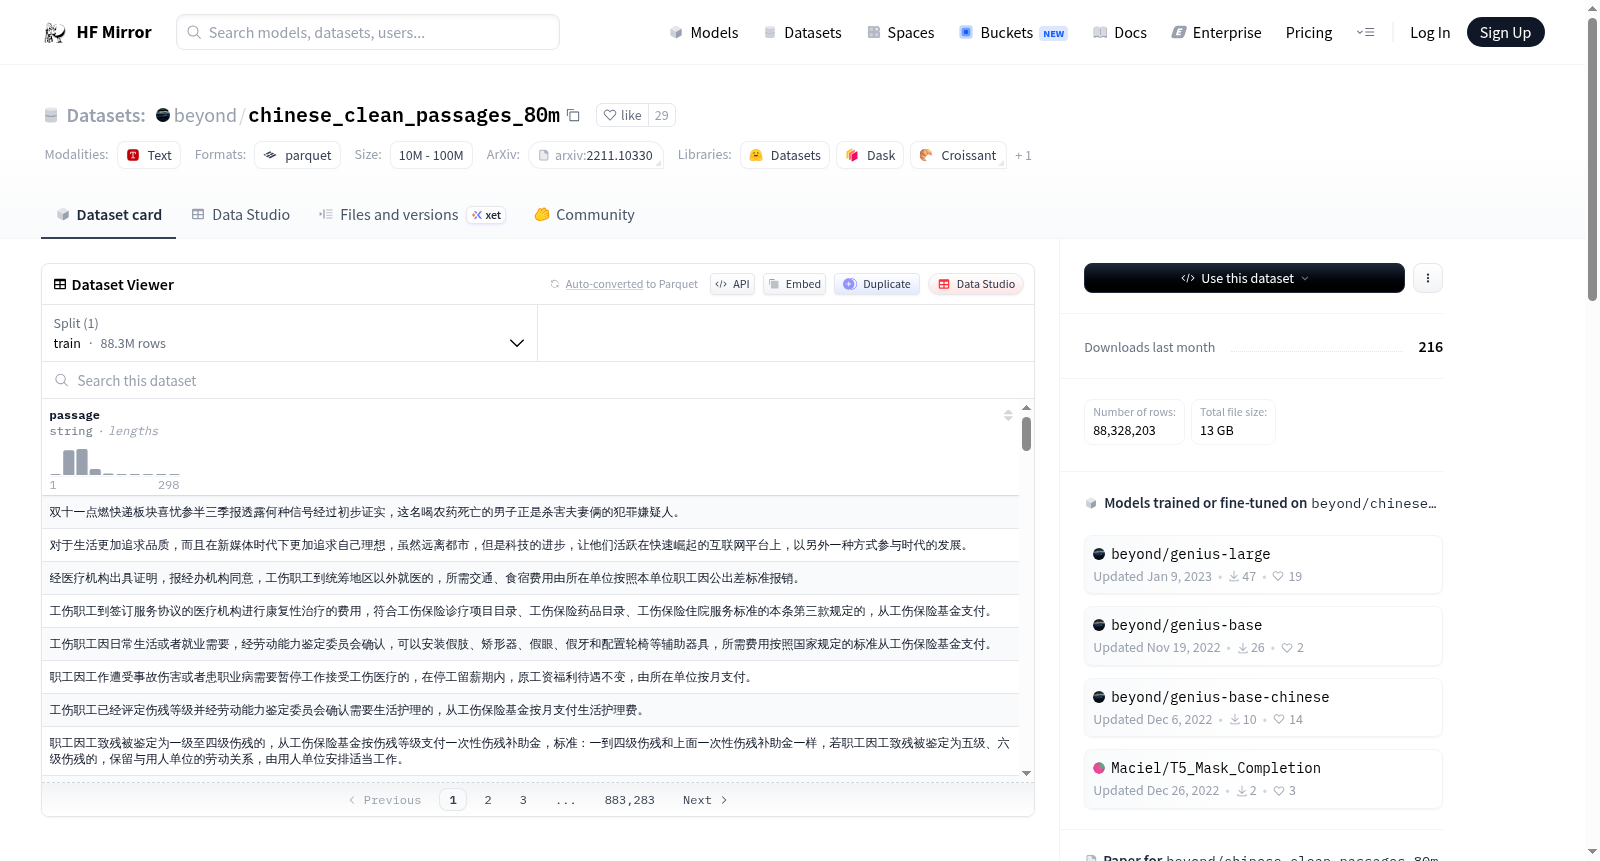
`chinese_clean_passages_80m`数据集包含超过8千万个纯净的中文段落,这些段落不包含任何字母、数字或特殊符号。段落的长度大多在50到200个汉字之间。数据集通过`datasets.load_dataset()`方法下载,会产生38个数据包,总大小约为12GB。该数据集用于训练GENIUS模型的中文版。
The `chinese_clean_passages_80m` dataset contains over 80 million clean Chinese passages that contain no letters, numbers, or special symbols. Most of these passages range from 50 to 200 Chinese characters in length. When downloaded via the `datasets.load_dataset()` method, this dataset includes 38 data packages with a total size of approximately 12 GB. This dataset is used for training the Chinese version of the GENIUS model.
数据集概述
数据集名称
chinese_clean_passages_80m
数据集描述
- 包含88328203个纯净中文段落,不包含任何字母、数字或特殊字符。
- 文本长度大部分介于50至200个汉字之间。
数据集特征
passage: 字符串类型,表示中文段落。
数据集拆分
train: 包含88328203个示例,总大小为18979214734字节。
数据集大小
- 下载大小: 1025261393字节
- 数据集总大小: 18979214734字节
数据集下载与存储
- 下载数据集将产生38个数据包,每个约340MB,总计约12GB。
数据集来源
- 基于CLUE中文预训练语料集处理和过滤得到。
原始数据集引用
@misc{bright_xu_2019_3402023, author = {Bright Xu}, title = {NLP Chinese Corpus: Large Scale Chinese Corpus for NLP }, month = sep, year = 2019, doi = {10.5281/zenodo.3402023}, version = {1.0}, publisher = {Zenodo}, url = {https://doi.org/10.5281/zenodo.3402023} }