
遇见数据集

laion/llama-nemotron-science-reasoning-on-le3000tok-100k

收藏
Hugging Face2026-06-08 更新2026-06-14 收录
官方服务:

资源简介:

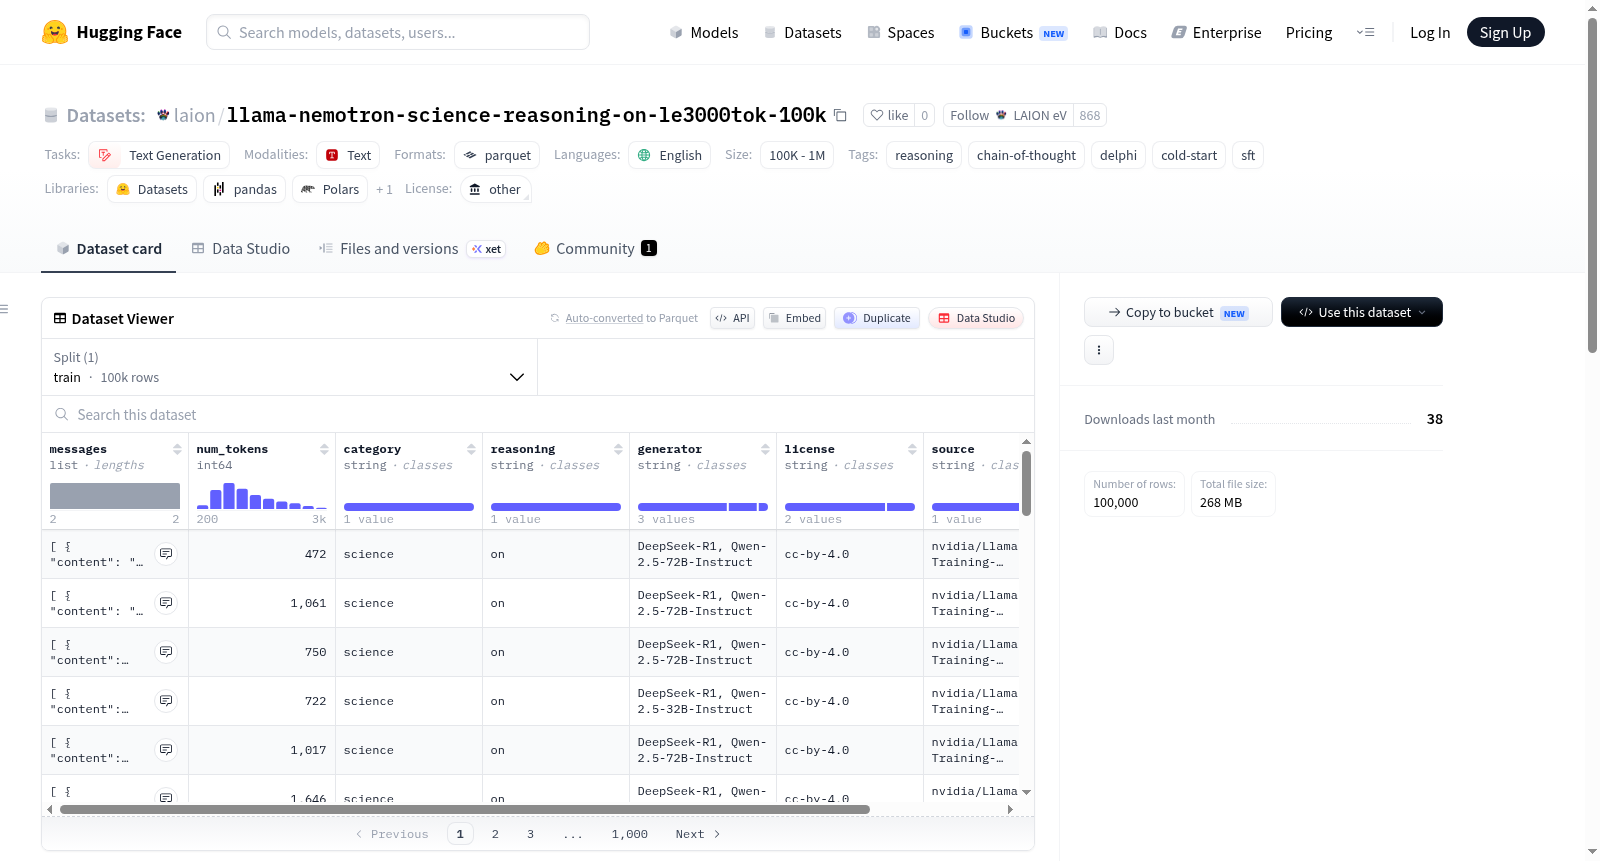
该数据集是nvidia/Llama-Nemotron-Post-Training-Dataset的一个过滤子样本,专门设计用于在冷启动监督微调(SFT)期间预热Delphi聊天模板的推理令牌(即<|start_think|>和<|end_think|>)。它是一个模板/思维链(CoT)预热切片,而非知识数据集。过滤条件包括:仅使用SFT/science子集(排除SFT/code和数学子集),仅选择推理模式为on的示例(即包含长思维链的示例),输入加输出的令牌长度不超过3000(使用Delphi/Llama-3.1分词器测量),并通过均匀随机抽样(种子为0)限制到100,000行。数据格式为ShareGPT风格的消息列表,其中助手回复包含内联的<think>...</think>块(在编码时会被规范化为标准令牌)。每行数据还包含令牌数量、类别(科学)、推理模式(on)、生成器、许可证和来源等信息。数据集派生自NVIDIA的原始数据集,许可证包括cc-by-4.0和cc-by-sa,生成器涉及DeepSeek-R1等模型。该数据集仅用于训练模板令牌和思维到答案的结构,不适用于教授新知识或数学技能。

This dataset is a filtered subsample of the nvidia/Llama-Nemotron-Post-Training-Dataset, specifically designed to warm up the inference tokens of the Delphi chat template (i.e., <|start_think|> and <|end_think|>) during cold-start supervised fine-tuning (SFT). It is a template/Chain-of-Thought (CoT) warm-up slice rather than a knowledge-focused dataset. The filtering criteria are as follows: only the SFT/science subset is used (excluding the SFT/code and mathematics subsets), only examples with inference mode set to 'on' (i.e., those containing long Chain-of-Thought content) are selected, the total token length of input plus output does not exceed 3000 (measured using the Delphi/Llama-3.1 tokenizer), and the dataset is capped at 100,000 rows via uniform random sampling with a random seed of 0. The dataset follows the ShareGPT-style message list format, where the assistant's reply contains inline <think>...</think> blocks, which will be normalized to standard tokens during encoding. Each row of data also includes metadata such as token count, category (science), inference mode (on), generator, license, and source. This dataset is derived from NVIDIA's original dataset, with licenses including CC-BY-4.0 and CC-BY-SA, and the generators involve models such as DeepSeek-R1. This dataset is solely intended for training on template tokens and the thought-to-answer structure, and is not suitable for teaching new knowledge or mathematical skills.
提供机构:
laion
搜集汇总
数据集介绍
laion/llama-nemotron-science-reasoning-on-le3000tok-100k 数据集图片
构建方式
该数据集源自NVIDIA发布的Llama-Nemotron-Post-Training-Dataset,经过严格筛选构建而成。仅保留其中SFT子集中的科学(science)类别,并过滤掉代码与数学子集,以避免引入额外的训练内容。进一步限定为开启长链推理(reasoning == 'on')的样本,确保每一条数据均包含完整的思考过程。采用Delphi/Llama-3.1分词器测量输入与输出的总长度,仅保留不超过3000词元的条目。最后通过均匀随机抽样(种子为0),从满足条件的样本中提取10万条数据,形成当前数据集。
特点
本数据集的核心特点在于其专为冷启动情境下的推理标记预热而设计。所有样本均含有'<think>...</think>'内嵌思考块,经Delphi聊天模板编码后自动转换为规范的'<|start_think|>'与'<|end_think|>'标记。数据集中在2000至3000词元的较短长度范围内,旨在高效训练模板标记与思考到答案的过渡模式,而非传授新知或数学技能。每条记录包含消息格式、词元数量、所属科学类别及推理状态等字段,来源清晰,许可协议继承自原始数据集。
使用方法
使用时,数据以ShareGPT风格的对话格式呈现,每条记录包含角色与内容的键值对,助手的回答中嵌有思考块与最终答案。开发者可直接加载该数据集,用于监督式微调流程中Delphi模型的推理标记预热训练。建议将其作为冷启动阶段的补充数据,配合LLaMA-Factory等框架使用,以激活模型在推理对话中对特殊标记的响应能力。需注意该数据集的目标并非增强知识储备或数学技能,而是专注于推理模板的安装与适配。
背景与挑战
背景概述
在大型语言模型的后训练阶段,冷启动时高效激活推理模板令牌(如<|start_think|>和<|end_think|>)是提升模型推理能力的关键技术难点。为此,NVIDIA研究团队于2025年基于其公开的Llama-Nemotron后训练数据集,构建了llama-nemotron-science-reasoning-on-le3000tok-100k数据集。该数据集由Delphi项目(marin社区)主导开发,核心目标是提供一种轻量级的链式思维(CoT)预热数据,以支持监督微调(SFT)阶段推理令牌的初始化训练。通过从原始数据集中筛选仅包含科学推理且长度不超过3000令牌的样本,并统一随机采样至10万条,该数据集在保持高推理专注度的同时,显著降低了计算开销,为后续强化学习阶段奠定了模板兼容的推理基础,对推动语言模型推理能力的后训练优化具有重要工程与学术价值。
当前挑战
该数据集所解决的领域问题在于,大语言模型在冷启动阶段直接应用推理模板时,常因令牌未被充分训练而无法生成符合预期的推理过程。此数据集通过专门设计的小规模科学推理样本,在有限预算下强制模型学习思考令牌的触发与组织模式,避免了知识注入与数学训练的干扰。构建过程中面临的挑战包括:原始数据集中的代码子集约98.6%的推理轨迹超过3000令牌的预算上限,导致其被完全排除,需依靠单一科学子集提供足够多样性;同时,为确保预热效果,需精准控制令牌长度并采用Delphi特定分词器进行度量,这增加了数据筛选与格式标准化(如将内联<think>块转换为标准模板令牌)的复杂性。此外,随机采样需平衡代表性并遵守CC-BY-4.0与CC-BY-SA等许可协议,保障数据合规性。
常用场景
经典使用场景
在大型语言模型的冷启动阶段,该数据集被精心设计为一种思维链(Chain-of-Thought)模板热身切片,其核心用途在于激活德尔菲(Delphi)对话模板中的推理标记(<|start_think|>与<|end_think|>)。通过筛选自NVIDIA Llama-Nemotron后训练数据集中科学推理子集、且仅保留推理开启且长度不超过3000令牌的样本,数据集为模型提供了简洁而高效的推理结构训练素材,使其快速习得思考与回答的衔接范式。
实际应用
在实际部署中,该数据集主要用于需要快速启动推理能力的对话系统或科学问答平台,例如NVIDIA的Delphi模型系列。开发者可借此在少量计算资源下完成冷启动训练,使模型在科学主题上具备结构化的思考与回答能力,适用于教育辅助、科研咨询或自动推理服务等场景,加速了从通用预训练到领域特定推理应用的工程落地。
衍生相关工作
该数据集衍生自NVIDIA Llama-Nemotron后训练数据集,并催生了关于冷启动推理标记训练的系列工作。其过滤逻辑(如长度截断与领域选择)启发了后续研究,例如探索更高效的推理模板初始化方法、基于不同标记器适配的跨模型迁移策略,以及科学推理与其他领域(如代码、数学)的差异化热身方案。这些工作共同推进了大语言模型推理能力的精细调优与模块化训练框架的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

