ai4privacy/pii-masking-43k
收藏资源简介:
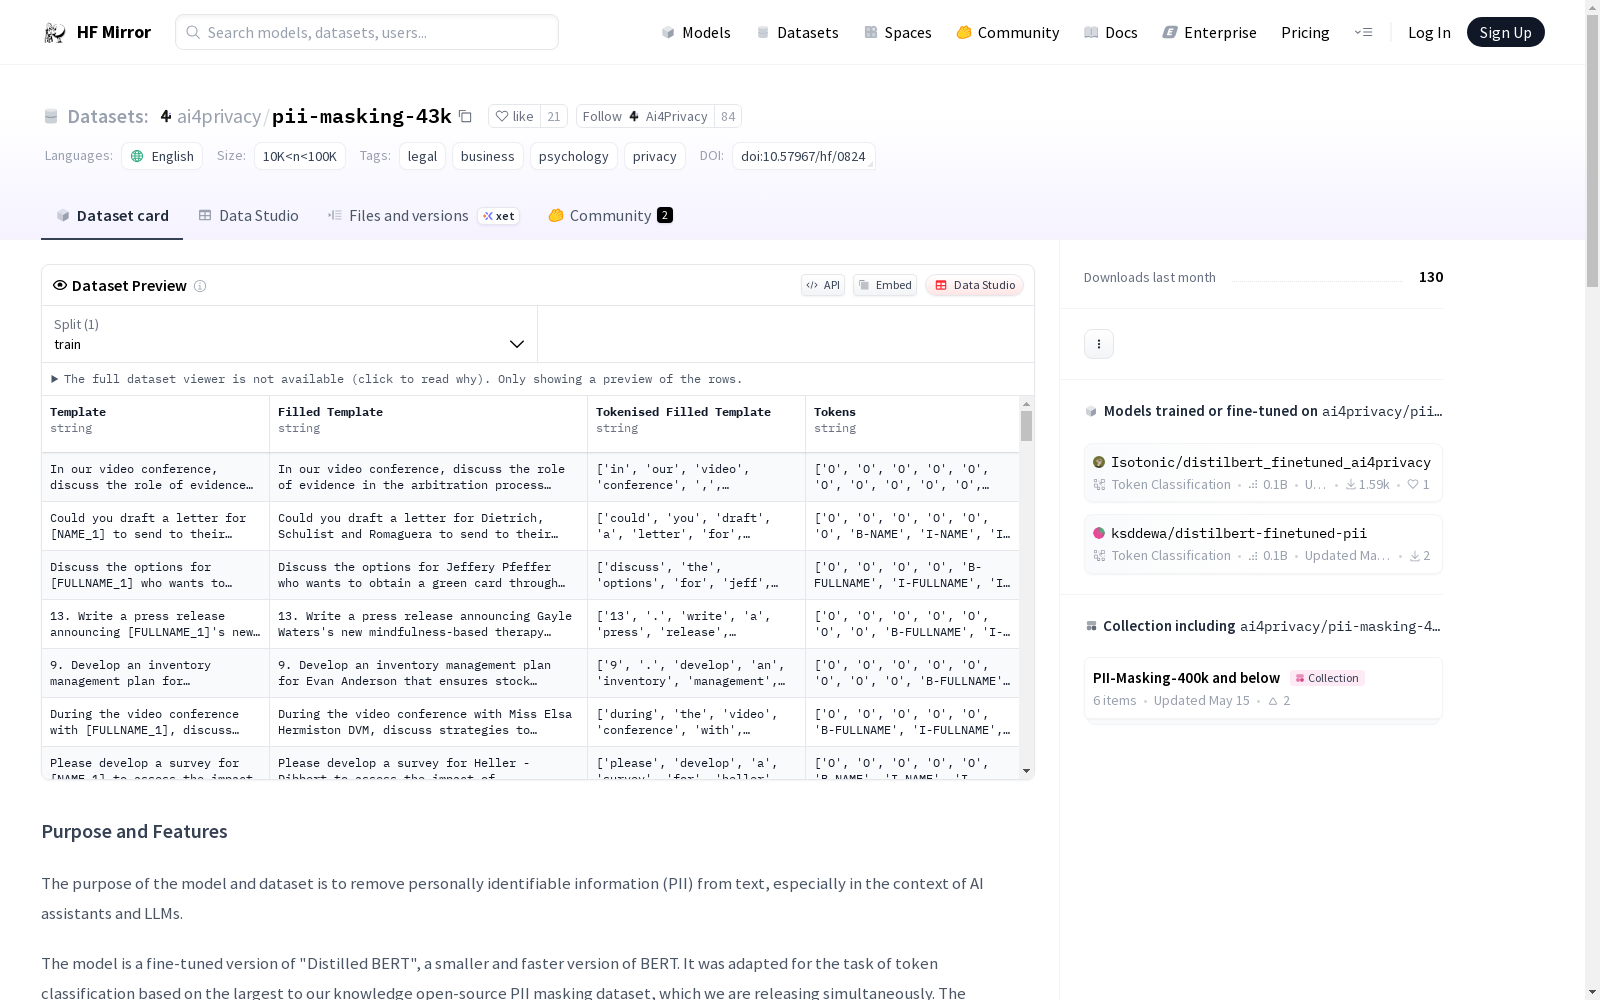
该数据集的主要目的是从文本中移除个人可识别信息(PII),特别是在AI助手和大型语言模型(LLMs)的背景下。数据集包含约43,000条观察数据,每条数据以自然语言句子开始,句子中包含PII的占位符,并用模拟的个人信息填充,然后使用BERT分词器进行分词,并标记出与PII对应的分词作为训练模型的真实标签。数据集涵盖了PII可能出现的多种上下文,包括商业、心理学和法律领域,以及5种交互风格。
The primary purpose of this dataset is to remove Personally Identifiable Information (PII) from text, particularly in the context of AI assistants and Large Language Models (LLMs). The dataset contains approximately 43,000 observations. Each entry starts with a natural language sentence that contains placeholders for PII, which are filled with simulated personal information. The sentences are then tokenized using the BERT tokenizer, and the tokens corresponding to PII are labeled as the ground truth for model training. The dataset covers a wide range of contexts where PII may appear, including commercial, psychological, and legal domains, as well as five interaction styles.
数据集概述
数据集目的与特征
- 目的:移除文本中的个人身份信息(PII),特别是在AI助手和大型语言模型(LLMs)的上下文中。
- 模型:基于“Distilled BERT”的微调版本,专为标记分类任务设计,模型大小为6200万参数,压缩后大小为43MB。
- 数据集构成:约43,000个观测值,每个观测值包含一个包含PII占位符的自然语言句子,随后填充模拟的个人信息并使用BERT分词器进行分词。
- 数据集覆盖范围:涉及54种敏感数据类型,约111个标记类别,涵盖125个讨论主题/用例,跨越商业、心理学和法律领域,以及5种交互风格。
数据集关键事实
- 当前规模:560万标记,包含43,000个PII示例。
- 未来扩展:计划扩展至10万示例。
- 验证方式:通过人机交互验证。
- 数据生成:使用专有算法生成的合成数据。
- 模型框架:基于PyTorch。
- 量化级别:8位量化。
性能评估
- 测试精度:0.998636
- 测试召回率:0.998945
- 测试准确率:0.994621
- 训练/测试集分割:4300个测试示例(10%),38,700个训练示例。
应用场景
- 聊天机器人
- 客户支持系统
- 电子邮件过滤
- 数据匿名化
- 社交媒体平台
- 内容审核
- 在线表单
- 协作文档编辑
- 研究和数据共享
- 内容生成
支持与维护
- 项目隶属:AI4Privacy项目隶属于AISuisse SA。