surindersinghssj/sgpc-amritsar-kirtan-live
收藏资源简介:
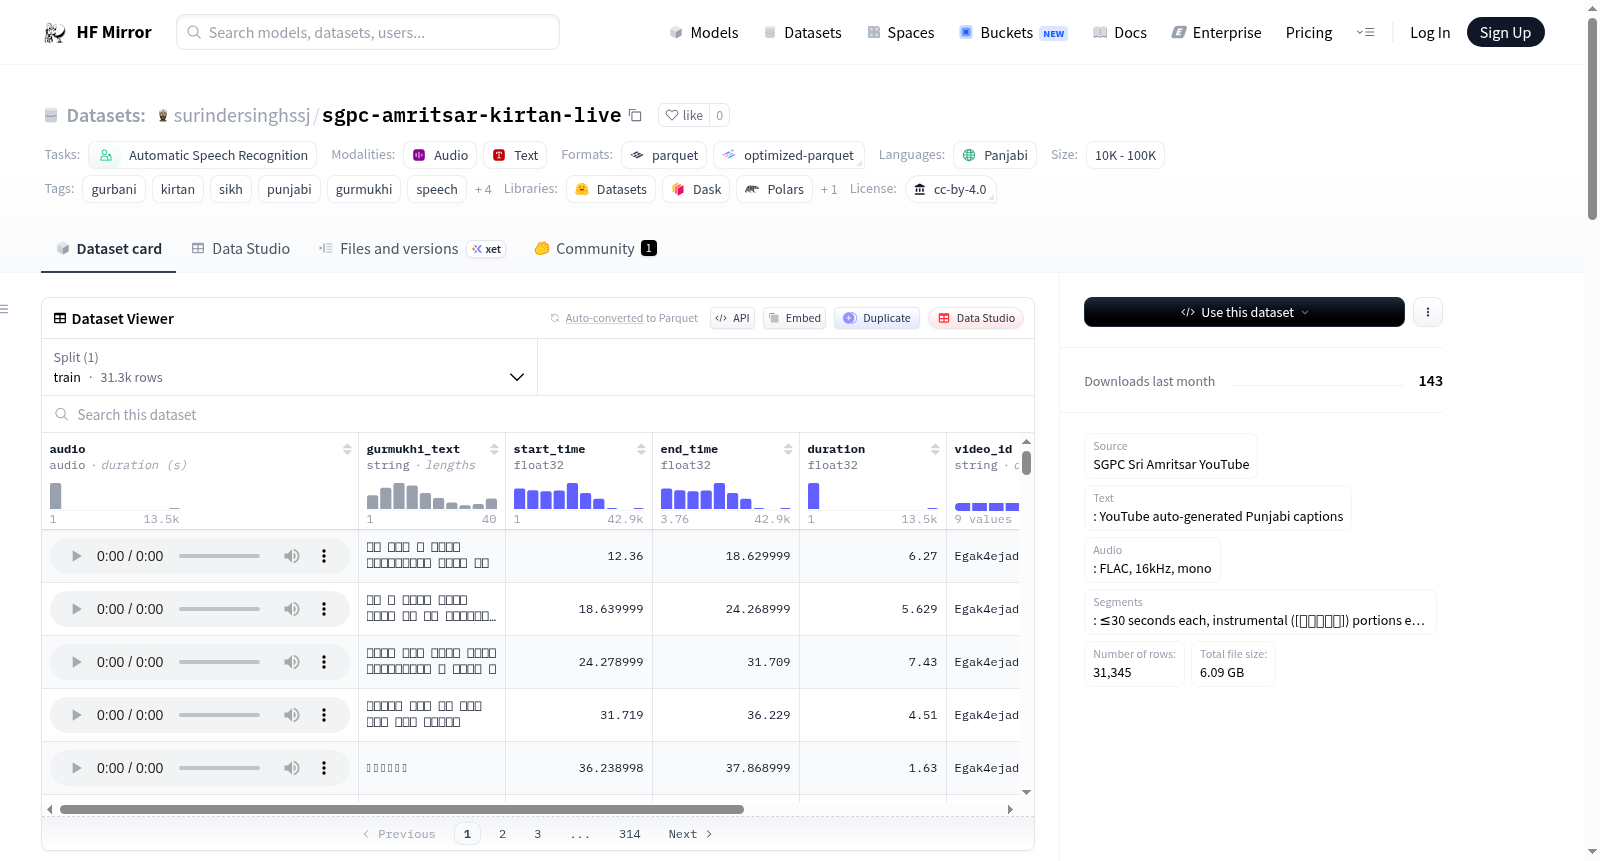
--- language: - pa license: cc-by-4.0 task_categories: - automatic-speech-recognition tags: - gurbani - kirtan - sikh - punjabi - gurmukhi - speech - music - golden-temple - sgpc - live-kirtan size_categories: - 100K<n<1M --- # SGPC Amritsar Live Kirtan Dataset Live Gurbani Kirtan audio dataset from Sachkhand Sri Harmandir Sahib (Golden Temple, Amritsar), sourced from SGPC's official YouTube channel. Each row contains a ≤30-second audio segment paired with Punjabi (Gurmukhi) caption text. ## Dataset Description - **Source**: [SGPC Sri Amritsar YouTube](https://www.youtube.com/@SGPCSriAmritsar) - **Text**: YouTube auto-generated Punjabi captions - **Audio**: FLAC, 16kHz, mono - **Segments**: ≤30 seconds each, instrumental ([ਸੰਗੀਤ]) portions excluded ## Statistics | Metric | Value | |--------|-------| | Total segments | 625,792 | | Total audio | 804.1 hours | | Videos | 241 | | Avg segment duration | 4.6s | | Audio format | FLAC, 16kHz, mono | | Language | Punjabi (Gurmukhi) | ## Splits | Split | Segments | |-------|----------| | train | 586,859 | | validation | 22,667 | | test | 16,266 | Splits are by **video ID** (not segment) to prevent data leakage. ## Data Fields | Field | Type | Description | |-------|------|-------------| | `audio` | Audio | FLAC audio segment (16kHz mono) | | `gurmukhi_text` | string | Punjabi caption text (Gurmukhi script) | | `start_time` | float | Start time in source video (seconds) | | `end_time` | float | End time in source video (seconds) | | `duration` | float | Segment duration (seconds) | | `video_id` | string | YouTube video ID | | `video_title` | string | Video title | | `channel` | string | Source channel name | ## Usage ```python from datasets import load_dataset ds = load_dataset("surindersinghssj/sgpc-amritsar-kirtan-live") # Listen to a sample sample = ds["train"][0] print(sample["gurmukhi_text"]) # Audio is directly playable in the HF dataset viewer ``` ## Pipeline 1. Download audio-only from YouTube using yt-dlp 2. Download Punjabi auto-generated captions (VTT format) 3. Parse captions, filter out [ਸੰਗੀਤ] (music) segments 4. Keep only Gurmukhi text (>50% Gurmukhi characters) 5. Group consecutive captions into ≤30s chunks 6. Extract audio segments as FLAC 16kHz mono ## License CC-BY-4.0 ## Citation ```bibtex @dataset{sgpc_kirtan_live, title={SGPC Amritsar Live Kirtan Dataset}, author={Surinder Singh}, year={2026}, url={https://huggingface.co/datasets/surindersinghssj/sgpc-amritsar-kirtan-live} } ```
--- 语言: - 旁遮普语(pa) 许可协议:知识共享署名4.0协议(CC-BY-4.0) 任务类别: - 自动语音识别(Automatic Speech Recognition) 标签: - 古尔巴尼(Gurbani) - 基尔坦(Kirtan) - 锡克教(Sikh) - 旁遮普语(Punjabi) - 果鲁穆奇文(Gurmukhi) - 语音 - 音乐 - 金庙(Golden Temple) - SGPC(Sri Gurudwara Prabandhak Committee) - 现场基尔坦(Live-Kirtan) 样本规模: - 10万<样本数量<100万 --- # SGPC阿姆利则现场基尔坦数据集 本数据集采集自阿姆利则 Sachkhand Sri Harmandir Sahib(金庙,阿姆利则)的现场古尔巴尼基尔坦音频,数据来源为SGPC官方YouTube频道。每条数据对应一段时长不超过30秒的音频片段,并搭配旁遮普语(果鲁穆奇文)字幕文本。 ## 数据集详情 - **数据来源**:[SGPC斯里阿姆利则YouTube频道](https://www.youtube.com/@SGPCSriAmritsar) - **文本数据**:YouTube自动生成的旁遮普语字幕 - **音频格式**:无损音频编码格式FLAC(Free Lossless Audio Codec)、16kHz采样率、单声道 - **音频片段**:单段时长≤30秒,已过滤器乐([ਸੰਗੀਤ])片段 ## 统计信息 | 指标 | 数值 | |--------|-------| | 总片段数 | 625,792 | | 总音频时长 | 804.1小时 | | 源视频数 | 241 | | 平均片段时长 | 4.6秒 | | 音频格式 | FLAC、16kHz采样率、单声道 | | 语言 | 旁遮普语(果鲁穆奇文) | ## 数据集划分 | 划分集 | 片段数 | |-------|----------| | 训练集 | 586,859 | | 验证集 | 22,667 | | 测试集 | 16,266 | 数据集划分依据**视频ID**(而非单个片段),以避免数据泄露。 ## 数据字段说明 | 字段名 | 数据类型 | 字段说明 | |-------|------|-------------| | `audio` | 音频 | FLAC格式音频片段(16kHz采样率、单声道) | | `gurmukhi_text` | 字符串 | 旁遮普语字幕文本(果鲁穆奇文书写) | | `start_time` | 浮点数 | 源视频中的片段起始时间(单位:秒) | | `end_time` | 浮点数 | 源视频中的片段结束时间(单位:秒) | | `duration` | 浮点数 | 片段时长(单位:秒) | | `video_id` | 字符串 | YouTube视频ID | | `video_title` | 字符串 | 视频标题 | | `channel` | 字符串 | 来源频道名称 | ## 快速使用示例 python from datasets import load_dataset ds = load_dataset("surindersinghssj/sgpc-amritsar-kirtan-live") # 试听示例样本 sample = ds["train"][0] print(sample["gurmukhi_text"]) # 音频可直接在Hugging Face数据集查看器中播放 ## 数据处理流程 1. 使用yt-dlp工具从YouTube下载纯音频文件 2. 下载旁遮普语自动生成字幕(WebVTT格式,简称VTT) 3. 解析字幕文本,过滤掉包含[ਸੰਗੀਤ](器乐)的片段 4. 仅保留果鲁穆奇文字符占比超过50%的文本 5. 将连续的字幕合并为时长不超过30秒的片段块 6. 提取音频片段并转换为FLAC格式(16kHz采样率、单声道) ## 许可协议 知识共享署名4.0协议(CC-BY-4.0) ## 引用格式 bibtex @dataset{sgpc_kirtan_live, title={SGPC阿姆利则现场基尔坦数据集}, author={Surinder Singh}, year={2026}, url={https://huggingface.co/datasets/surindersinghssj/sgpc-amritsar-kirtan-live} }