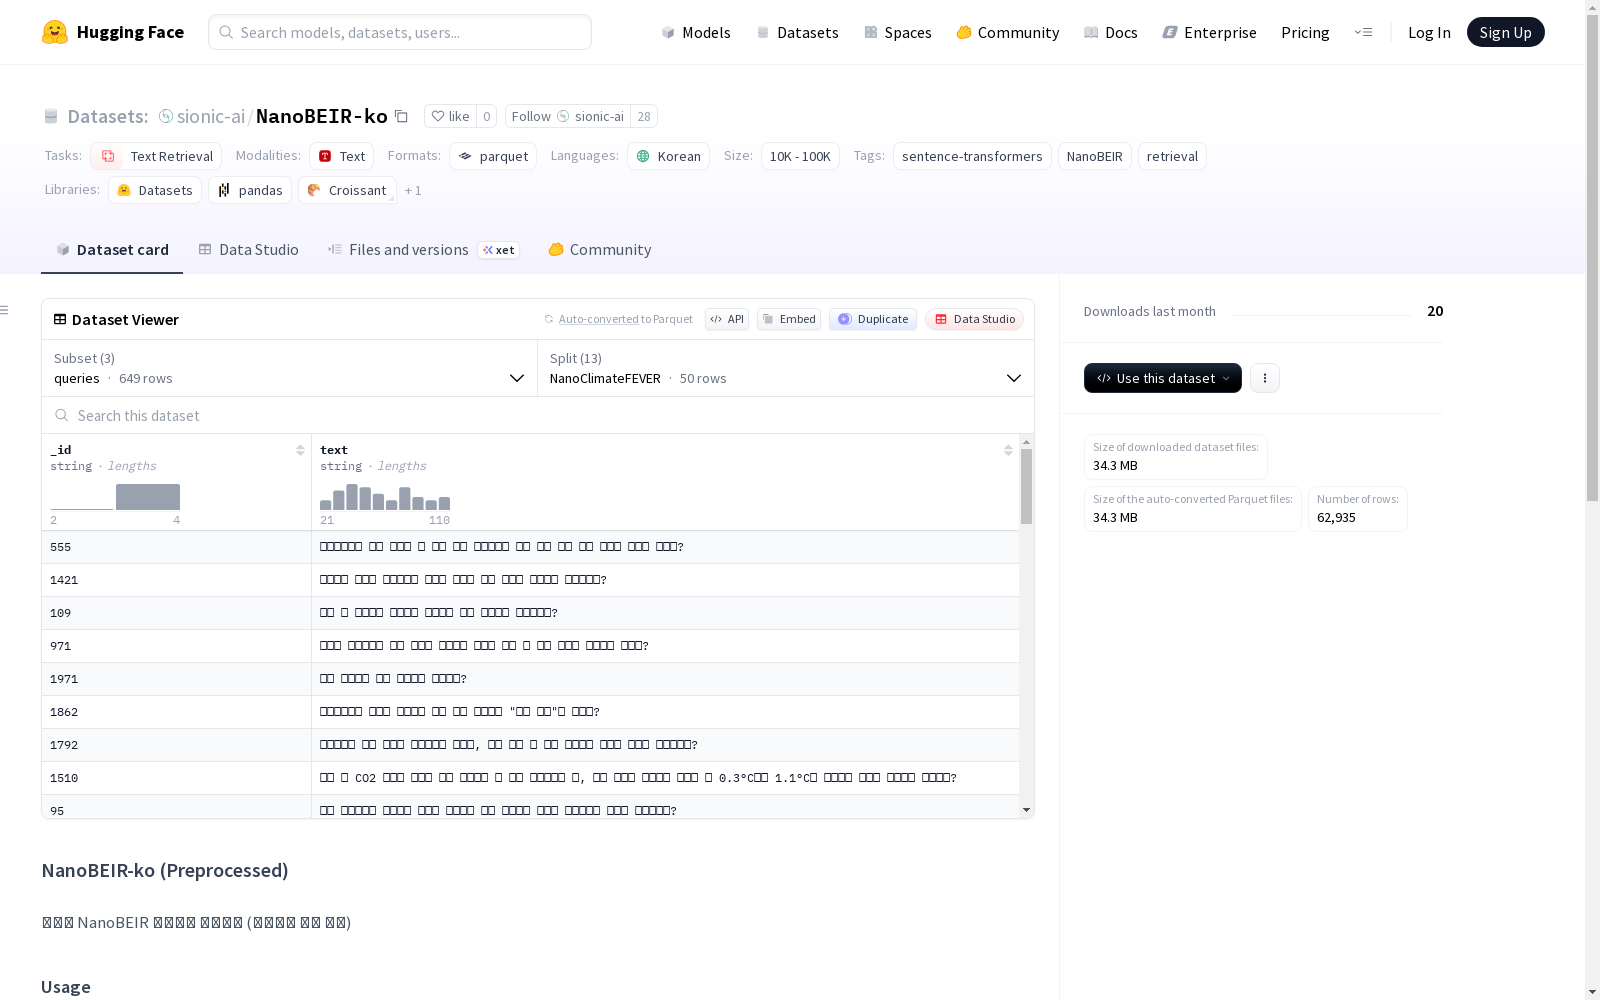
NanoBEIR-ko
收藏资源简介:
NanoBEIR-ko是一个韩语的NanoBEIR基准数据集,包含预处理过的查询。该数据集主要用于文本检索任务,包含三个主要配置:语料库(corpus)、查询相关文档(qrels)和查询(queries)。数据集包含多个子集,如NanoClimateFEVER、NanoDBPedia等,每个子集都有详细的字节数和示例数。预处理流程包括格式检测与转换(如将STATEMENT转换为QUESTION)以及质量验证与修复。
NanoBEIR-ko is a Korean-language NanoBEIR benchmark dataset containing preprocessed queries. It is primarily designed for text retrieval tasks and includes three core configurations: corpus, qrels, and queries. The dataset comprises multiple subsets such as NanoClimateFEVER and NanoDBPedia, with each subset featuring detailed byte counts and example counts. The preprocessing workflow covers format detection and conversion (e.g., converting STATEMENT to QUESTION) as well as quality validation and repair.
NanoBEIR-ko 数据集概述
数据集基本信息
- 数据集名称:NanoBEIR-ko (Preprocessed)
- 托管地址:https://huggingface.co/datasets/sionic-ai/NanoBEIR-ko
- 主要语言:韩语 (ko)
- 任务类别:文本检索 (text-retrieval)
- 相关标签:sentence-transformers, NanoBEIR, retrieval
数据集结构与配置
数据集包含三个独立的配置(config),每个配置下包含多个数据子集(split)。
1. 语料库配置 (corpus)
- 用途:存储检索文档/段落。
- 特征:
_id:字符串类型,文档标识符。text:字符串类型,文档文本内容。
- 子集与规模:
子集名称 示例数量 数据大小(字节) NanoClimateFEVER 3408 3,591,837 NanoDBPedia 6045 1,696,874 NanoFEVER 4996 4,468,102 NanoFiQA2018 4598 2,919,833 NanoHotpotQA 5090 1,454,406 NanoMSMARCO 5043 1,223,067 NanoNFCorpus 2953 2,617,249 NanoNQ 5035 2,012,592 NanoQuoraRetrieval 5046 273,698 NanoSCIDOCS 2210 1,355,295 NanoArguAna 3635 2,467,897 NanoSciFact 2919 2,559,907 NanoTouche2020 5745 7,492,610 - 总下载大小:34,133,367 字节
- 总数据集大小:34,133,367 字节
2. 查询配置 (queries)
- 用途:存储检索查询。
- 特征:
_id:字符串类型,查询标识符。text:字符串类型,查询文本内容。
- 子集与规模:
子集名称 示例数量 数据大小(字节) NanoClimateFEVER 50 7,977 NanoDBPedia 50 4,269 NanoFEVER 50 4,942 NanoFiQA2018 50 5,162 NanoHotpotQA 50 7,662 NanoMSMARCO 50 4,091 NanoNFCorpus 50 3,427 NanoNQ 50 4,833 NanoQuoraRetrieval 50 4,919 NanoSCIDOCS 50 7,526 NanoArguAna 50 41,933 NanoSciFact 50 6,480 NanoTouche2020 49 4,019 - 总下载大小:107,240 字节
- 总数据集大小:107,240 字节
3. 相关性判断配置 (qrels)
- 用途:存储查询与相关文档的对应关系。
- 特征:
query-id:字符串类型,查询ID。corpus-id:字符串类型,相关文档ID。
- 子集与规模:
子集名称 示例数量 数据大小(字节) NanoClimateFEVER 148 4,217 NanoDBPedia 1158 22,607 NanoFEVER 57 3,188 NanoFiQA2018 123 3,118 NanoHotpotQA 100 3,861 NanoMSMARCO 50 2,571 NanoNFCorpus 2518 13,680 NanoNQ 57 2,493 NanoQuoraRetrieval 70 2,749 NanoSCIDOCS 244 14,384 NanoArguAna 50 3,816 NanoSciFact 56 2,562 NanoTouche2020 932 18,062 - 总下载大小:97,308 字节
- 总数据集大小:97,308 字节
数据预处理流程
数据集经过了特定的预处理流程,旨在优化查询格式以用于检索任务。
- 第一阶段:格式检测与转换
- 使用模型:Gemini 2.5 Flash
- 步骤:将查询分类为QUESTION(问题)、KEYWORD(关键词)、STATEMENT(陈述句),并将STATEMENT格式转换为QUESTION格式。
- 第二阶段:质量验证与修正
- 使用模型:GPT-4o
- 步骤:检测不恰当的修正并进行重新修正。
使用示例
加载数据集的Python代码示例如下: python from datasets import load_dataset queries = load_dataset("sionic-ai/NanoBEIR-ko", "queries", split="NanoClimateFEVER") corpus = load_dataset("sionic-ai/NanoBEIR-ko", "corpus", split="NanoClimateFEVER") qrels = load_dataset("sionic-ai/NanoBEIR-ko", "qrels", split="NanoClimateFEVER")
预处理示例
预处理将原始陈述句查询转换为疑问句格式。
| 子集 | 原始查询 | 预处理后查询 |
|---|---|---|
| NanoClimateFEVER | 알래스카에서 갈색 곰들은 더 일찍 익는 엘더베리를 먹기 위해 먹이 섭취 습관을 바꾸고 있다. | 알래스카에서 갈색 곰들은 더 일찍 익는 엘더베리를 먹기 위해 먹이 섭취 습관을 바꾸고 있나요? |
| NanoClimateFEVER | 극지방의 빙하와 고산지대의 평원이 녹으면 메탄 가스가 위험하게 방출될 수 있다. | 극지방의 빙하와 고산지대의 평원이 녹으면 메탄 가스가 위험하게 방출될까요? |
| NanoClimateFEVER | 해빙은 과학자들과 기후 모델이 예상했던 것보다 훨씬 더 빠른 속도로 줄어들고 있다. | 해빙은 과학자들과 기후 모델이 예상했던 것보다 훨씬 더 빠른 속도로 줄어들고 있나요? |
| NanoClimateFEVER | 풍력 에너지의 탄소 발자국은 상당하다. | 풍력 에너지의 탄소 발자국은 상당한가? |