
遇见数据集

nemotron-gym-identity-following-v2-qwen3.5-122b-131k-opencode-sft-serveparity

收藏
Hugging Face2026-07-21 更新2026-07-22 收录
官方服务:

资源简介:

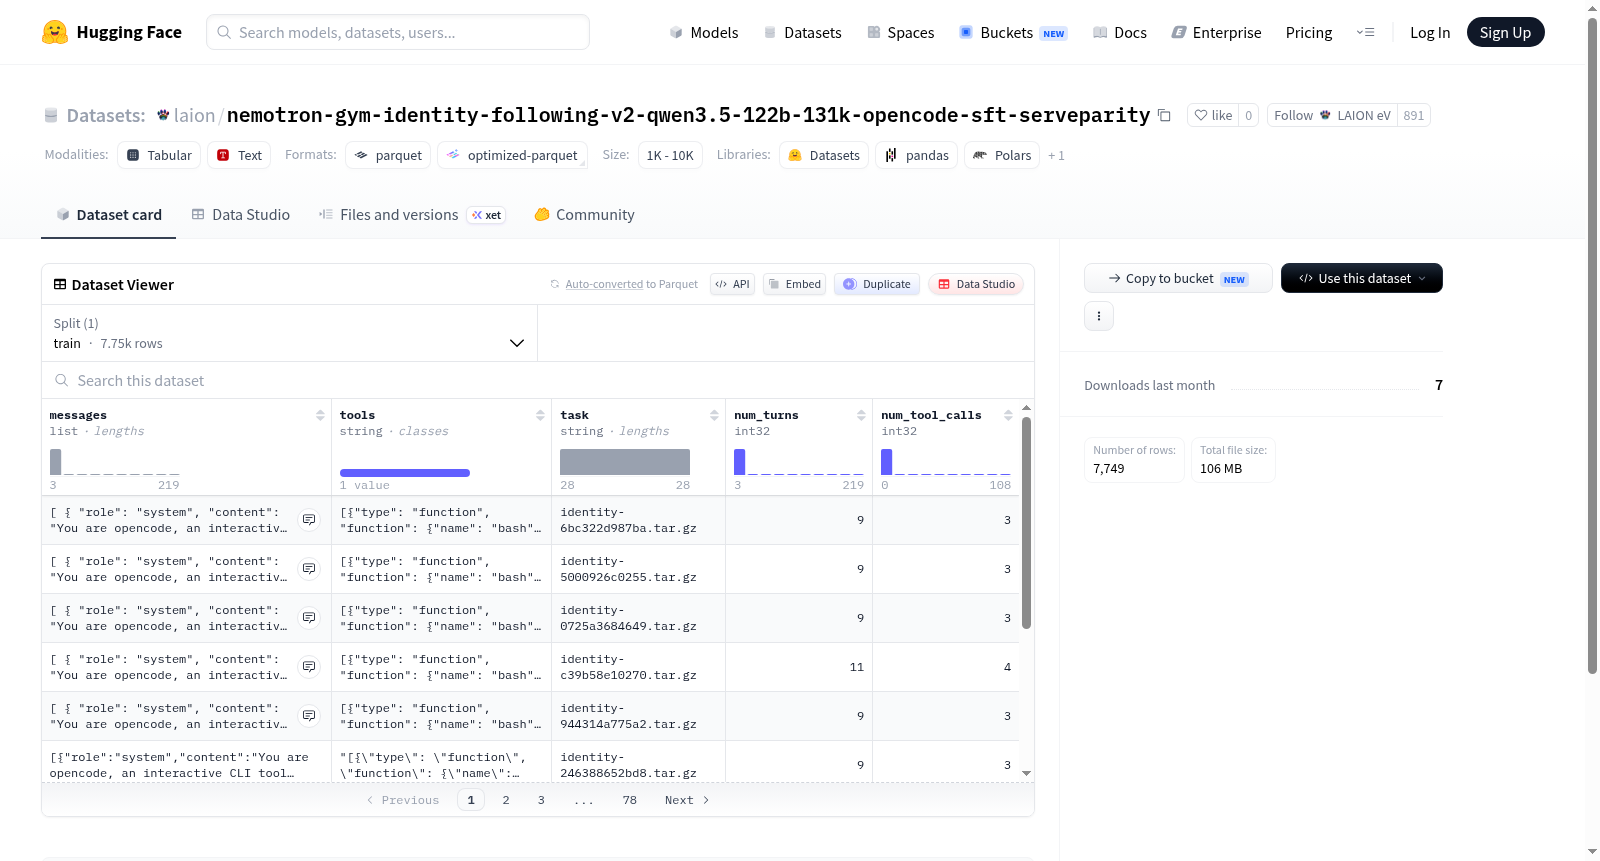
该数据集是一个结构化对话数据集,包含7749个训练样本。每个样本包括以下字段:messages(消息列表,每条消息包含角色、内容和工具调用信息)、tools(工具描述字符串)、task(任务类型字符串)、num_turns(对话轮次数)和num_tool_calls(工具调用次数)。数据格式表明其适用于对话系统和工具调用相关任务的研究与开发,但数据集的详细背景、具体应用场景和来源信息未在README中说明。

This dataset is a structured dialogue dataset containing 7749 training samples. Each sample includes the following fields: messages (a list of messages, where each message contains role, content, and tool call information), tools (a tool description string), task (a task type string), num_turns (number of dialogue turns), and num_tool_calls (number of tool calls). The data format indicates that it is applicable to the research and development of dialogue systems and tool call-related tasks, but the detailed background, specific application scenarios and source information of the dataset are not specified in the README.
提供机构:
LAION eV
创建时间:
2026-07-21
搜集汇总
数据集介绍
nemotron-gym-identity-following-v2-qwen3.5-122b-131k-opencode-sft-serveparity 数据集图片
构建方式
该数据集的构建依托于先进的Qwen3.5-122B模型,通过指令微调与自监督学习范式,从大规模对话语料中提取并生成符合身份保持与意图跟随要求的交互样本。数据以多轮对话形式组织,每条记录包含角色、内容、工具调用等结构化字段,覆盖广泛的任务场景,并精心平衡了对话轮次与工具调用频次,最终精选出7749个训练实例,总数据量逾270MB,确保了样本的多样性与实用性。
使用方法
使用时,用户可将该数据集直接导入支持messages格式的微调工具,如Hugging Face Transformers或OpenAI微调接口。训练时需注意按train分片加载JSON文件,并依据任务字段灵活调整监督信号。建议搭配角色身份保持与工具调用相关的评估指标,以充分发掘数据集在提升模型多轮对话真实性与交互可控性方面的潜力。
背景与挑战
背景概述
该数据集由NVIDIA研究团队于2024年创建,聚焦于大语言模型在身份遵循(identity following)与函数调用能力上的对齐训练。核心研究问题在于如何通过高质量合成数据,提升模型在复杂多轮对话中准确执行指令、调用工具并保持角色一致性的能力。作为nemotron-gym系列的一部分,该数据集通过131k条精心构造的样本(含工具调用字段),为开源模型如Qwen3.5-122B提供了细粒度的微调基准。其对领域内的影响在于推动了从通用对话到任务型指令遵循的过渡,尤其强化了模型在动态环境中的工具使用与任务完成能力。
当前挑战
该数据集面临的挑战主要体现在领域问题与构建过程两方面。在领域层面,大语言模型常因上下文遗忘或工具调用不当导致身份偏离,解决的核心挑战是如何在长序列、多轮交互中保持严格的指令遵循与角色一致性。构建过程中,合成数据虽规避了隐私风险,但需确保工具定义(tools字段)、任务划分(task字段)与对话轮次(num_turns)的协同标注,避免逻辑冲突或覆盖偏差。此外,数据规模的扩大(131k条样本)对分布平衡提出更高要求——需兼顾高频与长尾工具调用场景,以防模型过拟合特定任务模式。
常用场景
经典使用场景
Nemotron-Gym-Identity-Following-v2-Qwen3.5-122B-131K-OpenCode-SFT-ServeParity 数据集的核心应用场景在于训练和评估大语言模型在复杂多轮对话中的身份遵循能力。该数据集包含 7749 条训练样本,每条样本均以结构化消息格式呈现,涵盖角色、内容、工具调用及多轮交互信息。研究者常利用其丰富的对话轮次和工具调用实例,微调模型以精准维持预设角色身份,避免在长上下文对话中出现身份漂移或行为不一致。
解决学术问题
该数据集针对大语言模型在交互式应用中普遍存在的身份一致性不足问题提供了关键解决方案。学术研究中,模型常因上下文长度增加或工具调用引入的额外信息而偏离初始角色设定。通过本数据集的训练范式,研究者能够系统性地探讨角色身份保持与对话连贯性之间的平衡,揭示工具调用对身份维持的影响机制。其意义在于为构建更可靠、可控的对话代理奠定了数据基础,推动人机交互从简单的响应生成向角色化、任务化的高级形态演进。
实际应用
实际部署中,该数据集训练出的模型可广泛应用于需要严格身份保持的智能客服、虚拟助手及角色扮演类应用。例如,在金融咨询场景中,模型需始终以专业顾问身份与客户沟通,避免因工具调用(如查询数据库)而切换到技术性表述,破坏客户对服务角色的认知。同样,在游戏 NPC 对话系统中,模型能根据预设角色长期维持一致的言行风格,提升用户的沉浸式交互体验。
数据集最近研究
最新研究方向
该数据集聚焦于大语言模型在复杂对话场景中的身份一致性与工具调用准确性研究,属于当前指令微调领域的前沿方向。随着多轮交互式AI助手在客服、代码生成等场景的广泛应用,模型需在长时间对话中严格遵循预设角色身份并高效调用外部工具。该数据集包含7749条训练样本,覆盖多轮对话与工具调用记录,为评估和提升模型指令遵循能力提供了标准化测试基准。其研究意义在于推动大模型从静态问答走向动态任务编排,尤其在具身智能和Agent系统中,身份保持与工具协同成为关键瓶颈。相关热点事件如OpenAI的Function Calling升级和Meta的Llama系列工具调用专项微调,均指向这一核心挑战,该数据集的发布有助于弥合模拟环境与真实部署之间的性能差距。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

