2026-08-21-difficult-advice-v2-chunk-only-smoke
收藏资源简介:
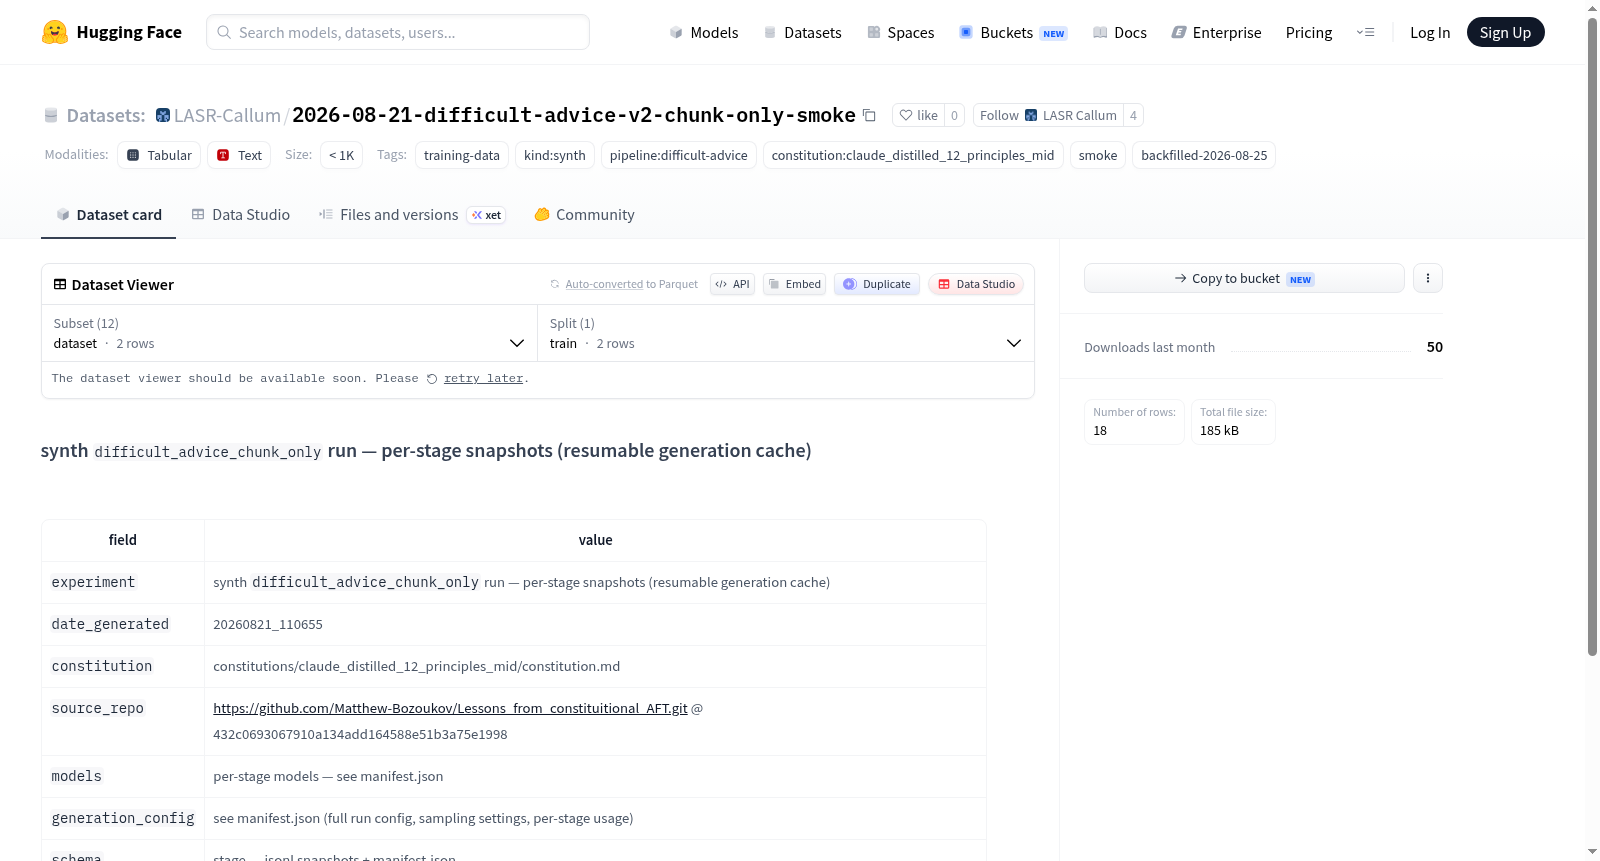
该数据集是一个名为difficult_advice_chunk_only的合成数据集,用于训练数据。它包含通过多阶段生成pipeline产生的快照,每个阶段对应一个JSONL文件,并支持恢复生成缓存。数据集基于claude_distilled_12_principles_mid宪法(constitution)生成,来源仓库为GitHub上的Matthew-Bozoukov/Lessons_from_constituitional_AFT。数据集的阶段包括:stage_1_chunk_constitution(分块宪法)、stage_2_write_scenarios(编写场景)、stage_3_dedupe_scenarios(去重场景)、stage_4_draft_prompts(草稿提示)、stage_5_revise_prompts(修订提示,包括partial版本)、stage_6_draft_responses(草稿响应,包括partial版本)、stage_7_revise_responses(修订响应,包括partial版本)和stage_8_export_sft(导出SFT数据)。此外,还包含一个默认的dataset配置,对应dataset.jsonl文件。标签表明该数据集是合成数据,属于training-data类型,pipeline为difficult-advice,并带有smoke测试标记,回溯日期为2026-08-25。
This dataset is a synthetic dataset named difficult_advice_chunk_only, used for training data. It contains snapshots generated through a multi-stage generation pipeline, with each stage corresponding to a JSONL file, and supports resume generation cache. The dataset is generated based on the claude_distilled_12_principles_mid constitution, sourced from the GitHub repository Matthew-Bozoukov/Lessons_from_constituitional_AFT. The stages of the dataset include: stage_1_chunk_constitution, stage_2_write_scenarios, stage_3_dedupe_scenarios, stage_4_draft_prompts, stage_5_revise_prompts (including partial version), stage_6_draft_responses (including partial version), stage_7_revise_responses (including partial version), and stage_8_export_sft. Additionally, there is a default dataset configuration corresponding to the dataset.jsonl file. Labels indicate that the dataset is synthetic data, of type training-data, with pipeline difficult-advice, and carries a smoke test flag, with a backdate of 2026-08-25.
数据集概述
该数据集是名为 difficult_advice_chunk_only 的合成数据生成实验的产物,记录了从原始文本分块到最终 SFT(监督微调)数据导出的完整流水线各阶段的快照缓存,支持断点续跑。
基本信息
| 属性 | 值 |
|---|---|
| 实验名称 | synth difficult_advice_chunk_only run — per-stage snapshots (resumable generation cache) |
| 生成日期 | 20260821_110655 |
| 数据集类型 | 合成训练数据(synth) |
| 标签 | training-data、kind:synth、pipeline:difficult-advice、constitution:claude_distilled_12_principles_mid、smoke、backfilled-2026-08-25 |
数据配置
数据集包含多个配置(config),主要分为两类:
- 默认配置:
dataset(数据文件为dataset.jsonl) - 流水线各阶段快照:以
stage_<n>_<name>命名,共 9 个阶段(部分阶段包含.partial中间版本):stage_1_chunk_constitutionstage_2_write_scenariosstage_3_dedupe_scenariosstage_4_draft_promptsstage_5_revise_prompts(含.partial版本)stage_6_draft_responses(含.partial版本)stage_7_revise_responses(含.partial版本)stage_8_export_sft
所有数据文件均采用 jsonl 格式存储。
生成流程与来源
- 指导宪法:使用
constitutions/claude_distilled_12_principles_mid/constitution.md - 源仓库:https://github.com/Matthew-Bozoukov/Lessons_from_constituitional_AFT.git(提交版本为
432c0693067910a134add164588e51b3a75e1998) - 生成命令:
uv run synth run --config configs/data/synth/difficult_advice_chunk_only.yaml
其他说明
- 模型与生成配置:不同阶段使用不同模型,具体参数与采样设置见
manifest.json文件 - 数据模式:包含各阶段 jsonl 快照文件及
manifest.json元数据文件 - 数据用途:该数据集为合成生成的数据,用于训练目的,且为流水线各阶段的中间产物缓存,便于断点续跑