TTS-Clean44k
收藏资源简介:
TTS-Clean44k是一个经过验证的干净、宽带语音多语言数据集,专门用于训练和评估语音修复及文本转语音(TTS)模型。该数据集作为Sidon呼叫中心语音修复任务的干净教师池而构建,其核心要求是确保语音样本的高质量,以便解码器能够准确复现。数据集中的每个话语都经过两个维度的独立验证:首先,确保原始采样率不低于44.1 kHz(通过ffprobe实际测量,不依赖元数据);其次,使用DNSMOS P.835模型评估背景噪声MOS(bak),要求分数不低于3.644,从而保证只包含真正干净的录音。数据集包含28种不同的语言或方言配置,总计119,950个话语,总时长约208.7小时。每个配置对应一个训练分割,数据以Parquet格式存储,并附带每个话语的质量评分。数据模式包括:音频(48 kHz采样率的单声道波形)、来源(配置名称)、bak(DNSMOS背景噪声MOS)、sig(DNSMOS信号MOS)、ovrl(DNSMOS整体MOS)以及时长(秒)。长录音被分割为不超过15秒的片段,而短于4秒的话语则被保留原样。数据来源主要包括OpenSLR的高质量TTS语料库和众包语音数据集,涵盖了从英语(如英国、爱尔兰、尼日利亚、南非变体)、西班牙语(阿根廷、智利、哥伦比亚、秘鲁、波多黎各、委内瑞拉变体)到多种其他语言(如中文、巴斯克语、加泰罗尼亚语、加利西亚语、爪哇语、巽他语、泰米尔语、泰卢固语、马拉雅拉姆语、马拉地语、高棉语、尼泊尔语、古吉拉特语、卡纳达语、缅甸语、约鲁巴语等)。该数据集适用于需要高质量、低噪声语音数据的语音修复、语音增强和TTS模型开发与研究。
TTS-Clean44k is a validated, clean, wideband multilingual speech dataset specifically designed for training and evaluating speech restoration and text-to-speech (TTS) models. This dataset was constructed as a clean teacher pool for the Sidon call center speech restoration task, with the core requirement of ensuring high-quality speech samples to enable accurate reproduction by decoders. Each utterance in the dataset is independently validated across two dimensions: first, the original sampling rate must be no lower than 44.1 kHz (measured via ffprobe physically, without relying on metadata); second, the background noise MOS (bak) was evaluated using the DNSMOS P.835 model, with a required score of no less than 3.644, to ensure that only truly clean recordings are included. The dataset includes 28 distinct language or dialect configurations, totaling 119,950 utterances with an aggregate duration of approximately 208.7 hours. Each configuration corresponds to a training split, and the data is stored in Parquet format, with quality scores attached to each utterance. The data schema includes: audio (mono waveform with 48 kHz sampling rate), source (configuration name), bak (DNSMOS background noise MOS), sig (DNSMOS signal MOS), ovrl (DNSMOS overall MOS), and duration (in seconds). Long recordings are segmented into clips no longer than 15 seconds, while utterances shorter than 4 seconds are preserved as-is. The data sources primarily include high-quality TTS corpora from OpenSLR and crowdsourced speech datasets, covering a wide range of languages, from English (with variants from the UK, Ireland, Nigeria, and South Africa) and Spanish (with variants from Argentina, Chile, Colombia, Peru, Puerto Rico, and Venezuela) to numerous other languages such as Chinese, Basque, Catalan, Galician, Javanese, Sundanese, Tamil, Telugu, Malayalam, Marathi, Khmer, Nepali, Gujarati, Kannada, Burmese, Yoruba, and more. This dataset is suitable for the development and research of speech restoration, speech enhancement, and TTS models that require high-quality, low-noise speech data.
TTS-Clean44k 数据集概述
基本信息
TTS-Clean44k 是一个面向语音恢复和文本转语音(TTS)模型训练与评估的多语言、经过验证的纯净宽带语音数据集。该数据集被用作 Sidon 呼叫中心语音恢复任务的“纯净教师池”,要求教师数据必须真正干净且全频带。
数据筛选标准
每条语音都经过独立的两轴验证:
- 原生采样率 ≥ 44.1 kHz — 使用
ffprobe按文件测量,不信任来源宣传的采样率,低于 44.1 kHz 的数据被丢弃。 - DNSMOS P.835 的
bak得分 ≥ 3.644 — 来自 DNSMOS P.835 模型的背景噪声 MOS,确保只有真正干净的录音通过筛选。
数据集规模
- 总语言/来源配置数:28 个
- 总样本数:119,950 条语音
- 总时长:208.7 小时
- 数据集总大小:约 75.3 GB(根据各配置 dataset_size 累计)
- 总下载大小:约 61.4 GB(根据各配置 download_size 累计)
- 音频采样率:所有音频均为 48 kHz 单声道波形
数据质量评分(全数据集加权平均)
- bak(背景噪声 MOS):4.036
- sig(信号 MOS):3.484
- ovrl(整体 MOS):3.203
语言/来源配置详情
| 序号 | 配置名称 | 样本数 | 时长(小时) | bak | sig | ovrl |
|---|---|---|---|---|---|---|
| 1 | hifitts | 19,447 | 30.0 | 4.026 | 3.533 | 3.247 |
| 2 | uk_ireland_en | 14,925 | 28.0 | 4.077 | 3.572 | 3.313 |
| 3 | cv_zhcn | 8,948 | 15.4 | 3.952 | 3.466 | 3.145 |
| 4 | basque | 6,907 | 13.5 | 4.043 | 3.521 | 3.230 |
| 5 | galician | 5,343 | 10.0 | 4.055 | 3.521 | 3.248 |
| 6 | catalan | 4,018 | 9.0 | 3.977 | 3.433 | 3.127 |
| 7 | peruvian_es | 4,991 | 8.8 | 4.052 | 3.423 | 3.154 |
| 8 | south_african | 5,240 | 8.3 | 3.977 | 3.460 | 3.149 |
| 9 | kannada | 3,542 | 7.6 | 4.045 | 3.436 | 3.165 |
| 10 | gujarati | 3,789 | 7.4 | 4.079 | 3.489 | 3.226 |
| 11 | argentinian_es | 4,362 | 6.8 | 4.077 | 3.520 | 3.246 |
| 12 | colombian_es | 4,105 | 6.8 | 4.052 | 3.404 | 3.144 |
| 13 | chilean_es | 3,755 | 6.6 | 4.056 | 3.424 | 3.160 |
| 14 | tamil | 3,633 | 6.4 | 4.027 | 3.300 | 3.035 |
| 15 | nigerian_en | 2,687 | 5.1 | 4.102 | 3.548 | 3.299 |
| 16 | javanese | 2,906 | 4.2 | 4.004 | 3.467 | 3.163 |
| 17 | malayalam | 2,470 | 4.1 | 4.034 | 3.367 | 3.095 |
| 18 | aishell3 | 2,814 | 4.1 | 4.047 | 3.513 | 3.218 |
| 19 | telugu | 2,517 | 4.0 | 4.053 | 3.358 | 3.098 |
| 20 | venezuelan_es | 2,466 | 4.0 | 4.057 | 3.473 | 3.208 |
| 21 | burmese | 2,071 | 3.6 | 4.020 | 3.495 | 3.203 |
| 22 | sundanese | 2,116 | 3.5 | 3.999 | 3.443 | 3.140 |
| 23 | khmer | 2,098 | 3.2 | 4.092 | 3.448 | 3.202 |
| 24 | marathi | 1,400 | 2.8 | 4.088 | 3.433 | 3.186 |
| 25 | yoruba | 1,464 | 2.2 | 4.035 | 3.476 | 3.178 |
| 26 | nepali | 1,157 | 2.0 | 4.000 | 3.496 | 3.183 |
| 27 | puertorico_es | 516 | 0.9 | 4.050 | 3.443 | 3.169 |
| 28 | cv_ta | 263 | 0.4 | 3.855 | 3.116 | 2.780 |
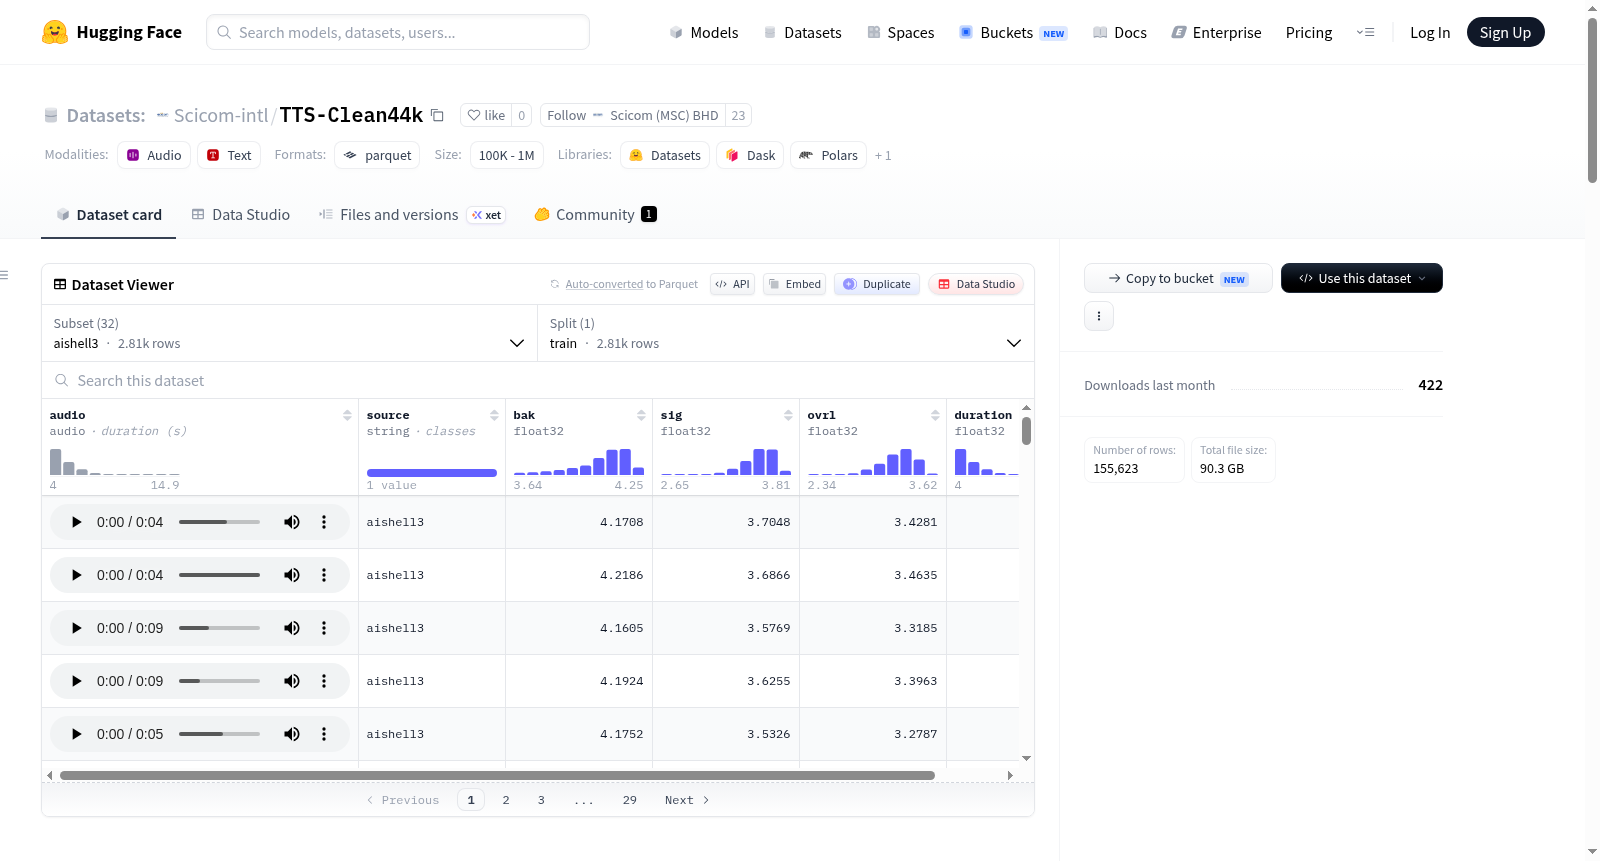
数据模式
每个配置只有一个 train 分割,包含以下字段:
| 字段名 | 类型 | 描述 |
|---|---|---|
audio |
Audio(sampling_rate=48000) | 单声道波形,解码至 48 kHz |
source |
字符串 | 来源/配置名称 |
bak |
float32 | DNSMOS P.835 背景噪声 MOS(每行均 ≥ 3.644) |
sig |
float32 | DNSMOS P.835 信号 MOS |
ovrl |
float32 | DNSMOS P.835 整体 MOS |
duration |
float32 | 音频片段长度(秒) |
数据处理说明
- 长录音被分割为 ≤ 15 秒的片段。
- 短录音(≥ 4 秒)保留完整。
数据来源
- OpenSLR 高质量 TTS:爪哇语(41)、巽他语(44)、泰米尔语(65)、泰卢固语(66)、马拉雅拉姆语(63)、马拉地语(64)、高棉语(42)、尼泊尔语(43)、古吉拉特语(78)、卡纳达语(79)、缅甸语(80)。
- OpenSLR 众包:阿根廷/智利/哥伦比亚/秘鲁/波多黎各/委内瑞拉西班牙语(61/71/72/73/74/75)、加泰罗尼亚语(69)、巴斯克语(76)、加利西亚语(77)、约鲁巴语(86)、尼日利亚英语(70)、南非英语(32)、英国及爱尔兰英语。