
harness-db
收藏官方服务:
资源简介:
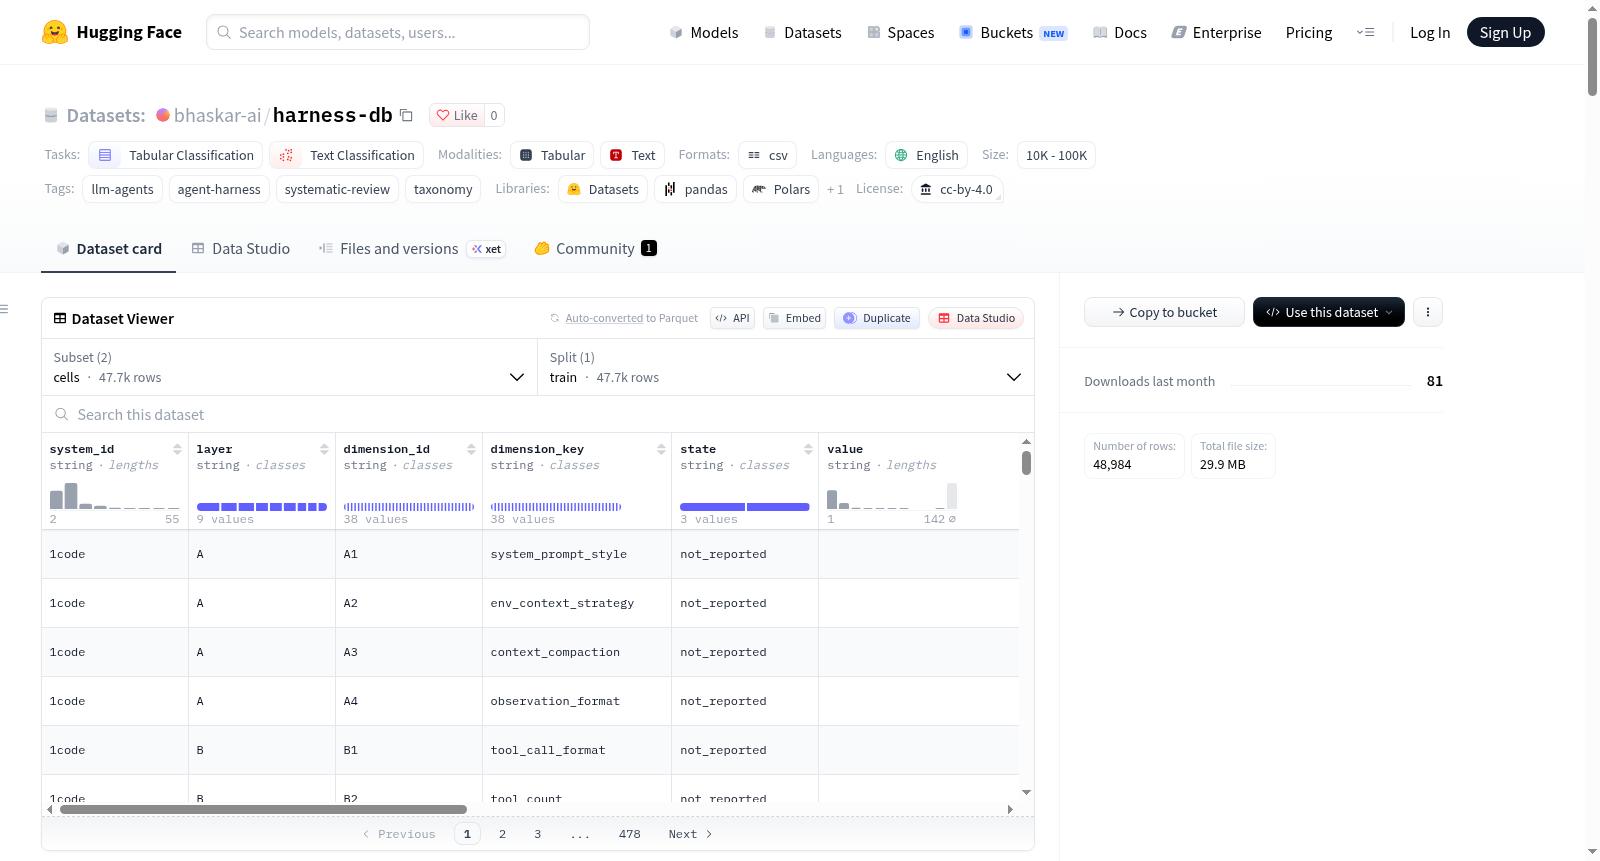
HARNESS-DB是一个关于LLM代理框架(harness)的编码数据集。代理框架是语言模型与任务环境之间的软件层,负责重复组装模型输入、执行模型选择的动作并决定是否继续。该数据集覆盖2022年至2026年间发表的1,256个系统,在38个设计维度(分为九层:上下文组装、工具接口、控制循环、记忆与状态、验证与修复、预算与终止、沙箱与环境、可观测性与治理、元层)上进行了编码,共计47,728个单元格。每个单元格有三种状态:编码值(附带逐字引用、定位符和置信度)、未报告(来源已读但未提及)、未解决(发布时验证失败)。数据集来自一个经过预先注册的系统综述(PRISMA 2020),抽样框架包含6,504个系统,采用分层抽样(高可见性层H、同行评审实现层P、其他层O),并提供了抽样权重,使得数据既支持对编码集的描述,也支持对总体的估计。数据以多种格式提供(JSON、CSV、Parquet),包括系统信息、单元格详情、基准结果、论文元数据、可靠性统计等。该数据集适用于:描述harness设计维度的分布、审计文档中未报告的部分、根据设计属性选择系统、使用引文-维度-值对训练或评估属性提取模型、以及将harness设计与基准表现关联分析。需要注意的是,未报告不等于特征缺失,沉默率是上限,编码集不能直接代表领域整体,且每个系统仅对应一个固定版本快照。
创建时间:
2026-09-26
搜集汇总
数据集介绍
构建方式
在LLM智能体研究领域,系统综述缺乏可复现的编码数据基础。HARNESS-DB依托PRISMA 2020预注册系统综述,从arXiv、Semantic Scholar、OpenAlex、ACL Anthology、OpenReview及GitHub等来源识别37,899条记录,经去重与全文筛选后纳入7,085篇报告,归并为6,504个系统的抽样框。该框划分为高可见度层H、同行评审层P和其余层O,按分层抽样策略编码1,256个系统,并赋予抽样权重。编码框架涵盖9个层级、38个设计维度,由版本化提示协议下的模型实例逐格编码,每个编码值附带原文引证、定位符与置信度,经修复流程与双编码可靠性检验,最终产出47,728个单元格。
特点
该数据集的核心特点在于对“未报告”与“缺失”的严格区分。48.9%的单元格被显式标记为not_reported,表示来源被阅读但保持沉默,而非特征不存在;另有0.3%的单元格因验证失败标记为unresolved。每个编码值均携带逐字引文与可重新打开的定位符,支持证据溯源与抽取模型的训练评估。数据集包含抽样权重,可支持对6,504个系统总体的加权估计。38个维度中15个为多值维度,以管道符连接。可靠性方面,247个系统经双编码,平均Cohen's κ为0.784,37个维度点估计κ不低于0.6。
使用方法
使用者可通过Python加载器便捷访问该数据集。安装harnessdb包后,调用hdb.load()加载解压后的发布目录,即可获得cells长表与systems宽表;db.not_reported(by='layer')可计算各层级的未报告率,并按字段权重加权;db.evidence()可提取指定系统与维度的证据引文;db.to_hf()返回包含systems与cells两个切分的DatasetDict。读取CSV时应使用pd.read_csv(path, keep_default_na=False)以保留空字符串。数据集支持描述设计分布、审计文档沉默、筛选系统、证据抽取及关联设计结果等用途,但不适用于将not_reported解读为特征缺失或对results.csv中的分数进行受控比较。
背景与挑战
背景概述
随着大语言模型智能体在2022至2026年间的迅猛发展,连接模型与任务环境的智能体执行框架(harness)成为决定系统能力的关键软件层,然而既有综述多以叙述性方式选择性介绍知名系统,缺乏覆盖全领域的系统化证据。HARNESS-DB由Bhaskar Gurram创建,基于预注册的PRISMA 2020系统综述,从6,504个系统的抽样框中分层抽取1,256个系统,在9层38个设计维度上进行编码,形成47,728个单元格,成为首个大规模、可溯源、带权重的智能体框架结构化数据集,为智能体工程领域的实证研究奠定了数据基础。
当前挑战
该数据集所解决的领域问题在于:智能体框架设计空间的描述长期依赖作者主观选例和缺乏来源支撑的叙述,导致知名系统过度代表、读者无法区分“功能缺失”与“文档沉默”。构建过程中面临的挑战包括:从37,899条检索记录中筛选并归并出6,504个系统的抽样框;对每个取值提供逐字引文与定位符,并严格区分“已编码缺失”“未报告”“未解析”三种状态;在模型编码与人工审计之间校准信度,使平均Cohen's κ达到0.784,同时公开约48.9%的沉默率、4.2%的可比基准子集以及高可见度系统完全编码与长尾抽样之间的权重偏差。
常用场景
经典使用场景
在大语言模型智能体系统的设计与评估领域,HARNESS-DB作为首个针对智能体执行框架(harness)的系统性编码数据集,其最经典的用途在于刻画各类框架的设计空间与属性分布。研究者可基于38个设计维度、九大层次(如上下文组装、工具接口、控制循环、记忆与状态等)的编码结果,对1256个系统进行加权或未加权的统计描述,从而揭示高可见度系统与长尾系统在容器隔离、验证修复、预算终止等关键设计上的差异。该数据集亦支持按属性组合筛选特定框架,并通过每个编码单元附带的逐字引用与定位符回溯原始出处,为后续研究提供可验证的样本选择基础。
实际应用
在工程实践与产品选型中,HARNESS-DB为开发者与研究者提供了结构化的框架检索与对比工具。用户可依据容器隔离、测试执行验证、网络策略、重试策略等具体维度组合,筛选出满足特定安全或可靠性需求的智能体框架,并直接跳转至对应的代码行或论文段落进行核实。数据集附带的结果表收录了5863项作者报告的基准得分,尽管仅4.2%的系统共享可比基准,仍可为初步性能参考提供线索。此外,该数据集亦可用于审计框架文档的完备性,例如加权后沙箱与环境层的沉默率高达81.6%,提示该领域在关键设计披露上存在显著空白。
衍生相关工作
HARNESS-DB的发布衍生了一系列围绕智能体框架分类、证据提取与设计-结果关联的研究工作。其提供的“引用-维度-值”三元组被用于训练与评估从技术文本中自动抽取设计属性的模型,推动了证据锚定的信息抽取任务发展。同时,该数据集与三套早期分类体系的交叉映射为后续分类学整合研究提供了基准。在实证层面,研究者开始利用其加权样本与可靠性统计(如Cohen's κ均值0.784)开展跨框架的可比性分析,并针对“沉默非缺失”这一编码原则展开方法论讨论。这些工作共同促进了智能体工程领域在可复现性与证据透明度方面的进步。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


