nnh-tts-dataset
收藏资源简介:
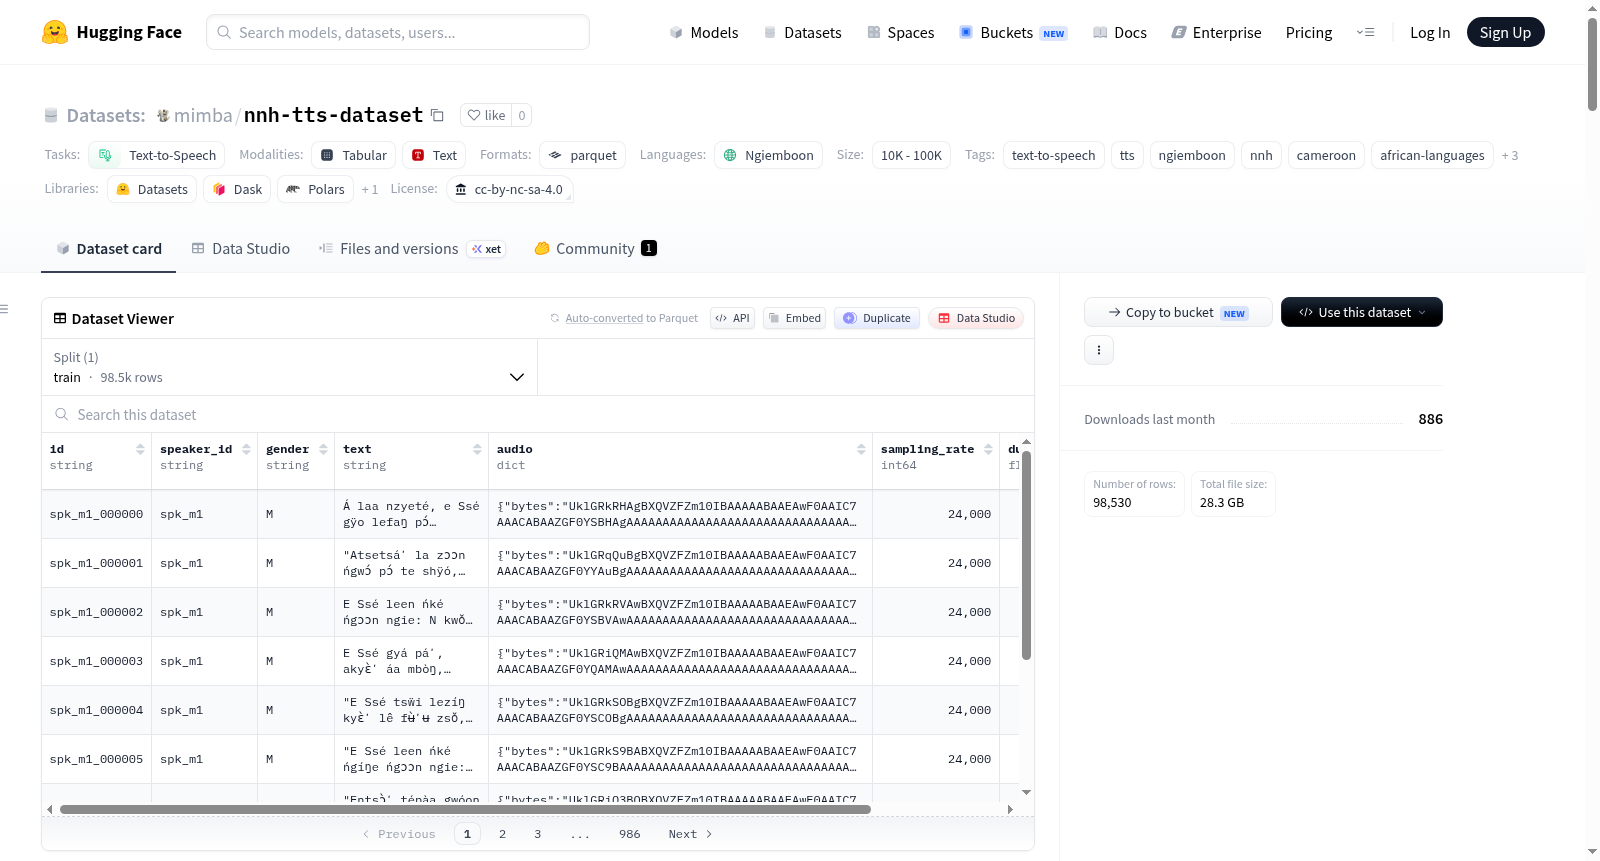
Mimba NNH TTS 数据集是一个干净、多说话人的合成语音语料库,专门用于 Ngiemboon (NNH) 语言。NNH 是喀麦隆西部的一种草原班图语。该数据集旨在为这种低资源语言训练和微调小型、设备端文本转语音模型。数据集中的每个样本都包含一个经过清理的 NNH 句子和由机器生成的语音音频。音频数据是合成的,由 TTS 模型生成,并非录制自真人说话人。数据集包含约 44,000 个清理过的 NNH 句子片段,使用 6 个不同的参考声音(4 个男性标签,2 个女性标签)为每个句子生成语音,从而产生约 264,000 个总样本,形成了跨声音的平行数据,适用于多说话人训练和语音克隆。音频为单声道,采样率为 24,000 Hz,以 WAV 字节形式嵌入 Parquet 文件中。源文本来自 `mimba/text2text` 数据集的 `nnh_fra` 分片,该文本源自《圣经》翻译和其他 NNH 资料。文本经过清理,保留了音调变音符号和修饰撇号,移除了编辑标点和数字等。音频使用 OmniVoice 多语言零样本 TTS 模型在克隆参考模式下合成。数据集包含以下字段:唯一样本 ID、说话人 ID、性别标签、清理后的 NNH 文本、音频字节字典、采样率、音频时长以及用于追溯的源文本索引。需要注意的是,所有音频均为模型生成,可能存在 TTS 伪影;性别标签可能不一致;源文本主要来自宗教领域,存在领域偏见;音素覆盖取决于源句子;且未对每个样本进行人工验证。在商业使用或重新分发前,用户需核实源文本和生成音频的许可条款。该数据集主要用于为 NNH 语言微调小型、设备端的 TTS 模型,以支持离线移动 TTS 应用,也可作为后续添加表达性或非语言标签的基础。
The Mimba NNH TTS Dataset is a clean, multi-speaker synthetic speech corpus specifically designed for the Ngiemboon (NNH) language. NNH is a Grassfields Bantu language spoken in western Cameroon. This dataset is intended for training and fine-tuning small, on-device text-to-speech (TTS) models for this low-resource language. Each sample in the dataset consists of a cleaned NNH sentence and machine-generated speech audio. The audio data is synthetic, produced by TTS models rather than recorded from human speakers. The dataset contains approximately 44,000 cleaned NNH sentence segments. Six distinct reference voices (4 male-labeled and 2 female-labeled) are used to generate speech for each sentence, resulting in roughly 264,000 total samples, forming cross-voice parallel data suitable for multi-speaker training and voice cloning. The audio is mono-channel with a sampling rate of 24,000 Hz, stored as WAV bytes embedded within Parquet files. The source text is sourced from the `nnh_fra` split of the `mimba/text2text` dataset, which originates from Bible translations and other NNH language materials. The text has been cleaned: tonal diacritics and modifying apostrophes are preserved, while editorial punctuation and numerals are removed. The audio was synthesized using the OmniVoice multilingual zero-shot TTS model in cloning reference mode. The dataset includes the following fields: unique sample ID, speaker ID, gender label, cleaned NNH text, audio byte dictionary, sampling rate, audio duration, and source text index for traceability. Notably, all audio is model-generated and may contain TTS artifacts; gender labels may be inconsistent; the source text is primarily sourced from religious domains, introducing domain bias; phoneme coverage is dependent on the source sentences; and no manual validation has been performed for individual samples. Users are required to verify the license terms for the source text and generated audio prior to commercial use or redistribution. This dataset is primarily used for fine-tuning small, on-device TTS models for the NNH language to support offline mobile TTS applications, and can also serve as a foundation for subsequent addition of expressive or non-linguistic labels.
数据集概述:Mimba NNH TTS Dataset (Ngiemboon Synthetic Speech)
基本信息
- 语言:Ngiemboon(nnh),喀麦隆西部草场班图语。
- 许可证:cc-by-nc-sa-4.0(非商业性使用-相同方式共享4.0)。
- 任务类别:文本到语音(Text-to-Speech)。
- 数据集规模:100,000 至 1,000,000 条样本。
- 配置:默认配置,包含训练集,数据文件为
data/*.parquet。
数据集摘要
- 音频:单声道,24,000 Hz 采样率,WAV 格式字节嵌入在 Parquet 文件中。
- 说话人:6 个参考声音(4 男 2 女)。
- 句子:约 44,000 个清洗后的 NNH 句子片段。
- 总样本数:约 264,000 条(每个句子 × 每个说话人)。
- 来源文本:源自
mimba/text2text数据集的nnh_fra分割。 - 生成模型:OmniVoice(k2-fsa),零样本克隆方式。
数据字段
| 字段 | 类型 | 描述 |
|---|---|---|
id |
string | 唯一样本ID,例如 spk_m2_001234 |
speaker_id |
string | 参考声音ID(spk_m1 至 spk_f2) |
gender |
string | 说话人性别标签(M 或 F) |
text |
string | 清洗后的 NNH 句子(口语文本) |
audio |
dict | 包含 {"bytes": <24kHz单声道WAV字节>, "path": None} |
sampling_rate |
int | 固定值 24000 |
duration |
float | 音频时长(秒) |
src_idx |
int | 在源数据集 mimba/text2text 中的行索引 |
说话人信息
| 说话人ID | 性别标签 |
|---|---|
spk_m1 |
M |
spk_m2 |
M |
spk_m3 |
M |
spk_m4 |
M |
spk_f1 |
F |
spk_f2 |
F |
注意:性别标签来自生成配置,未经过声学重新验证,使用时需确认。
数据生成方式
- 文本:来自
mimba/text2text数据集的nnh_fra分割,源于圣经翻译及其他 NNH 来源。 - 清洗与分割:保留声调变音符号和修饰性撇号
ʼ(U+02BC);删除编辑性标点、非断行空格、包含数字及过短片段;根据标点分割长句。 - 音频生成:使用 OmniVoice 零样本 TTS 模型,以 NNH 为语言 ID,每个句子用所有参考声音生成。
- 输出格式:浮点32位单声道 24,000 Hz,WAV 编码嵌入为字节,存储于 Parquet 分片中。
局限性
- 合成音频:所有音频由模型生成,可能带有 TTS 伪影,不完全等同于真人发音。
- 性别标签:至少一个说话人的性别标签可能不准确。
- 文本偏差:文本主要来自宗教来源,词汇和领域偏向圣经,不反映日常对话。
- 音素覆盖:受来源句子影响,稀有音素可能覆盖不足。
- 无人工验证:每条样本未经人工审核,大规模使用前需抽样检查。
预期用途
- 微调小规模、设备端文本到语音模型,使其能够发音 Ngiemboon 并进行声音克隆。
- 作为后续添加表达性/非语言标签微调阶段的基础数据集。
引用信息
-
项目:Mimba 项目及 OmniVoice(k2-fsa)作为语音生成器。
-
BibTeX 引用: bibtex @misc{ title={nnh-tts-dataset: Small Out-of-domain resource for various africain languages}, author={Mimba Ngouana Fofou}, year={2026}, }
-
联系方式:可通过仓库的“社区”标签页提问,或联系邮箱 baounabaouna@gmail.com。