
遇见数据集

issai/freshqa_kazakh

收藏
Hugging Face2026-06-18 更新2026-06-21 收录
官方服务:

资源简介:

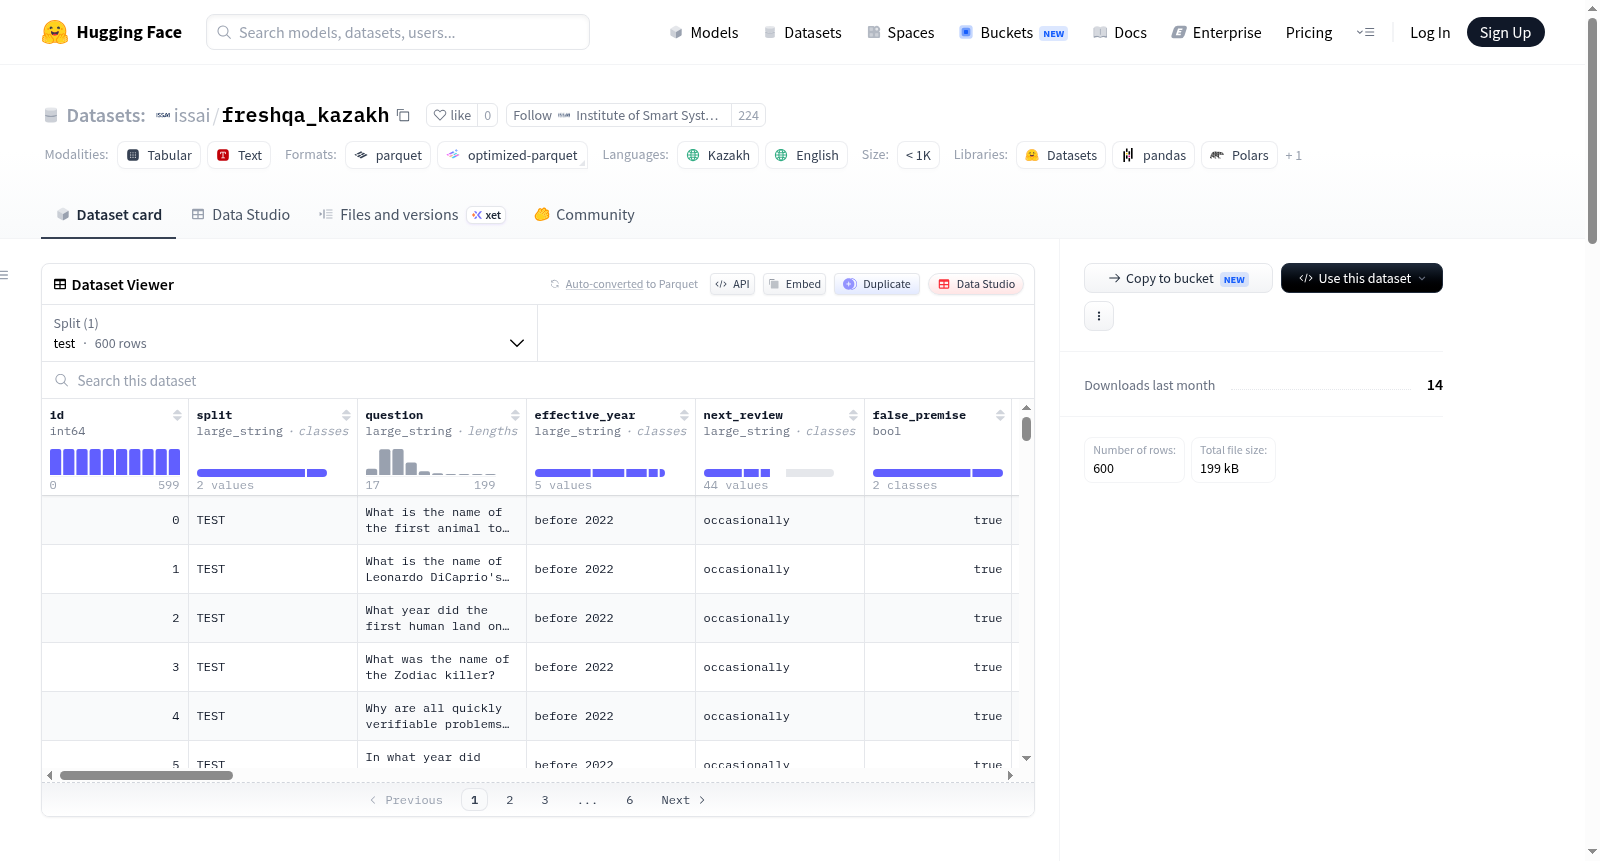
FreshQA哈萨克语数据集是原始FreshQA幻觉基准数据集的机器翻译版本,专门设计用于测试大型语言模型的事实性和幻觉率。该数据集特别关注那些答案可能随时间变化或涉及错误前提的问题。它包含600个样本,分为三种不同的事实类型。为了涵盖模型可能正确回应的各种方式,每个问题提供了最多10个可能的有效答案。问题和所有有效答案均已翻译成哈萨克语,从而支持对模型处理动态事实知识和复杂推理步骤的能力进行稳健的跨语言评估。

The Kazakh FreshQA dataset is a machine-translated version of the original FreshQA hallucination benchmark dataset, specifically designed to evaluate the factuality and hallucination rate of large language models (LLMs). This dataset specifically focuses on questions whose answers may change over time or involve false premises. It consists of 600 samples, categorized into three distinct factuality types. To cover the diverse ways a model can deliver a correct response, each question is paired with up to 10 valid possible answers. Both the questions and all valid answers have been translated into Kazakh, thus enabling robust cross-lingual evaluation of a model's ability to process dynamic factual knowledge and perform complex reasoning steps.
提供机构:
issai
搜集汇总
数据集介绍
issai/freshqa_kazakh 数据集图片
构建方式
FreshQA Kazakh是基于原始FreshQA幻觉基准测试数据集,通过机器翻译技术构建而成的跨语言评估资源。原始数据集由600个精心设计的问答样本组成,每个样本均包含最多10个可接受的正确答案,旨在评估大语言模型在处理随时间变化的事实或含有虚假前提的问题时的表现。在构建过程中,团队将原始英文问题及其对应的多个有效答案整体迁移至哈萨克语,生成了`KK_question`和`KK_answer_0`至`KK_answer_9`字段,从而保留了原始数据集的复杂结构,包括事实类型、推理步数、生效年份等关键元数据。这种翻译方式确保了双语版本在语义和逻辑上的一致性,为多语言事实性评估提供了可靠基础。
使用方法
使用FreshQA Kazakh时,研究人员可直接加载测试集(`test` split),利用`KK_question`字段作为模型输入,并将模型输出与`KK_answer_0`至`KK_answer_9`中的有效答案进行比对,以判定事实性正确性。为处理时间敏感问题,建议结合`effective_year`和`next_review`字段来约束知识时效性。同时,`false_premise`标志可用于分析模型对虚假前提的敏感度,而`num_hops`则支持分层评估不同推理复杂度下的表现。数据集支持以JSON格式进行批处理,便于集成至现有评估流水线,其`source`字段还可用于追溯验证,提升评测透明度。
背景与挑战
背景概述
FreshQA Kazakh数据集是对原始FreshQA幻觉基准测试的机器翻译版本,由研究人员于近期创建,旨在评估大型语言模型在处理动态事实与复杂推理时的真实性与幻觉率。该数据集聚焦于答案随时间变化或基于错误前提的问题,涵盖600个精心设计的样本,分为快速变化、缓慢变化与静态三类事实类型。其核心研究问题在于探索语言模型能否在跨语言环境下保持事实准确性,尤其针对哈萨克语等低资源语言。通过引入多跳推理与时间敏感维度,FreshQA Kazakh不仅扩展了原始基准的覆盖范围,也为多语言自然语言处理领域提供了关键评测资源,对推动低资源语言模型的鲁棒性研究具有显著影响力。
当前挑战
该数据集面临的主要挑战包括:首先,领域问题层面,语言模型在处理时间敏感或含错误前提的事实性问题时,常因知识过时或推理不足而产生幻觉,FreshQA Kazakh通过动态事实标注与多跳推理设计,系统性地暴露了模型在事实捕获与逻辑验证上的缺陷。其次,构建过程中,机器翻译可能引入语义偏差或文化特定误差,尤其是在哈萨克语与英语之间,导致问题与答案的等价性受损。此外,样本规模较小(仅600条)限制了统计可靠性,而频繁更新事实(如气象数据)则需要持续维护,增加了长期可用性的难度。这些挑战共同凸显了在低资源语言场景下构建高质量动态基准的复杂性。
常用场景
经典使用场景
在自然语言处理与大型语言模型评估的研究版图中,FreshQA哈萨克语数据集作为一项跨语言事实性幻觉评估基准,承载着检验模型处理动态知识与错误前提的使命。该数据集精选了600个样本,涵盖了快速变化、缓慢变化与稳定型三类事实,并针对每一个问题提供了多达10条可接受的正确答案。其经典使用场景在于评估模型在面对时间敏感型知识(如2025年龙卷风统计数据)或逻辑陷阱(如错误前提问题)时的回答质量,为研究者提供了一个在低资源语言哈萨克语环境下评测模型事实性幻觉强度的标准化平台。
解决学术问题
该数据集精准回应当前大语言模型研究中一个棘手的学术挑战:如何量化模型在复杂动态知识环境中的事实性和幻觉率。传统评估多聚焦于静态常识,忽略了事实随时间演变以及错误前提问题带来的认知干扰。FreshQA哈萨克语通过精细的多重有效答案设计及明确的时效性标注,首次为哈萨克语场景下的模型推理步数与知识变化频率的交互作用提供了系统化的评测框架。这一设计极大推动了跨语言知识更新、时序推理以及幻觉检测等核心议题的量化分析,使研究者能够更清晰地追溯模型认知失效的根源,进而提升模型在动态世界中的可靠表现。
实际应用
在实际部署场景中,FreshQA哈萨克语数据集的价值体现在多个维度。其一,它是哈萨克语智能问答系统不可或缺的可靠性测试工具,尤其适用于新闻摘要、个人助理及公共信息查询等对事实准确度要求极高的领域。其二,针对涉及政策法规、天气预警、金融汇率等快速变化信息的应用程序,该数据集提供了一套严格的验收标准,帮助开发者预判模型在关键任务中的“说谎率”。其三,数据集中含有的错误前提问题,对于构建具备主动质疑逻辑能力的用户交互系统具有指导意义,促使AI在不确定情境下会生成防御性回应而非盲目迎合用户。
数据集最近研究
最新研究方向
在大型语言模型飞速迭代的当下,如何精准抑制事实性幻觉已成为自然语言处理领域亟待攻克的堡垒。FreshQA哈萨克语版本的问世,恰逢其时地将这一前沿挑战从单一英语语境拓展至低资源语言疆域。该数据集不仅沿袭了原始基准对动态变化知识(如时效性事实)与虚假前提推理的严苛测试,更通过哈萨克语的全维度本地化翻译,为跨语言事实一致性评估提供了稀缺的标注语料。这一创新性举措,紧密关联着多语言大模型在知识更新速度与推理跳数维度上的性能鸿沟研究,尤其在涉及政治、地理等高频变动领域,其揭开的幻觉分布差异正推动学界重新审视预训练语料的地域覆盖与时效衰减补偿机制,极具引领低资源语言可靠性评估范式转型的深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

