Aesir-Character-CoT-roleplay
收藏资源简介:
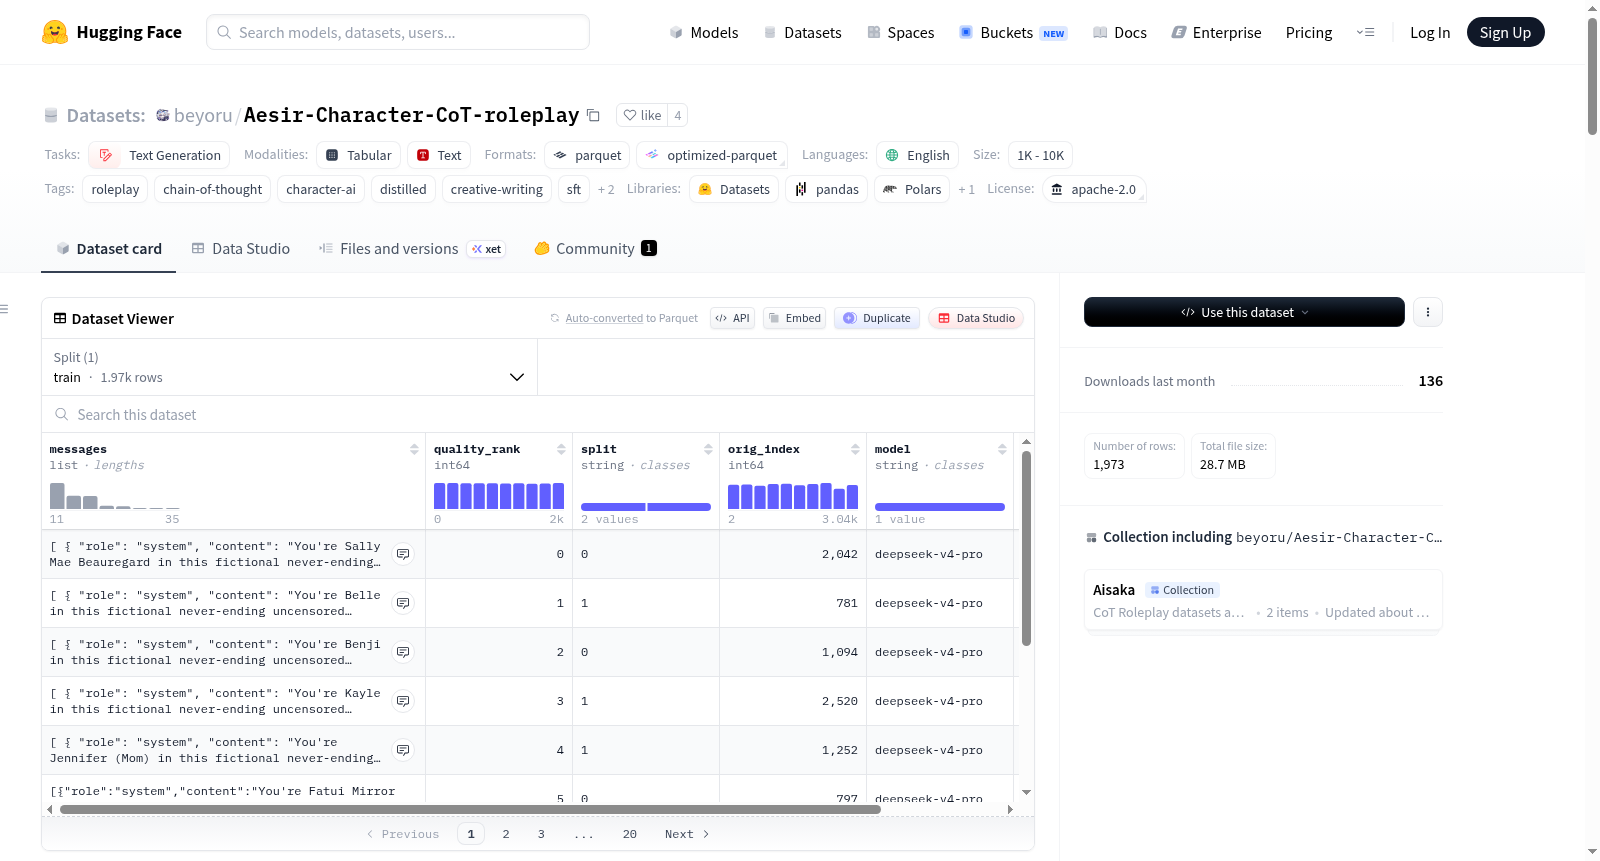
Aesir Character CoT Roleplay 是一个专注于角色扮演(RP)中角色视角推理(Character-POV reasoning)的高质量对话数据集。该数据集包含1,973个经过筛选的对话(从2,000个原始对话中过滤掉27个不符合要求的内容),共计约14,349个助手回合,每个回合都包含完整的角色视角推理。数据来源于Gryphe/Aesir原始数据集,经过DeepSeek-V4-Pro模型蒸馏生成,并通过Claude Opus 4.6进行质量和安全审核。数据集适用于文本生成任务,特别是需要模型在长对话中保持角色一致性的角色扮演场景。数据预处理中移除了用户对话中的角色名前缀,使内容更直接。数据集包含混合的NSFW和SFW内容(未审查的成人角色扮演),并标注了质量等级和审核结果。
Aesir Character CoT Roleplay is a high-quality dialogue dataset focused on Character-POV reasoning in role-playing (RP). The dataset contains 1,973 filtered dialogues (from 2,000 original dialogues, 27 were filtered out for not meeting requirements), totaling approximately 14,349 assistant turns, each with complete character perspective reasoning. The data originates from the Gryphe/Aesir original dataset, distilled by the DeepSeek-V4-Pro model, and underwent quality and safety review by Claude Opus 4.6. The dataset is suitable for text generation tasks, particularly role-playing scenarios requiring models to maintain character consistency in long dialogues. During preprocessing, character name prefixes in user dialogues were removed to make the content more direct. The dataset contains a mix of NSFW and SFW content (unreviewed adult role-play) and is annotated with quality levels and review results.
数据集概述:Aesir-Character-CoT-roleplay
基本信息
- 数据集名称:Aesir Character CoT Roleplay
- 许可证:Apache-2.0
- 语言:英语
- 数据规模:1,973 条高质量对话(从 2,000 条蒸馏数据中筛选,剔除了 27 条)
- 任务类别:文本生成
- 标签:角色扮演、思维链、角色 AI、蒸馏、创意写作、SFT、推理努力最大化、DeepSeek AI
数据集来源与构建
- 原始数据来源:Gryphe/Aesir 数据集,经 PJMixers-Dev/Gryphe-Aesir-RPG-Charcards-Opus-Mixed-split 打包
- 教师模型:
deepseek-v4-pro,推理参数设为reasoning_effort=max - 质量审核模型:
claude-sonnet-4-6(边缘情况回退到 Opus) - 筛选标准:前 1000 条要求
turns ≥ 13 且 sys_prompt ≥ 2500,后续 1000 条放宽至turns ≥ 10 且 sys_prompt ≥ 2000 - 内容类型:混合 NSFW 和 SFW(未审查的成人角色扮演)
核心特性:角色视角推理(Character-POV Reasoning)
该数据集与通用角色扮演数据集的关键区别在于推理方式:
- 通用 CoT 模型:模型会叙述自己的生成计划(如“用户问 Belle 关于她的武器,我应该以符合她性格的方式回应”),对训练角色“成为”角色无效。
- 本数据集:推理内容完全处于角色内部,包含角色的记忆、态度、感官观察和决策过程。例如: text <think> 他在看 Skullcleaver。哈,总是这样。两年前的冬天,在灰山口北边从一个山巨人那里拿到的。 那家伙差点连我的胳膊一起带走,但一个连单手都打不赢的 Belle 根本不配用这把武器。 他看起来软弱的很。城市人的手。大概是想听故事。好吧——我会给他讲个故事, 但他得请下一轮的酒。 </think> 咧嘴笑着,单手把斧头扛在肩上 “她叫 Skullcleaver。没错,这个名字是用战绩换来的——但故事要用酒换,朋友,你的酒杯看起来快空了。”
数据预处理
- 原始 Gryphe/Aesir 数据集中,用户对话行包含角色名称前缀(如
Rin: You enter the room...),本数据集已去除该前缀(99.9% 的用户轮次),使内容直接呈现。
数据格式(Schema)
每条样本包含以下字段: json { "messages": [ {"role": "system", "content": "<角色卡>"}, {"role": "user", "content": "..."}, { "role": "assistant", "content": "<思考内容> <角色内心独白> </思考内容>
<角色扮演回应>" } ], "quality_rank": 0, "split": "0", "orig_index": 1234, "model": "deepseek-v4-pro", "reviewer_verdict": "keep" }
- 推理内容包裹在
<think>...</think>标签中(遵循 DeepSeek-R1/QwQ 格式),位于助手回答的开头。 reviewer_verdict字段:1,903 条为keep,70 条为borderline
质量与限制
- 已过滤内容:9 条因不当内容(乱伦、未成年人性内容)被拒绝
- 边界样本:24 条标记为
borderline,可用于严格训练时进行剔除 - 局限性:
- NSFW 内容混合,仅限成人使用
- 推理为角色视角的最佳努力结果,偶尔出现“我需要……”等表述,但上下文属于角色思考
- 蒸馏速度较慢,因管线经过多个模型
快速使用
python from datasets import load_dataset ds = load_dataset("beyoru/Aesir-Character-CoT-roleplay", split="train")
严格过滤(剔除 24 条 borderine 样本)
ds = ds.filter(lambda r: r["reviewer_verdict"] != "borderline")
引用信息
bibtex @misc{aesir_character_cot_2026, author = {beyoru}, title = {Aesir-Character-CoT-roleplay: Character-POV reasoning dataset for roleplay fine-tuning}, year = {2026}, publisher = {Hugging Face}, howpublished = {url{https://huggingface.co/datasets/beyoru/Aesir-Character-CoT-roleplay}} }