
KantoRegion/hp_conversations_with_hermione_granger_movie
收藏数据链接:
官方服务:
资源简介:
--- task_categories: - conversational language: - en size_categories: - 1K<n<10K ---
任务类别: - 对话式任务(conversational) 语言: - 英语(en) 数据规模类别: - 1千<样本数<1万(1K<n<10K)
提供机构:
KantoRegion原始信息汇总
数据集概述
任务类别
- 对话系统
语言
- 英语
数据规模
- 1K<n<10K
搜集汇总
数据集介绍
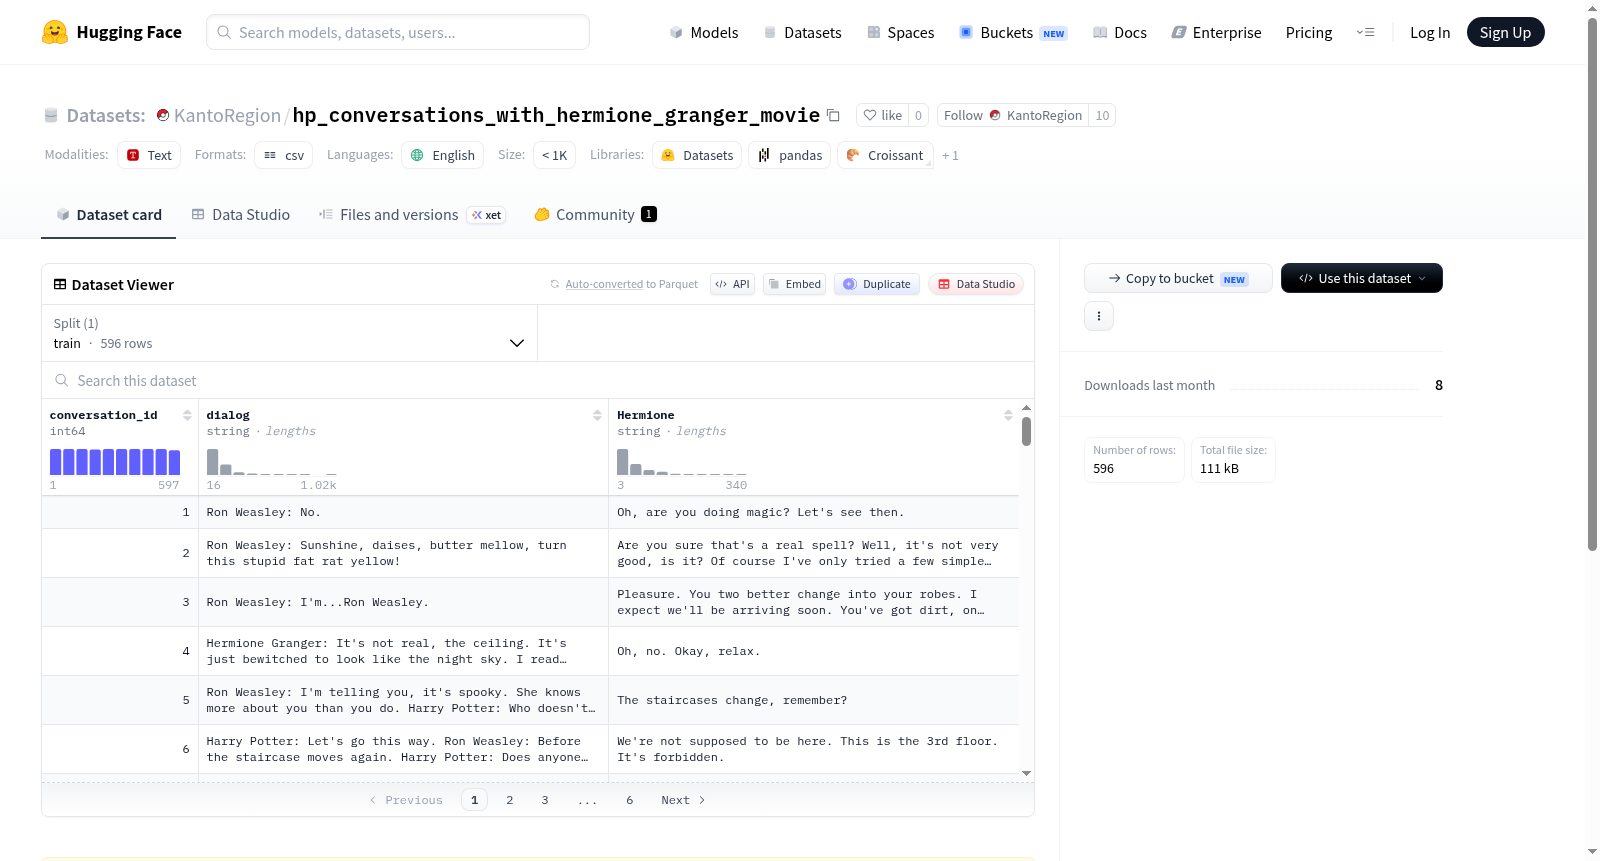
构建方式
该数据集聚焦于对话式交互场景,精心收集了与电影角色赫敏·格兰杰(Hermione Granger)相关的对话记录。构建过程以英文为主要语言载体,从电影《哈利·波特》系列中提取自然语言交流片段,经过筛选与整理,形成了规模在1千至1万条之间的高质量对话集合。数据集的构建旨在捕捉角色在特定情境下的语言风格与互动模式,为对话系统研究提供贴近影视原著的真实语料。
使用方法
该数据集可直接用于对话系统的微调与评估,尤其适用于角色扮演型对话模型的开发。使用时,建议将数据划分为训练集、验证集与测试集,以监督学习方式训练模型生成符合赫敏风格的回复。也可用于零样本或少样本场景下的对话生成任务,通过提示工程(prompt engineering)引导模型模拟角色语气。数据格式为标准的对话轮次结构,易于接入HuggingFace Transformers等主流框架进行预处理与模型适配。
背景与挑战
背景概述
在对话系统与角色扮演人工智能的交叉领域,如何构建具有鲜明个性与知识背景的虚拟角色一直是研究热点。该数据集名为“KantoRegion/hp_conversations_with_hermione_granger_movie”,创建于近年,旨在捕捉电影《哈利·波特》中赫敏·格兰杰这一角色的对话风格与知识体系。研究人员通过提取电影脚本中的对话片段,构建了规模在1千至1万条之间的英文对话数据集,核心研究问题在于如何利用有限但高质量的影视对话数据,训练出能够模拟赫敏智慧、严谨且略带傲娇性格的对话模型。该数据集对影视角色驱动的对话生成领域具有重要影响力,为后续基于特定角色知识图谱的对话系统研究提供了基础资源。
当前挑战
该数据集面临的主要挑战首先在于领域问题的特殊性:影视角色对话生成不仅需要理解自然语言,还需精确再现角色在特定情节中的情感逻辑与知识边界,例如赫敏对魔法知识的严谨态度及其与哈利、罗恩的互动模式,这对模型的一致性提出高要求。其次,构建过程中的挑战包括:数据来源仅限于电影脚本,导致对话覆盖场景有限,且原始对话缺乏上下文标注;同时,1千至1万条的数据规模较小,容易引发过拟合问题,难以泛化至未出现的对话情境。此外,角色语言风格与电影演员的表演紧密相关,如何剥离表演元素而保留文本特征也是一大难题。
常用场景
经典使用场景
该数据集收录了以赫敏·格兰杰为角色的电影对话片段,适用于构建基于角色扮演的对话生成模型。研究者可借此训练模型模仿赫敏的语风、知识背景与性格特质,从而在自然语言处理领域探索个性注入与风格迁移的经典任务。其核心应用在于推动人物驱动型对话系统的研究,使智能体能够更生动地复现文学影视角色的交互模式。
解决学术问题
该数据集着力解决了影视角色对话数据稀缺的问题,为个性对话生成与角色一致性建模提供了标准化基准。学术上,它帮助研究者量化评估模型在保持角色语言风格、情感连贯性与知识一致性上的表现,推动了关于对话系统人格化与语境适应性的理论进展,同时为跨模态角色理解提供了新的实验范式。
实际应用
在实际应用中,该数据集可赋能虚拟偶像、智能客服与教育娱乐领域的角色对话系统。例如,用于开发能够以赫敏口吻解答魔法世界问题的互动式学习助手,或嵌入主题公园的语音交互装置,提升用户体验的沉浸感与情感共鸣。其价值在于将文本数据转化为具备角色灵魂的实用对话能力。
数据集最近研究
最新研究方向
该数据集聚焦于以《哈利·波特》系列电影中赫敏·格兰杰角色为对象的对话交互,属于影视角色驱动的对话系统前沿方向。当前研究热点在于利用电影角色丰富的个性特征和情感线索,构建更具沉浸感和角色一致性的社交对话模型。随着大语言模型在人物角色扮演和情感计算领域的突破,此类数据集为探索多轮对话中的角色身份保持、知识记忆融合以及情感共鸣生成提供了关键支撑。其意义在于推动从通用对话到特定角色对话的迁移学习研究,并为影视IP的数字化互动体验、虚拟伴侣等应用奠定数据基础,在娱乐科技与人机交互交叉领域具有重要影响。
以上内容由遇见数据集搜集并总结生成


