eswardivi/orca_math_ppl
收藏资源简介:
--- dataset_info: features: - name: question dtype: string - name: answer dtype: string - name: conversations list: - name: content dtype: string - name: role dtype: string - name: ppl sequence: float64 - name: loss sequence: float64 - name: ppl_A_direct dtype: float64 - name: ppl_A_condition dtype: float64 - name: ifd_ppl dtype: float64 splits: - name: train num_bytes: 18613294 num_examples: 10002 download_size: 7612439 dataset_size: 18613294 configs: - config_name: default data_files: - split: train path: data/train-* ---
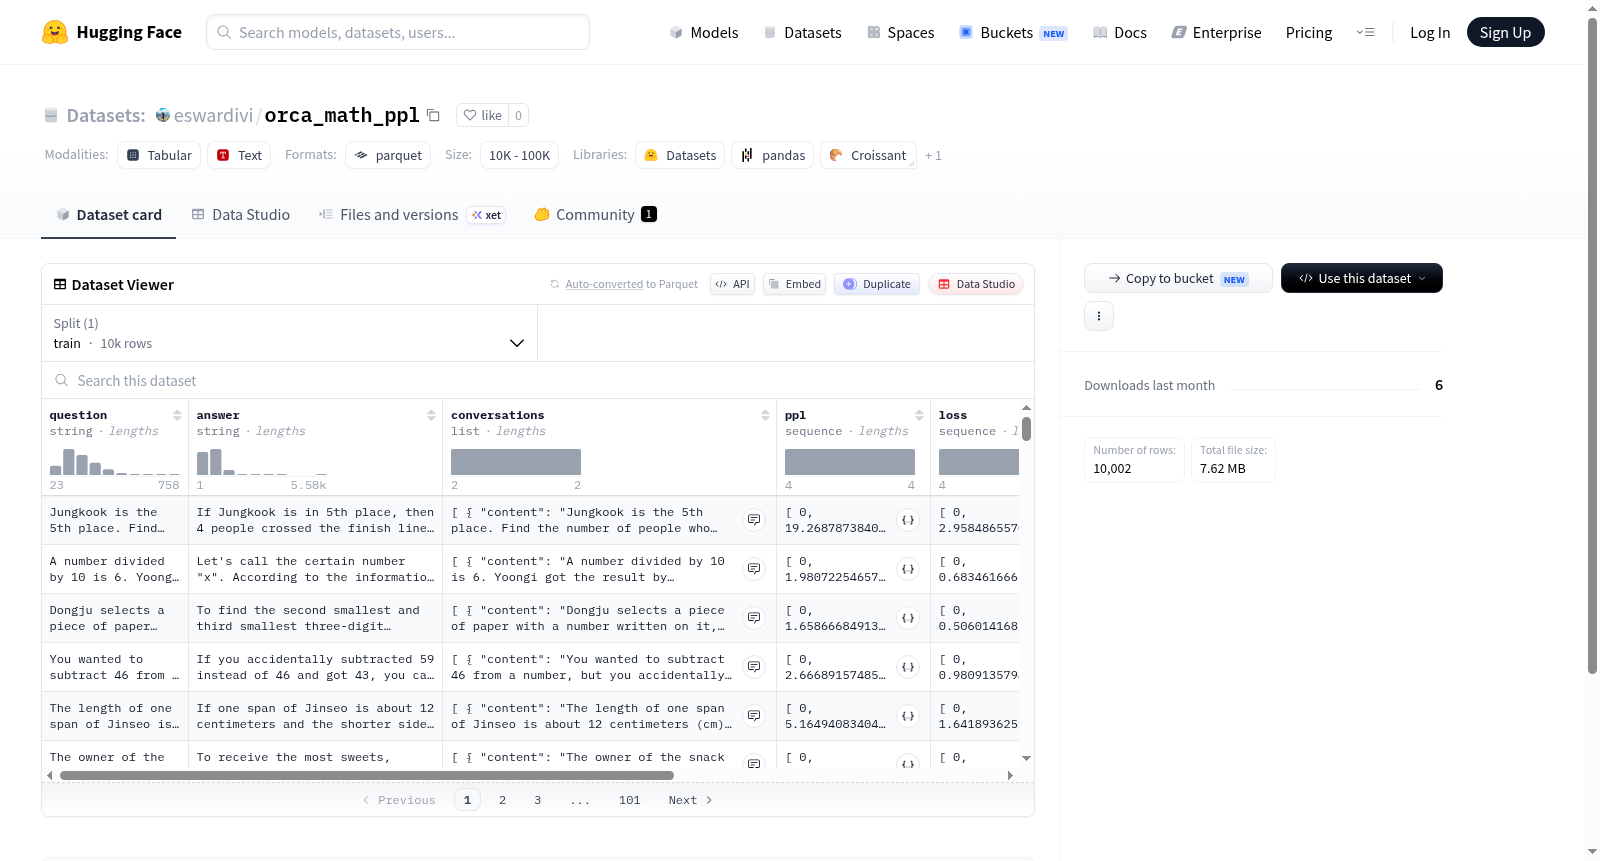
数据集信息: 特征字段包含以下项: 1. `question`:问题,数据类型为字符串(string) 2. `answer`:答案,数据类型为字符串(string) 3. `conversations`:对话列表,列表内每个元素包含两个子字段: - `content`:对话内容,数据类型为字符串(string) - `role`:对话角色,数据类型为字符串(string) 4. `ppl`:双精度浮点数序列,该指标通常指代困惑度(perplexity,缩写PPL) 5. `loss`:双精度浮点数序列 6. `ppl_A_direct`:数据类型为双精度浮点数(float64) 7. `ppl_A_condition`:数据类型为双精度浮点数(float64) 8. `ifd_ppl`:数据类型为双精度浮点数(float64) 数据集拆分: - 训练集(train):占用字节数为18613294,样本总量为10002 整体下载大小为7612439,数据集总占用字节数为18613294 配置项: - 默认配置(config_name: default):数据文件对应训练集拆分,存储路径为data/train-*
数据集概述
数据集特征
- question: 数据类型为字符串。
- answer: 数据类型为字符串。
- conversations: 包含以下子特征:
- content: 数据类型为字符串。
- role: 数据类型为字符串。
- ppl: 数据类型为序列,具体为float64。
- loss: 数据类型为序列,具体为float64。
- ppl_A_direct: 数据类型为float64。
- ppl_A_condition: 数据类型为float64。
- ifd_ppl: 数据类型为float64。
数据集分割
- train:
- 数据量: 18613294字节
- 示例数量: 10002
数据集大小
- 下载大小: 7612439字节
- 数据集大小: 18613294字节
配置
- config_name: default
- data_files:
- split: train
- path: data/train-*