
vyomaalabs/verixa-dataset
收藏官方服务:
资源简介:
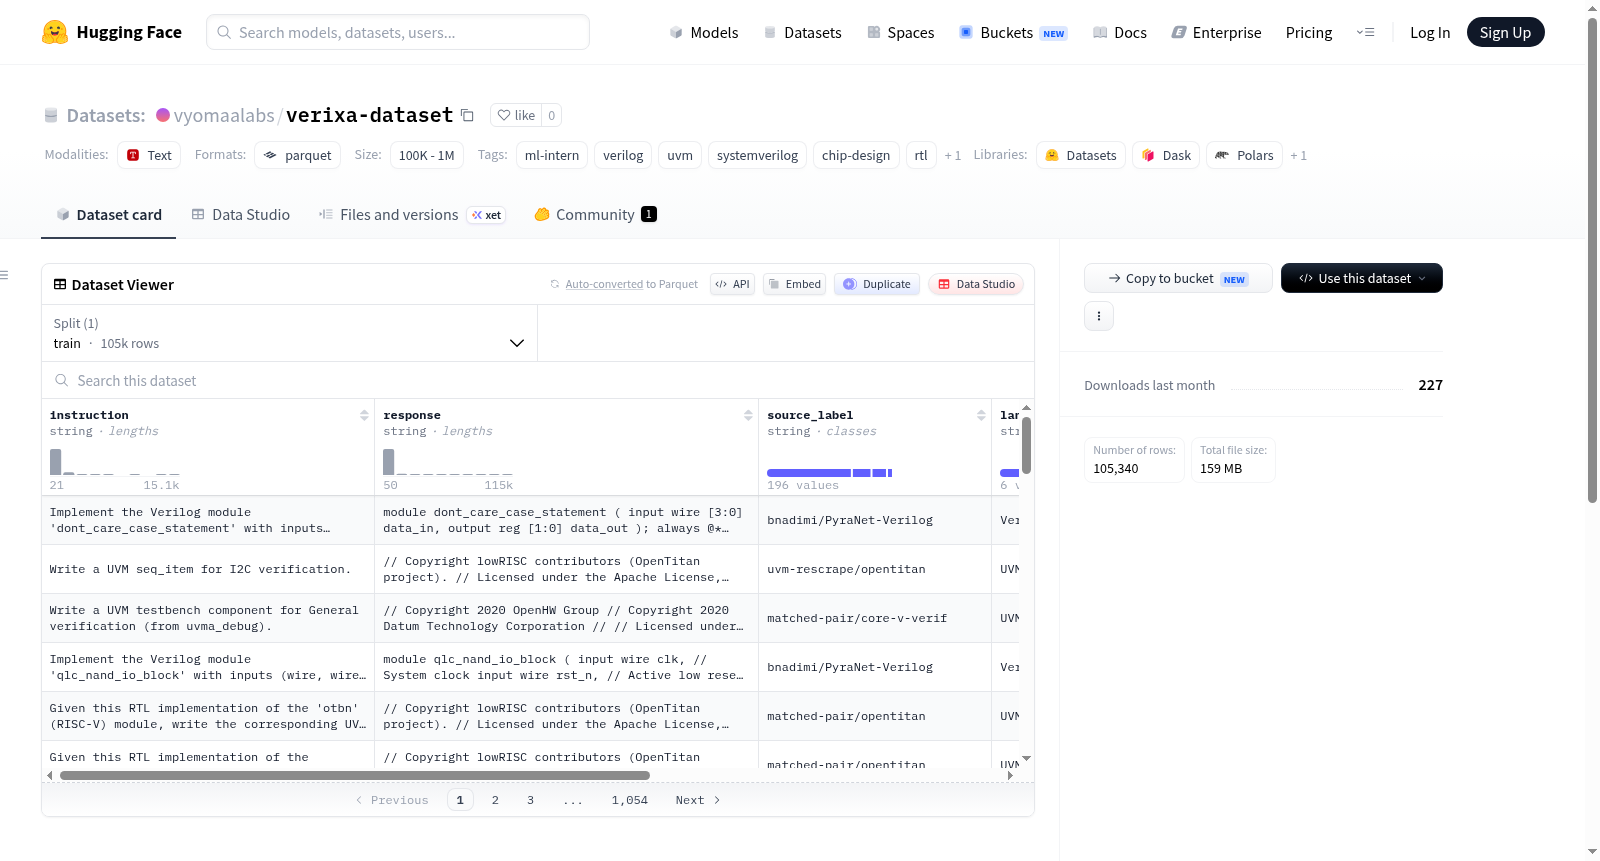
Verixa数据集是一个包含105,340个去重和经过质量过滤样本的数据集,用于在芯片设计任务上微调大型语言模型,涵盖Verilog RTL、UVM验证、SystemVerilog断言、SystemC、EDA脚本和工程工作流推理。
The Verixa Dataset is a collection of 105,340 deduplicated and quality-filtered samples, purpose-built for fine-tuning large language models (LLMs) on chip design tasks. It encompasses Verilog RTL, UVM verification, SystemVerilog assertions, SystemC, EDA scripts, and engineering workflow reasoning.
提供机构:
vyomaalabs原始信息汇总
- 数据集名称: verixa-dataset
- 维护者: vyomaalabs
- 规模: 100K - 1M 条记录
- 格式: Parquet
- 模态: 文本 (Text)
- 标签: ml-intern, verilog, uvm, systemverilog, chip-design, rtl 等
- 支持的库: Datasets, Dask, Polars
- 数据集预览:
- 默认子集 (default),包含约 105k 行数据。
- 默认分割 (train),包含约 105k 行数据。
- 包含以下列:
instruction(string): 硬件设计或验证任务的指令。response(string): 对应的代码或设计实现。source_label(string): 数据来源标签。language(string): 使用的语言,如 Verilog, SystemVerilog, UVM/SystemVerilog。task_type(string): 任务类型,例如 generation, verification, architecture_planning, rtl_to_tb。component_type(string): 组件类型,如 rtl, seq_item, sequence, monitor, env, formal 等。protocol(string): 相关协议或接口,如 General RTL, I2C, Ethernet, RISC-V, AXI4, FIFO, UART, SPI, SHA/HMAC, Memory, Crypto, TileLink 等。
搜集汇总
数据集介绍
构建方式
Verixa数据集汇聚了10万5千余条经过去重与质量筛选的样本,专注于芯片设计领域的语言模型微调。其构建过程系统性地采集了涵盖Verilog RTL、UVM验证、SystemVerilog断言、SystemC及EDA脚本等多类硬件描述与验证语言的典型实例与工作流推理任务,并辅以详细的工程注释,形成了高度专业化的训练资源。
特点
该数据集的核心特点在于其领域深度与数据纯净度。所有样本均经过严格去重与质量过滤,确保无冗余噪声。每条数据包含指令、响应及多维度的元标签,如源标签、语言、任务类型、组件类型和协议,为模型提供了丰富的上下文信息,使其能够精准理解并生成与芯片设计各环节紧密相关的技术内容。
使用方法
研究者可通过HuggingFace的 datasets 库便捷地加载该数据集。仅需一行代码 'load_dataset("vyomaalabs/verixa-dataset", split="train")' 即可获取训练集。数据集的每个样本均以标准格式呈现,可直接用于对大型语言模型进行监督式微调,特别适用于提升模型在硬件描述语言生成、验证环境搭建及工程流程推理等方面的能力。
背景与挑战
背景概述
Verixa数据集诞生于芯片设计自动化与大语言模型交叉研究的前沿领域,由Vyoma Labs团队于近期创建,旨在解决硬件描述语言(HDL)领域专用模型训练数据匮乏的瓶颈问题。该数据集聚焦于寄存器传输级(RTL)设计、通用验证方法学(UVM)测试平台构建、SystemVerilog断言编写及EDA脚本开发等核心芯片设计任务,通过收集并筛选105,340条高质量、去重样本,为领域微调提供了结构化训练资源。其贡献在于突破了传统开源HDL数据集规模小、质量参差不齐的局限,显著推动了LLM在硬件验证与设计自动化方向的应用研究,对降低芯片设计门槛、加速验证流程具有重要的实践价值。
当前挑战
Verixa数据集所应对的领域挑战主要来自芯片设计流程中自然语言与硬件描述语言之间的语义鸿沟,传统LLM难以准确理解RTL结构、时序约束及验证组件间的复杂逻辑关系。构建过程中,团队面临多重困难:首先,从GitHub等开源仓库中采集海量HDL代码时,需剔除重复样本以避免模型过拟合,这要求高效的近似去重算法;其次,原始代码常缺乏注释与文档,标注任务类型(如RTL设计、UVM组件)、验证协议(如AXI、AHB)等工作依赖专家知识,成本高昂;此外,不同工程间的编码风格差异显著,需设计统一的质量过滤标准以剔除低质量或不完整的代码片段,确保数据集的一致性与可用性。
常用场景
经典使用场景
Verixa数据集在芯片设计领域具有广泛的应用前景,特别是在微处理器架构设计、数字信号处理单元开发以及通信协议模块实现等经典场景中。该数据集涵盖了丰富的Verilog RTL代码实例,包括组合逻辑、时序逻辑、状态机和数据通路等核心设计模式。研究人员可以利用这些高质量的语料训练大语言模型,使其能够理解硬件描述语言的语法结构和设计范式,进而自动生成符合规范的RTL代码。在验证领域,数据集中的UVM测试平台和SystemVerilog断言案例为模型学习硬件验证方法论提供了坚实基础,使其能够协助工程师完成功能覆盖率分析和设计规则检查等关键任务。
解决学术问题
Verixa数据集的推出有效解决了芯片设计自动化领域长期存在的标注数据稀缺问题,为学术研究提供了系统化的训练资源。在硬件代码生成研究中,该数据集支持探索基于Transformer架构的代码补全和语法纠错模型,推动了大语言模型在电子设计自动化领域的理论创新。针对跨语言学习挑战,数据集中包含的SystemC和TCL脚本等异构代码使得研究者能够开展多模态硬件描述语言的语义对齐研究。此外,数据集的去重和过滤机制为研究数据质量对模型性能的影响提供了基准实验平台,有助于揭示训练数据分布与硬件代码生成准确性之间的关联规律。
衍生相关工作
基于Verixa数据集已催生多项创新性研究工作,包括针对Verilog代码的功能等价类判别模型,以及结合语法树与注意力机制的RTL逻辑实现预测框架。研究者还开发了面向硬件验证的专用预训练模型,通过对比学习增强UVM序列生成的多样性。在调试领域,相关衍生工作建立了错误类型分类器,能够将仿真日志中的典型问题与具体代码段进行关联定位。这些成果在DAC、ISCA等顶级会议上发表,进一步推动了机器学习与芯片设计的交叉融合。值得注意的是,数据集的Apache-2.0许可协议为学术界和工业界的二次开发设立了自由而规范的合作基础。
以上内容由遇见数据集搜集并总结生成


