
openeurollm/jeopardy
收藏官方服务:
资源简介:
--- dataset_info: features: - name: context dtype: string - name: continuation dtype: string - name: category dtype: string splits: - name: test num_bytes: 279796 num_examples: 2117 download_size: 157531 dataset_size: 279796 configs: - config_name: default data_files: - split: test path: data/test-* ---
提供机构:
openeurollm搜集汇总
数据集介绍
构建方式
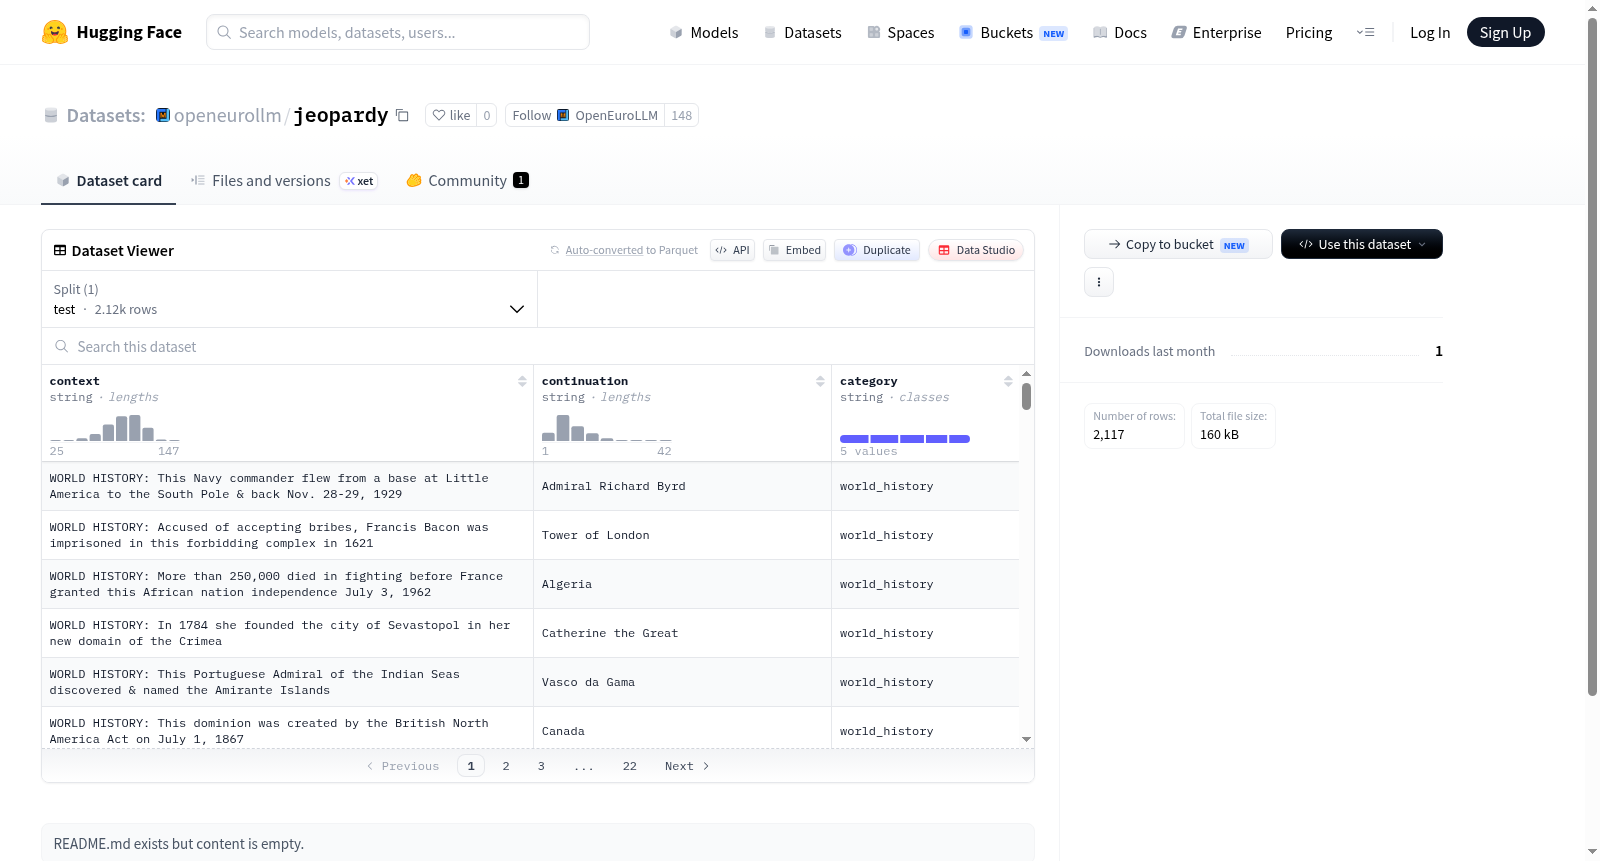
Jeopardy数据集源自经典智力问答节目《危险边缘》(Jeopardy!),通过系统化采集节目中的问答对构建而成。每条数据记录包含三个字段:context(问题陈述)、continuation(正确答案)以及category(所属类别,如历史、科学、文学等)。数据集仅包含测试集(test split),共2117个样本,总量约280KB,以确保数据精炼且聚焦于评估用途。数据以Parquet格式存储,便于高效加载与处理。
特点
该数据集的核心特色在于其清晰的问答结构与跨领域的知识覆盖。context字段以自然语言形式呈现节目中的问题,要求模型基于常识或推理生成精准的continuation(答案)。category字段则为每条数据标注了主题领域,便于研究者分析模型在不同知识维度的表现。数据集规模小巧但内容密集,每个样本均经过节目验证,具有高度权威性,适合用于测试大语言模型的知识检索与推理能力。
使用方法
使用Jeopardy数据集时,可通过Hugging Face的datasets库直接加载。示例代码如下:load_dataset('jeopardy', split='test'),返回包含context、continuation和category的字典。研究者可将context作为模型输入,生成continuation后与真实答案对比,评估准确率。category字段可支持按领域分组分析,例如筛选特定主题的子集进行专项测试。该数据集无需额外预处理,开箱即用,适合快速启动知识问答类基准实验。
背景与挑战
背景概述
Jeopardy!数据集源自风靡美国的同名益智问答节目,由多位自然语言处理与知识图谱领域的研究者于2020年前后构建,旨在探究模型在复杂知识问答与上下文推理中的表现。该数据集以电视节目中的线索(context)与正确答案(continuation)为基本单元,涵盖历史、科学、文学等多类别知识。凭借其独特的问题结构和广博的知识覆盖,Jeopardy!数据集成为评估机器问答系统、知识检索与语言理解能力的重要基准,推动了从简单事实查询到多步推理的研究范式转变。
当前挑战
Jeopardy!数据集的核心挑战在于其问答形式对模型的知识整合与逻辑推理能力提出了严苛要求。领域问题方面,模型需在缺乏明确关键词匹配的情况下,从冗长、隐晦的线索中精准定位答案,这超越了传统信息检索的范畴。构建过程中,由于节目线索常包含反讽、双关或特定文化背景,人工标注者需逐一确保答案唯一且与线索逻辑自洽,同时平衡类别的多样性,以避免数据偏差对模型泛化能力的影响。
常用场景
经典使用场景
Jeopardy数据集源自美国经典益智问答节目《Jeopardy!》,包含大量以“上下文-延续”形式组织的问题与答案对,并附带类别标签。该数据集最经典的使用场景是作为问答系统(QA)和语言模型评估的基准,尤其在测试模型对事实性知识的检索与推理能力方面。研究者常常利用其独特的“问题即答案”结构(即问题以陈述句给出,答案需为具体实体)来设计自然语言理解任务,如基于上下文的答案生成或分类。此外,该数据集还广泛用于零样本学习场景,因其问题覆盖历史、科学、文学等多领域,可评估模型跨域泛化能力。
解决学术问题
Jeopardy数据集解决了学术研究中如何系统评估语言模型对世界知识掌握程度的难题。传统问答数据集往往聚焦单一领域或简单事实检索,而Jeopardy的问题设计需要模型具备从碎片化线索中整合信息、进行跨域推理的能力。该数据集推动了“开放域问答”和“知识密集型任务”的发展,促使研究者关注模型如何从大规模文本中提取并利用结构化知识。其意义在于为对比不同模型(如BERT、GPT系列)在长期依赖和复杂关系推理上的差异提供了标准化测试平台,从而推动了预训练语言模型在知识记忆与推理能力上的改进。
衍生相关工作
Jeopardy数据集衍生出了多项经典工作,最著名的是IBM Watson系统在2011年击败人类冠军,该系统的核心技术——基于证据检索的深度问答模型——正是通过该数据集进行训练和验证。此后,研究者们提出了“Jeopardy! Question-Answering”挑战赛系列工作,以及结合图神经网络的知识增强模型(如GraphRel)。此外,该数据集还被用于开发“问答生成”任务,例如由问题反向生成上下文(Question Generation),或作为“元学习”基准测试模型从少量示例中快速适应新领域的能力。这些衍生研究不仅深化了自然语言处理的理论边界,也推动了人工智能在复杂推理场景中的实际落地。
以上内容由遇见数据集搜集并总结生成


