MaDI-Bench
收藏资源简介:
MaDI-Bench是一个端到端的数据集成基准测试,用于评估关系表的完整集成过程。它覆盖了五个领域(游戏、公司、音乐、产品、科学论文),每个领域包含基础任务及简单、中等、困难变体。基准测试提供了每个集成步骤(模式匹配、值规范化、实体分块、实体匹配和数据融合)的真实标注数据,包括超过93,000个标注记录对、1,000个人工验证的融合记录以及近11,000个人工验证的属性值。所有数据以CSV、JSON、XML等常见格式提供,支持逐步和端到端的性能评估。
MaDI-Bench is an end-to-end data integration benchmark designed to evaluate the full integration workflow of relational tables. It covers five domains: games, companies, music, products, and scientific papers. Each domain includes a basic task alongside simple, moderate, and difficult variants. The benchmark provides ground-truth annotated data for each core data integration step, including schema matching, value normalization, entity blocking, entity matching, and data fusion. It contains over 93,000 annotated record pairs, 1,000 manually verified fused records, and nearly 11,000 manually verified attribute values. All data is provided in common formats such as CSV, JSON, XML and other standard formats, supporting both step-by-step and end-to-end performance evaluation.
MaDI-Bench:端到端数据集成基准
概述
MaDI-Bench(Mannheim Data Integration Benchmark)是首个用于评估关系型表格完整端到端集成的公开基准。它填补了现有基准仅评估集成流程中孤立步骤或缺失特定环节的空白,旨在衡量数据集成系统处理整个流程的综合性能。
核心任务与流程
每个MaDI任务接收多个异构源表作为输入,要求系统输出一个符合给定目标模式、且每个真实世界实体仅包含一条记录的单张输出表。解决任务需要处理数据集成流程的所有步骤:
- 模式匹配
- 值归一化
- 实体分块
- 实体匹配
- 数据融合
基准包含内容
- 5个领域,20个集成任务:涵盖游戏、公司、音乐、产品和科学论文。每个领域包含一个基础任务及简单、中等、困难三个变体。
- 全流程的标注数据(Ground Truth):包括黄金模式映射、带标签的实体匹配训练/验证/测试集,以及人工验证的数据融合验证集和测试集。
- 变体生成方法:基于八个可控的难度旋钮(difficulty knobs),为基础任务派生出不同难度的变体,确保基准随系统进步持续有效。
- 验证运行:提供三条参考管线的验证结果:人工构建管线、最佳组合管线以及基于LLM的管线。
数据规模与格式
五个基础任务的工件包含超过93,000个标注记录对(用于实体匹配)、1,000条人工验证的融合记录(携带近11,000个人工验证的属性值),以及每个任务的黄金模式映射。所有工件均以通用格式(CSV、JSON、XML)发布。
仓库结构
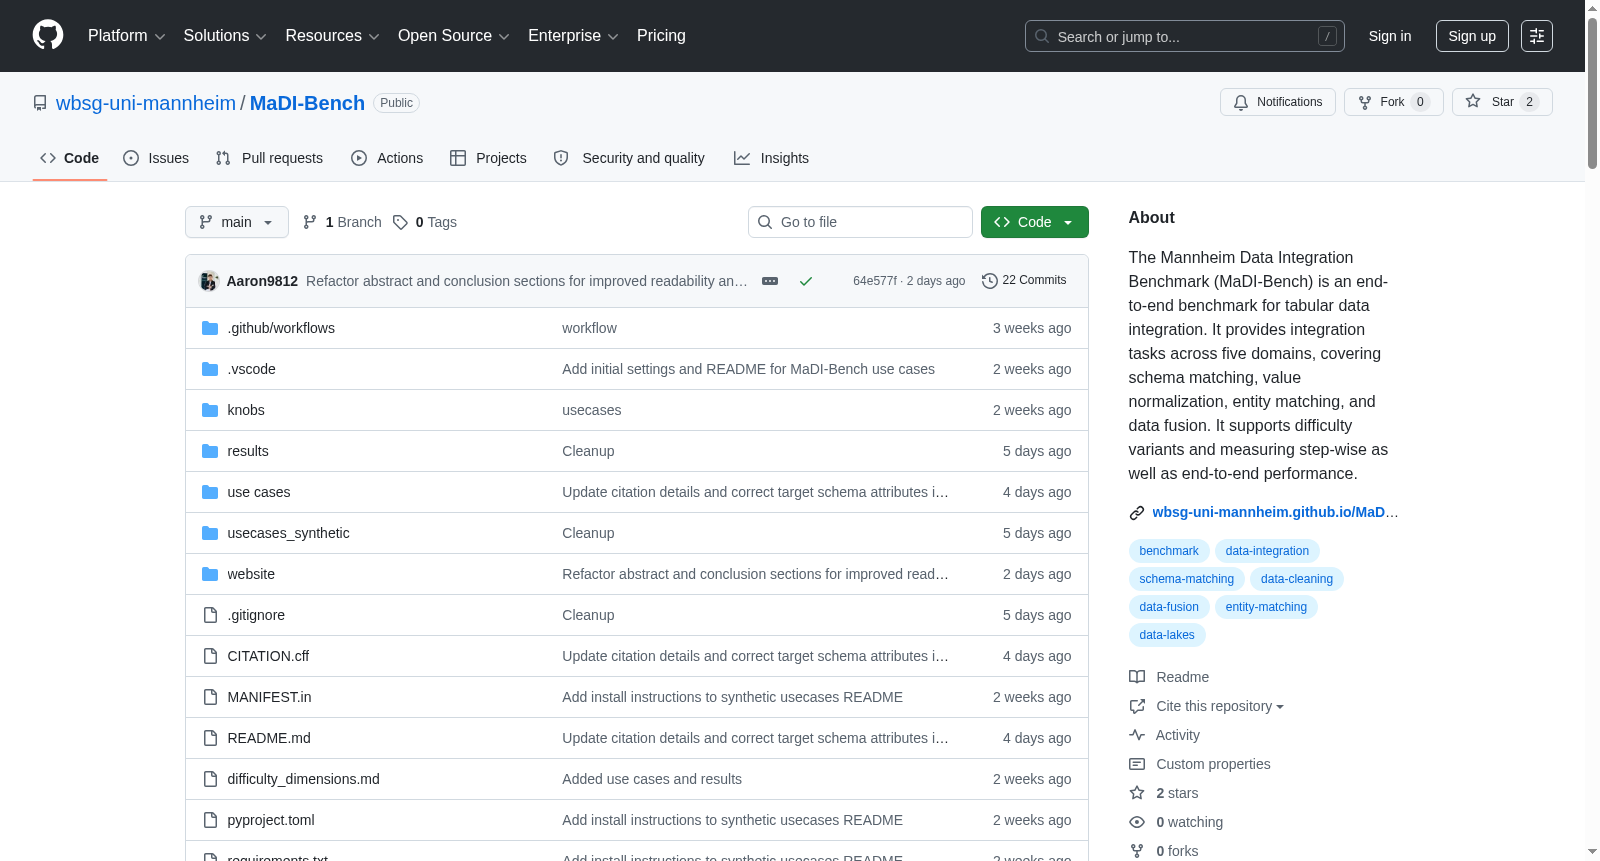
use cases/:基准本身,包含全部20个集成任务的输入、标注数据及参考输出。results/:验证运行结果,包含最佳组合管线(results/best of breeds/)和LLM管线(results/llm pipeline/)。knobs/:八个难度旋钮的规格说明。difficulty_dimensions.md:旋钮所操作的分阶段难度维度说明。usecases_synthetic/:变体生成管线的代码、配置和测试。
任务目录结构示例
每个任务(use cases/<领域>/<难度>/)包含:
input/data/:源表(CSV)及schema.org元数据文件(JSON)。input/schemamatching/:目标模式(JSON Schema)、黄金模式映射、分类法CSV。input/entitymatching/:标注的实体匹配训练/验证/测试集。input/fusion/:标注的融合记录文件。config/:难度配置文件(仅变体任务)。output/:人工管线的参考输出。
如何开始
任何集成系统可直接消费任务文件:源表为CSV格式,每个表附有schema.org元数据;目标模式为JSON Schema格式,固定了输出列、属性值约束及分类层次。用户可使用PyDI数据集成框架复现参考管线或利用分阶段评估类进行自定义评估。
参考文献
如需引用MaDI-Bench,请引用:
@misc{steiner2026madibench, title = {MaDI-Bench: An End-to-End Data Integration Benchmark}, author = {Steiner, Aaron and Peeters, Ralph and Bizer, Christian}, year = {2026}, eprint = {2606.30371}, archivePrefix = {arXiv}, primaryClass = {cs.DB}, url = {https://arxiv.org/abs/2606.30371} }