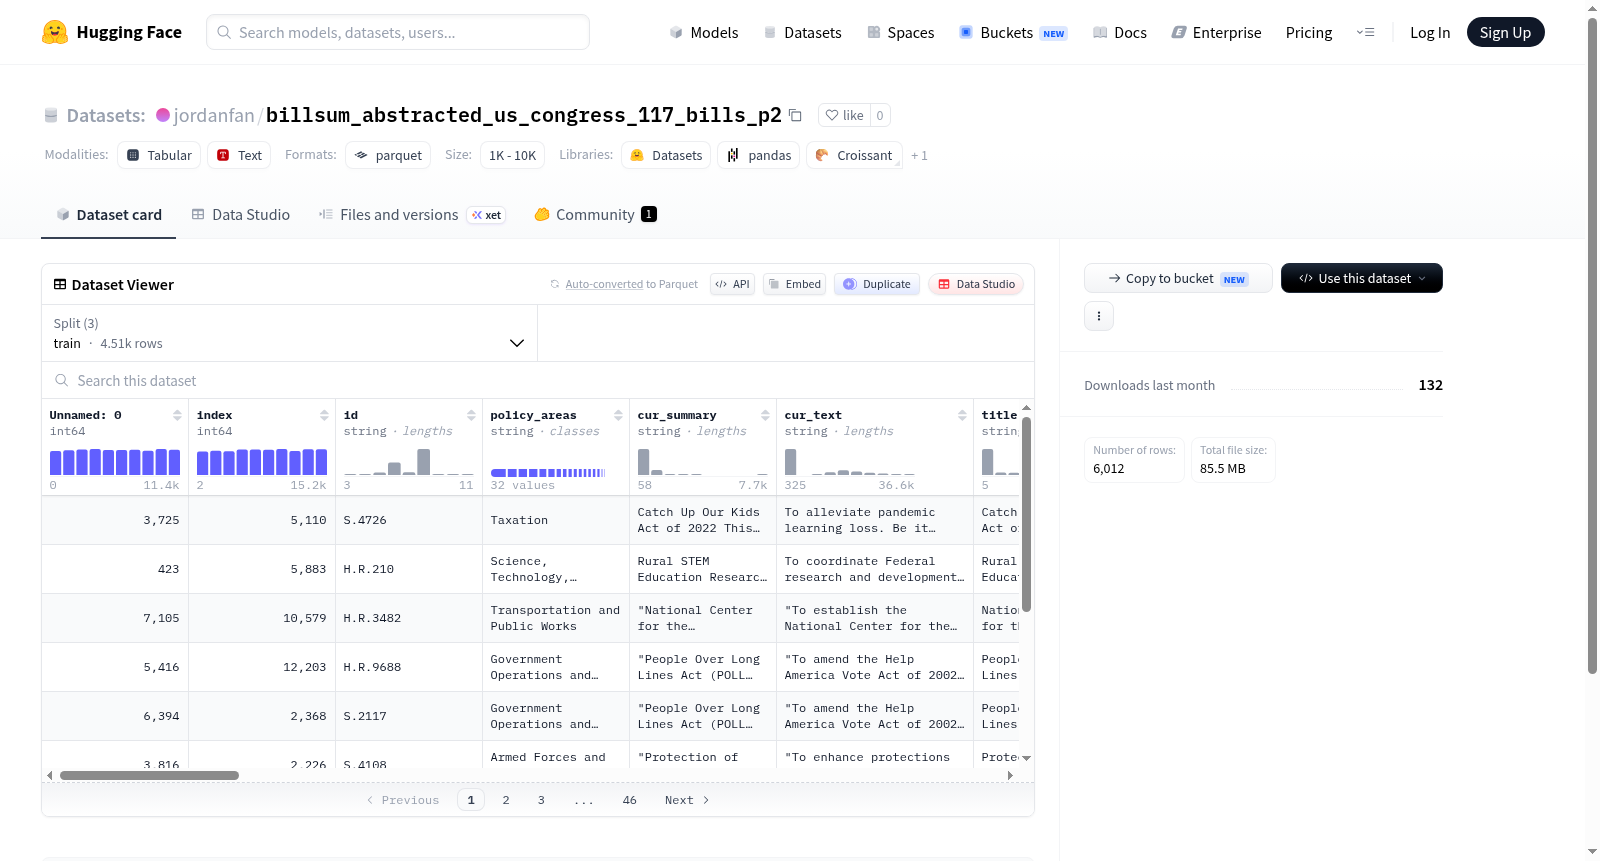
jordanfan/billsum_abstracted_us_congress_117_bills_p2
收藏资源简介:
--- dataset_info: features: - name: 'Unnamed: 0' dtype: int64 - name: index dtype: int64 - name: id dtype: string - name: policy_areas dtype: string - name: cur_summary dtype: string - name: cur_text dtype: string - name: title dtype: string - name: titles_official dtype: string - name: titles_short dtype: string - name: sponsor_name dtype: string - name: sponsor_party dtype: string - name: sponsor_state dtype: string - name: cleaned_summary dtype: string - name: extracted_text dtype: string - name: extracted_text_375 dtype: string - name: extracted_text_750 dtype: string - name: extracted_text_1000 dtype: string - name: bertsum_extracted_250 dtype: string - name: bertsum_extracted_375 dtype: string - name: bertsum_extracted_375_1000 dtype: string - name: bertsum_extracted_250_1000 dtype: string - name: bertsum_extracted_375_750 dtype: string - name: bertsum_extracted_250_750 dtype: string - name: bertsum_extracted_375_500 dtype: string - name: bertsum_extracted_250_500 dtype: string - name: bertsum_extracted_375_375 dtype: string - name: bertsum_extracted_250_375 dtype: string - name: text_len dtype: int64 - name: billsum_abstracted_1000 dtype: string splits: - name: train num_bytes: 152287149 num_examples: 4505 - name: val num_bytes: 47132749 num_examples: 1353 - name: test num_bytes: 5401931 num_examples: 154 download_size: 85517487 dataset_size: 204821829 configs: - config_name: default data_files: - split: train path: data/train-* - split: val path: data/val-* - split: test path: data/test-* ---
数据集信息: 特征字段: - 名称:未命名列0(Unnamed: 0),数据类型:64位整型(int64) - 名称:索引(index),数据类型:64位整型(int64) - 名称:ID(id),数据类型:字符串类型(string) - 名称:政策领域(policy_areas),数据类型:字符串类型(string) - 名称:当前摘要(cur_summary),数据类型:字符串类型(string) - 名称:当前文本(cur_text),数据类型:字符串类型(string) - 名称:标题(title),数据类型:字符串类型(string) - 名称:官方标题(titles_official),数据类型:字符串类型(string) - 名称:简称标题(titles_short),数据类型:字符串类型(string) - 名称:发起人姓名(sponsor_name),数据类型:字符串类型(string) - 名称:发起党派(sponsor_party),数据类型:字符串类型(string) - 名称:发起州(sponsor_state),数据类型:字符串类型(string) - 名称:清洗后摘要(cleaned_summary),数据类型:字符串类型(string) - 名称:提取文本(extracted_text),数据类型:字符串类型(string) - 名称:提取文本(375)(extracted_text_375),数据类型:字符串类型(string) - 名称:提取文本(750)(extracted_text_750),数据类型:字符串类型(string) - 名称:提取文本(1000)(extracted_text_1000),数据类型:字符串类型(string) - 名称:基于BertSum提取的250长度文本(bertsum_extracted_250),数据类型:字符串类型(string) - 名称:基于BertSum提取的375长度文本(bertsum_extracted_375),数据类型:字符串类型(string) - 名称:基于BertSum提取的375-1000范围文本(bertsum_extracted_375_1000),数据类型:字符串类型(string) - 名称:基于BertSum提取的250-1000范围文本(bertsum_extracted_250_1000),数据类型:字符串类型(string) - 名称:基于BertSum提取的375-750范围文本(bertsum_extracted_375_750),数据类型:字符串类型(string) - 名称:基于BertSum提取的250-750范围文本(bertsum_extracted_250_750),数据类型:字符串类型(string) - 名称:基于BertSum提取的375-500范围文本(bertsum_extracted_375_500),数据类型:字符串类型(string) - 名称:基于BertSum提取的250-500范围文本(bertsum_extracted_250_500),数据类型:字符串类型(string) - 名称:基于BertSum提取的375-375范围文本(bertsum_extracted_375_375),数据类型:字符串类型(string) - 名称:基于BertSum提取的250-375范围文本(bertsum_extracted_250_375),数据类型:字符串类型(string) - 名称:文本长度(text_len),数据类型:64位整型(int64) - 名称:基于Billsum生成的1000长度抽象摘要(billsum_abstracted_1000),数据类型:字符串类型(string) 数据集划分: - 划分集:训练集(train),字节数:152287149,样本量:4505 - 划分集:验证集(val),字节数:47132749,样本量:1353 - 划分集:测试集(test),字节数:5401931,样本量:154 下载总大小:85517487字节,数据集总大小:204821829字节 配置信息: - 配置名称:默认(default),数据文件路径: - 训练集:data/train-* - 验证集:data/val-* - 测试集:data/test-*
数据集特征
- Unnamed: 0:整数类型
- index:整数类型
- id:字符串类型
- policy_areas:字符串类型
- cur_summary:字符串类型
- cur_text:字符串类型
- title:字符串类型
- titles_official:字符串类型
- titles_short:字符串类型
- sponsor_name:字符串类型
- sponsor_party:字符串类型
- sponsor_state:字符串类型
- cleaned_summary:字符串类型
- extracted_text:字符串类型
- extracted_text_375:字符串类型
- extracted_text_750:字符串类型
- extracted_text_1000:字符串类型
- bertsum_extracted_250:字符串类型
- bertsum_extracted_375:字符串类型
- bertsum_extracted_375_1000:字符串类型
- bertsum_extracted_250_1000:字符串类型
- bertsum_extracted_375_750:字符串类型
- bertsum_extracted_250_750:字符串类型
- bertsum_extracted_375_500:字符串类型
- bertsum_extracted_250_500:字符串类型
- bertsum_extracted_375_375:字符串类型
- bertsum_extracted_250_375:字符串类型
- text_len:整数类型
- billsum_abstracted_1000:字符串类型
数据集分割
- 训练集 (train):
- 字节数:152287149
- 示例数:4505
- 验证集 (val):
- 字节数:47132749
- 示例数:1353
- 测试集 (test):
- 字节数:5401931
- 示例数:154
数据集大小
- 下载大小:85517487字节
- 数据集总大小:204821829字节