
遇见数据集

zachz/AV-SpeakerBench-PC

收藏
Hugging Face2026-04-30 更新2026-05-03 收录
官方服务:

资源简介:

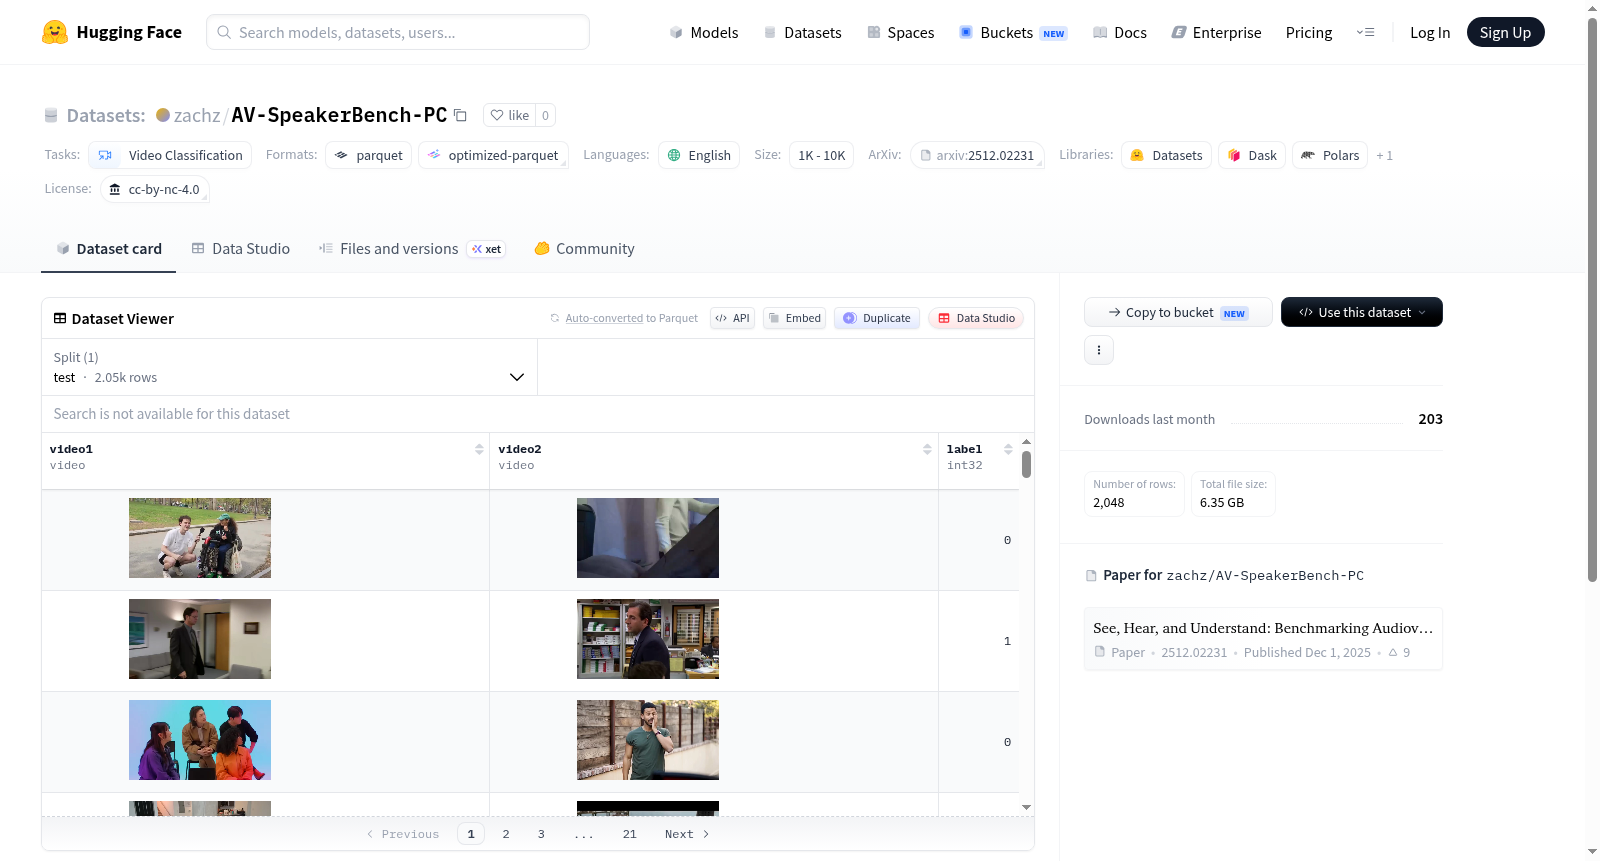
AV-SpeakerBench-PC是一个来自AV-SpeakerBench论文(Nguyen et al., 2025)的视频对分类数据集。每条数据包含两个视频片段(video1, video2)和一个二进制标签,标签表示这两个视频片段是否来自同一源视频(同一说话者)或不同源视频(不同说话者)。数据集经过去重处理,包含2048个平衡的视频对,这些视频对来自YouTube源视频ID。数据集格式包含视频和整型标签,适用于视频分类任务,语言为英语。

AV-SpeakerBench-PC is a video pair classification dataset from the AV-SpeakerBench paper (Nguyen et al., 2025). Each row contains two video clips (video1, video2) and a binary label indicating whether they come from the same source video (same speaker context) or different source videos (different speakers). The dataset is deduplicated and contains 2048 balanced pairs generated from YouTube source video IDs. The data format includes videos and integer labels, suitable for video classification tasks, with English as the language.
提供机构:
zachz
搜集汇总
数据集介绍
zachz/AV-SpeakerBench-PC 数据集图片
构建方式
AV-SpeakerBench-PC数据集源自AV-SpeakerBench项目,由Nguyen等人于2025年提出。该数据集聚焦于视频配对分类任务,其构建基础是YouTube平台上的原始视频资源。每一数据样本包含两段视频剪辑(video1与video2),并配有一个二元标签,用于指示这两段视频是否源自同一原始视频,即是否来自相同的说话者情境。为确保数据质量与平衡性,研究团队对原始数据集“mteb/AV-SpeakerBench”进行了基于video_id的去重处理,最终生成了2048对平衡样本,构成测试集。
特点
该数据集具有鲜明的二元分类特性,核心在于评估模型辨识视频间说话者身份一致性的能力。其样本结构简洁而精炼,每行仅包含两个视频字段与一个整型标签,标签值为0或1,分别代表不同说话者与同一说话者。2048个测试样本数量适中,兼顾了评估的全面性与计算的效率。数据集的视频内容全部来源于英语环境下的YouTube视频,确保了语料背景的真实性与多样性。此外,采用CC-BY-NC-4.0许可协议发布,为学术研究提供了开放且合法的使用保障。
使用方法
使用AV-SpeakerBench-PC数据集时,研究者可将其直接作为视频分类任务的测试基准。加载数据后,需分别处理video1与video2两个视频输入,通过设计特征提取与对比学习机制,输出一个二元预测结果。模型架构可选择双流网络或共享权重的单流网络,以捕捉两段视频在视觉、音频乃至说话者身份特征上的关联性。最终,通过计算预测标签与真实标签的一致性,评估模型在说话者辨识场景下的表现。该数据集特别适合用于验证多模态视频理解系统在跨片段决策任务上的鲁棒性。
背景与挑战
背景概述
AV-SpeakerBench-PC是由Nguyen等人于2025年创建的视频对分类数据集,源自AV-SpeakerBench项目,旨在解决多模态说话人识别与验证中的核心问题——区分视频片段是否源自同一说话人场景。该数据集从YouTube源视频中提取2048个平衡对,通过去重与标注构建,为视频分类任务提供了标准化的评估基准。其研究聚焦于同一说话人上下文的判别,对于推动视听联合建模、说话人一致性检测等领域具有重要影响力,尤其为跨模态特征对齐与语义匹配的研究提供了可靠的实验平台。
当前挑战
AV-SpeakerBench-PC所解决的领域挑战是视频分类中说话人身份与上下文的精确判别,尤其在多模态场景下,需应对背景噪声、视角变化以及片段间语义差异带来的混淆。构建过程中面临的核心挑战包括:从海量YouTube视频中高效筛选并去重,确保正负例对的平衡性与代表性;同时需保证视频对的时间对齐与内容独立性,避免因视频片段时长、画质或音频质量不均而导致标签噪声,从而影响模型评估的公正性与可重复性。
常用场景
经典使用场景
AV-SpeakerBench-PC数据集专为视频对分类任务设计,其核心应用场景在于判断两段视频片段是否源自同一说话人。在多媒体内容分析领域,该数据集为研究者提供了标准化评估基准,可用于验证模型对说话人身份的跨片段一致性识别能力。通过2048对精心平衡的正负样本,该数据集能够有效衡量模型在区分同源与异源视频上的性能表现。
衍生相关工作
基于AV-SpeakerBench-PC,研究者已发展了多项衍生工作。Nguyen等人(2025)在提出AV-SpeakerBench整体框架时,即在该数据集上验证了多模态对比学习方法的有效性。此外,该数据集常被用于评估视听特征融合网络,如基于Transformer的跨注意力模型,以及说话人嵌入的鲁棒性分析。这些工作共同完善了视听说话人验证的理论体系。
数据集最近研究
最新研究方向
AV-SpeakerBench-PC作为基于YouTube源视频构建的视听说话人配对分类基准,其前沿研究方向聚焦于多模态说话人表征的细粒度判别能力评测。该数据集通过2048对平衡视频片段构建二分类任务,直接关联当前视听场景理解中说话人身份一致性检测这一热点问题。在跨模态对齐技术飞速发展的背景下,AV-SpeakerBench-PC为验证模型在复杂声学环境与视觉遮挡条件下,是否真正学习到说话人身份的不变表征提供了关键测试平台。其意义在于推动视听大模型从静态特征匹配转向动态上下文感知的说话人判别,尤其对会议系统、虚拟数字人等需要多模态人机交互的工业应用具有重要参考价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

