MohammadKhosravi/cefr-llama3.1-8b-hidden-states-combined
收藏资源简介:
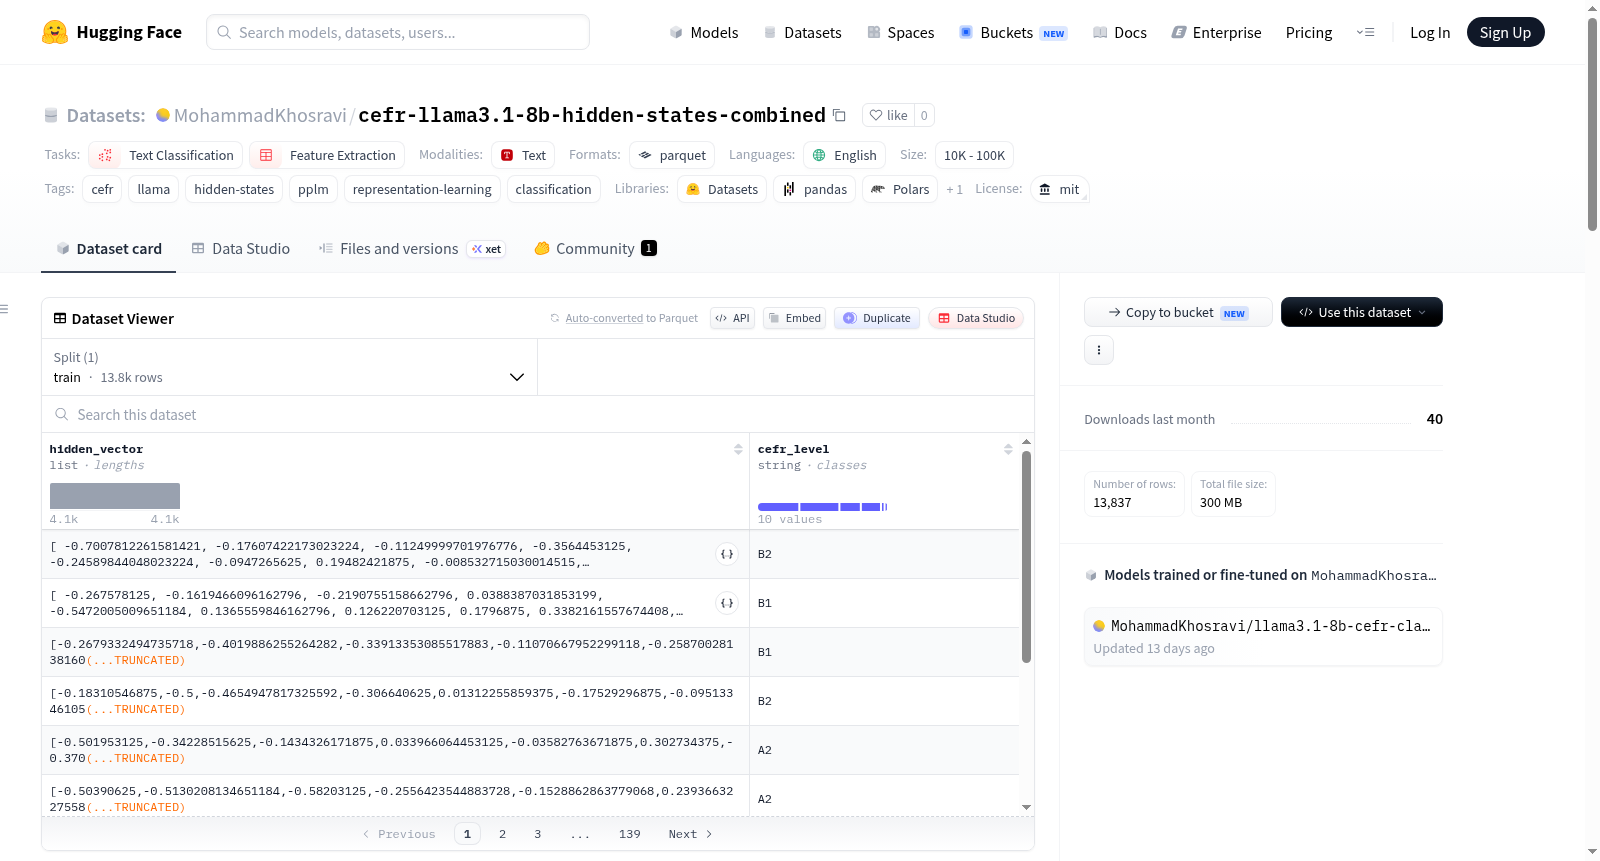
该数据集包含从冻结的meta-llama/Llama-3.1-8B-Instruct变压器架构提取的高保真一维潜在表示。它映射了13,837个英语句子到欧洲语言共同参考框架(CEFR)的六个离散熟练度等级(从A1到C2)。该资源专为支持插件和播放语言模型(PPLM)架构的第一阶段而设计,允许研究人员训练下游轻量级线性转向分类器,而无需在多个训练周期中将重型多亿参数语言资产存储在活动GPU内存中。数据集整合了四个不同的开源CEFR数据流,以最大化风格差异、消除高维特征饥饿并构建鲁棒的语言分类边界。数据集结构包括一个训练分割,包含两个核心特征:hidden_vector(通过第31层激活的注意力感知平均池化生成的4096维向量)和cefr_level(目标分类熟练度标签,如A1、A2等,包括标准化+标签)。类别分布遵循高斯分布,其中B1和B2占比最高,A1和C2占比较低。特征提取方法基于确定性并行预填充处理配置,包括模型基线、注意力感知池化、数据清洗和全局随机化。数据集适用于训练独立的单层线性分类矩阵作为PPLM转向头。
This dataset contains high-fidelity 1D latent representations extracted from the frozen meta-llama/Llama-3.1-8B-Instruct Transformer architecture. It maps 13,837 English sentences to six discrete proficiency levels of the Common European Framework of Reference for Languages (CEFR), ranging from A1 to C2. This resource is specifically designed to support the first stage of the Plug-and-Play Language Model (PPLM) architecture, enabling researchers to train downstream lightweight linear steering classifiers without needing to store heavy multi-billion parameter language assets in active GPU memory across multiple training epochs. The dataset integrates four distinct open-source CEFR data streams to maximize stylistic diversity, mitigate high-dimensional feature starvation, and construct robust language classification boundaries. The dataset structure includes a training split with two core features: `hidden_vector` (a 4096-dimensional vector generated via attention-aware average pooling of layer 31 activations) and `cefr_level` (the target classification proficiency label, e.g., A1, A2, etc., including standardized labels). The class distribution follows a Gaussian distribution, with B1 and B2 accounting for the highest proportions, while A1 and C2 have relatively low proportions. The feature extraction method is based on a deterministic parallel prefill processing configuration, including model baselines, attention-aware pooling, data cleaning, and global randomization. The dataset is suitable for training independent single-layer linear classification matrices as PPLM steering heads.