遇见数据集

liuyanchen1015/VALUE_mnli_null_genetive

收藏
Hugging Face2022-11-28 更新2024-03-04 收录
官方服务:

资源简介:

--- dataset_info: features: - name: premise dtype: string - name: hypothesis dtype: string - name: label dtype: int64 - name: idx dtype: int64 - name: score dtype: int64 splits: - name: train num_bytes: 12248137 num_examples: 50122 - name: dev_matched num_bytes: 283868 num_examples: 1167 - name: dev_mismatched num_bytes: 330715 num_examples: 1276 - name: test_matched num_bytes: 297546 num_examples: 1245 - name: test_mismatched num_bytes: 343629 num_examples: 1336 download_size: 8810876 dataset_size: 13503895 --- # Dataset Card for "VALUE2_mnli_null_genetive" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

数据集信息: 特征字段: - 名称: 前提(premise) 数据类型: 字符串 - 名称: 假设(hypothesis) 数据类型: 字符串 - 名称: 标签(label) 数据类型: 64位整型 - 名称: 样本索引(idx) 数据类型: 64位整型 - 名称: 得分(score) 数据类型: 64位整型 数据集划分: - 名称: 训练集(train) 字节大小: 12248137 样本数量: 50122 - 名称: 匹配验证集(dev_matched) 字节大小: 283868 样本数量: 1167 - 名称: 不匹配验证集(dev_mismatched) 字节大小: 330715 样本数量: 1276 - 名称: 匹配测试集(test_matched) 字节大小: 297546 样本数量: 1245 - 名称: 不匹配测试集(test_mismatched) 字节大小: 343629 样本数量: 1336 下载大小: 8810876 数据集总大小: 13503895 --- # 「VALUE2_mnli_null_genetive」数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
liuyanchen1015
原始信息汇总

数据集概述

数据集名称

  • 名称: VALUE2_mnli_null_genetive

数据集特征

  • 特征列表:
    • premise: 数据类型为 string
    • hypothesis: 数据类型为 string
    • label: 数据类型为 int64
    • idx: 数据类型为 int64
    • score: 数据类型为 int64

数据集分割

  • 分割详情:
    • train: 大小为 12248137 字节,包含 50122 个样本
    • dev_matched: 大小为 283868 字节,包含 1167 个样本
    • dev_mismatched: 大小为 330715 字节,包含 1276 个样本
    • test_matched: 大小为 297546 字节,包含 1245 个样本
    • test_mismatched: 大小为 343629 字节,包含 1336 个样本

数据集大小

  • 下载大小: 8810876 字节
  • 数据集总大小: 13503895 字节
搜集汇总
数据集介绍
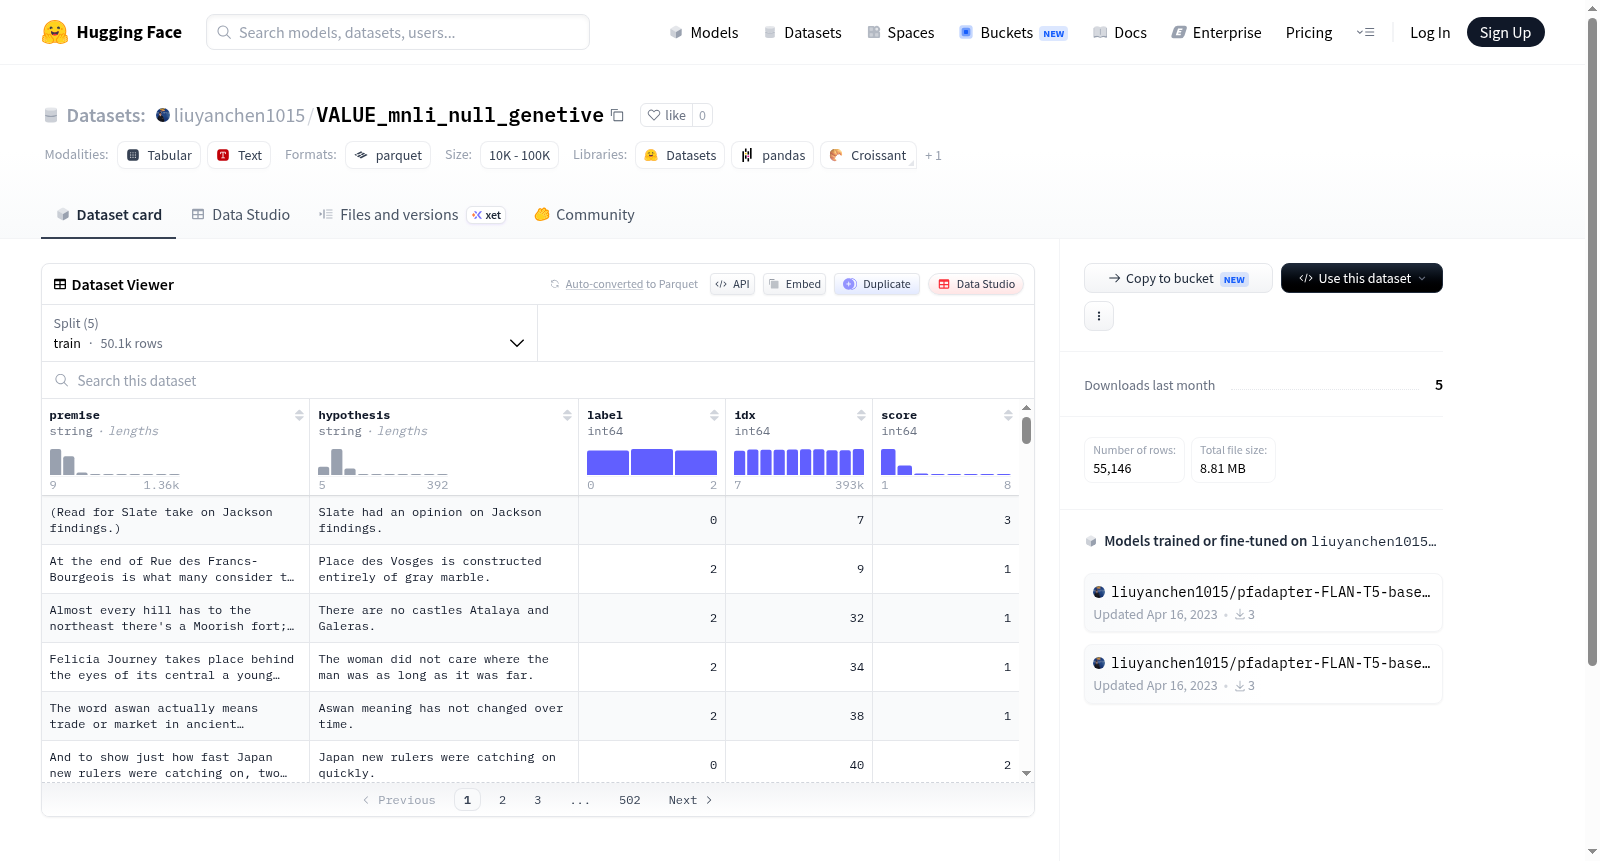
liuyanchen1015/VALUE_mnli_null_genetive 数据集图片
构建方式
该数据集基于广泛使用的自然语言推理基准MNLI(Multi-Genre Natural Language Inference)进行构建,聚焦于“空属格”(null genetive)这一特定语言现象。通过筛选和改造原始MNLI中的样本,确保前提(premise)与假设(hypothesis)之间存在由属格省略引发的语义歧义或推理挑战。数据集的构建过程包括对原始语料的精细标注与质量校验,最终形成包含约5万条训练样本、以及匹配与非匹配两种模式的开发集与测试集,共计五个子集,以支持多维度评估。
特点
数据集的核心特点在于其专注于“空属格”这一细粒度语言学现象,为探究自然语言理解模型在特定句法结构下的推理能力提供了独特视角。每个样本均包含前提、假设、标签、索引与置信度得分五个字段,其中标签为整数类型的分类结果。数据规模适中,训练集包含50122条样本,开发集与测试集分别按领域匹配与否进行划分,总计约5.5万条样本,便于研究者快速迭代与验证。
使用方法
该数据集适用于自然语言推理任务的模型训练与评估,尤其适合分析模型对属格省略结构的敏感度。使用时,可直接通过HuggingFace Datasets库加载,按标准NLI流程将前提与假设输入模型,预测其蕴含、矛盾或中立关系。建议采用预训练语言模型(如BERT、RoBERTa)进行微调,并利用提供的匹配与非匹配子集分别评估模型在领域内与跨领域场景下的泛化能力。
背景与挑战
背景概述
在自然语言推理(NLI)领域,模型对语言细微差异的敏感性一直是研究的核心议题。由liuyanchen1015等人于近期创建的VALUE_mnli_null_genetive数据集,旨在探索英语中属格结构(如's所有格与of属格)在前提与假设间的语义影响。该数据集基于广泛使用的MNLI语料库进行改造,通过精心设计包含属格变体的句子对,聚焦于模型能否准确区分属格省略或替换带来的逻辑关系变化。其核心研究问题在于揭示大规模预训练语言模型在处理零指代或属格歧义时的鲁棒性缺陷,为提升NLI系统在复杂语言学结构上的理解能力提供了关键测试基准,对推动细粒度语义推理研究具有重要价值。
当前挑战
当前该数据集面临的主要挑战体现在两个层面。首先是领域问题层面,属格结构在自然语言中常与所有格、来源或描述性关系交织,现有NLI模型往往依赖表面词汇匹配而非深层句法理解,导致在属格省略(如将'John's book'简化为'the book')或属格类型转换时产生推理偏差。其次是构建过程中的挑战,原始MNLI数据需人工筛选并生成符合属格变体的句子对,既要确保语义等价性不被破坏,又要避免引入额外噪声,这对标注者的语言学素养和一致性控制提出了极高要求。此外,属格现象在不同语域(如法律文本与日常对话)中的分布不均,使得跨领域泛化测试(如dev_mismatched与test_mismatched划分)成为评估模型鲁棒性的关键难点。
常用场景
经典使用场景
在自然语言推理(NLI)研究领域,VALUE_mnli_null_genetive数据集通过精心设计的“空所有格”语言现象,为探究模型在句法歧义与语义约束下的推理能力提供了关键测试平台。该数据集以MNLI为基础框架,聚焦于所有格结构缺失(如“John’s book”简化为“John book”)时模型对前提与假设间蕴含、矛盾或中立关系的判别,成为评估大语言模型对英语隐性语法规则敏感度的经典基准。
实际应用
在实际应用中,VALUE_mnli_null_genetive数据集直接服务于对话系统、智能问答与文本审核等场景的鲁棒性提升。例如,在口语化或非正式文本(如社交媒体评论、语音转录内容)中,所有格省略频繁出现,该数据集训练的模型能更精准地识别用户意图,避免因句法简化导致的推理错误,从而增强人机交互的连贯性与可信度。
衍生相关工作
基于该数据集,衍生出多项关于“语言特异性推理挑战”的经典工作,包括探索模型对零代词、省略结构等跨语言现象的迁移学习研究,以及针对NLI任务中语法扰动对抗性样本的生成与防御机制。此外,该数据集的构建范式启发了后续如“VALUE”系列中其他语言变体(如时态省略、冠词缺失)的基准创建,共同推动了NLI领域从标准语料到生态化语言理解的演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务