
遇见数据集

TTS-AGI/dramabox-tuning-data

收藏
Hugging Face2026-06-27 更新2026-07-22 收录
官方服务:

资源简介:

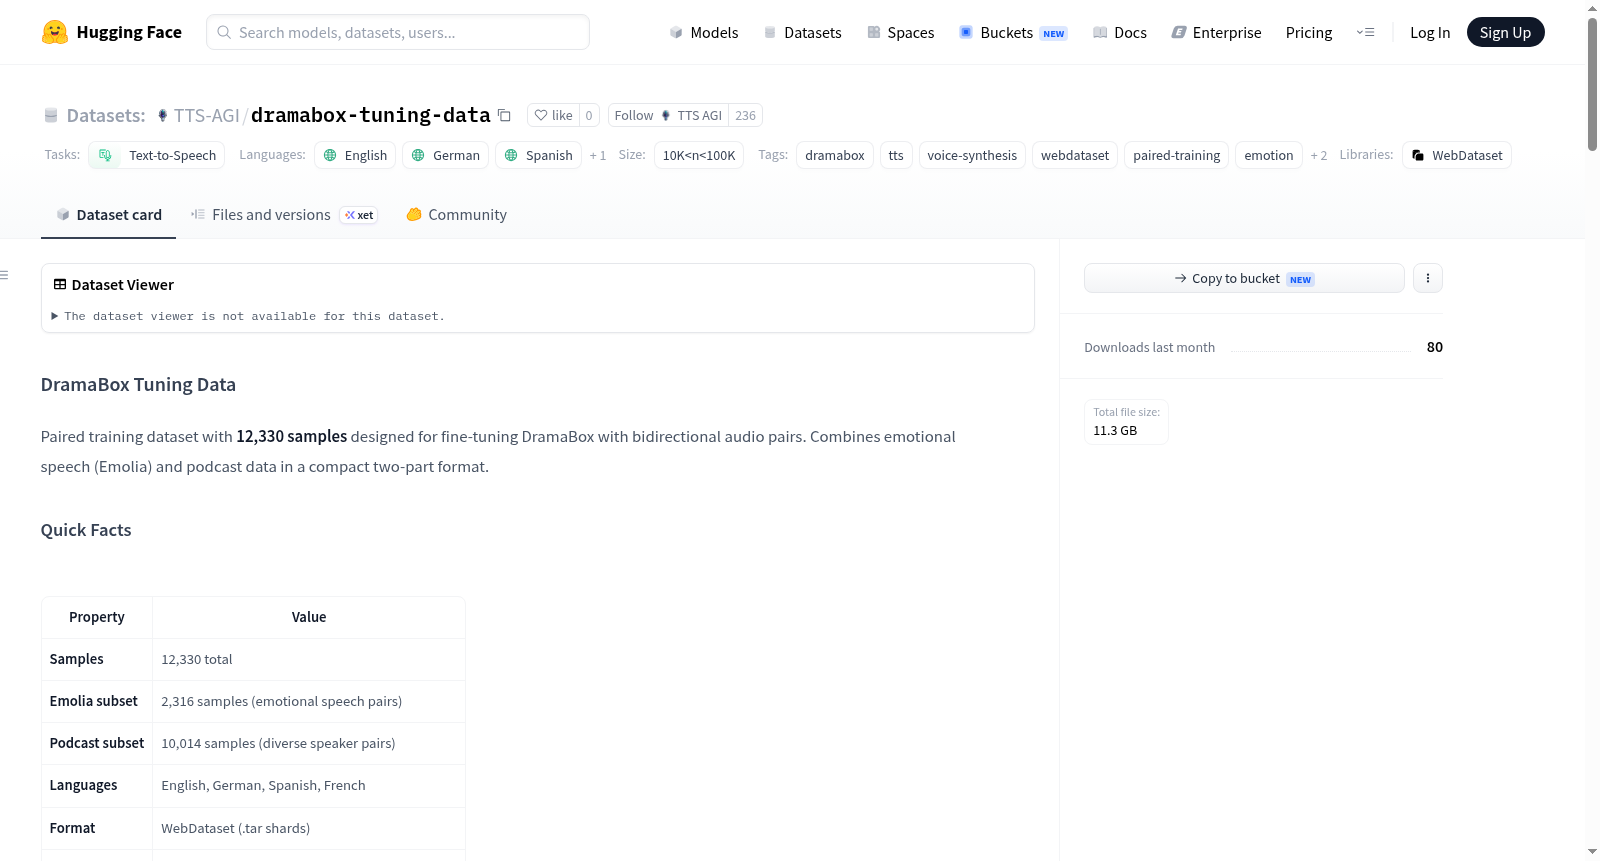
DramaBox Tuning Data是一个用于微调DramaBox的配对训练数据集,包含12,330个样本,结合了情感语音(Emolia)和播客数据,采用紧凑的两部分格式。数据集支持英语、德语、西班牙语和法语,使用WebDataset格式(.tar分片),包含125个分片。每个样本包括元数据(.json文件)、张量数据(.pth文件)以及目标音频和参考音频(.mp3文件)。张量数据包含潜在表示(latent_part1和latent_part2)、条件嵌入(cond_part1_embeds和cond_part2_embeds)以及说话人嵌入(wavlm_speaker_emb和orange_speaker_emb)。数据集采用双向配对设计,每个音频对存在正向和反向两个方向,以增加训练数据,总共有24,660个训练对。提示生成使用基于LLM的方法(如Gemma-4-E4B和Gemini 3.5 Flash),并通过Gemma-3-12B-IT模型重新编码为条件嵌入。数据集与其他标准DramaBox数据集不同,使用未填充的条件嵌入、单.pth文件以及两部分结构,适用于配对/连续训练。

DramaBox Tuning Data is a paired training dataset for fine-tuning DramaBox, containing 12,330 samples that combine emotional speech (Emolia) and podcast data, and adopts a compact two-part format. This dataset supports English, German, Spanish and French, uses the WebDataset format (.tar shards), and consists of 125 shards. Each sample includes metadata (.json file), tensor data (.pth file), as well as target audio and reference audio (.mp3 files). The tensor data contains latent representations (latent_part1 and latent_part2), conditional embeddings (cond_part1_embeds and cond_part2_embeds), and speaker embeddings (wavlm_speaker_emb and orange_speaker_emb). The dataset adopts a bidirectional paired design: each audio pair has both forward and reverse directions to expand the training data, resulting in a total of 24,660 training pairs. Prompt generation uses LLM-based methods (e.g., Gemma-4-E4B and Gemini 3.5 Flash), and the conditional embeddings are re-encoded via the Gemma-3-12B-IT model. Unlike other standard DramaBox datasets, this one uses unpadded conditional embeddings, a single .pth file, and a two-part structure, making it suitable for paired/sequential training.
提供机构:
TTS-AGI
搜集汇总
数据集介绍
TTS-AGI/dramabox-tuning-data 数据集图片
构建方式
该数据集精心构建了12,330个双声道配对样本,旨在微调DramaBox模型。数据融合了Emolia情感语音子集(2,316个样本)与播客子集(10,014个样本),覆盖英语、德语、西班牙语和法语四种语言。每对音频以双向方式存在,即前向与后向,有效将训练数据规模翻倍至24,660对。Emolia子集从同一说话者的语音簇中提取,辅以BUD-E Whisper和情感标注;播客子集则从播客语料库中精选,其中最佳25个样本由Gemini 3.5 Flash API基于实际音频生成描述性提示。所有原始提示文本最终通过Gemma-3-12B-IT模型以4位量化编码为一致的[N, 2048]浮点条件张量,确保格式统一。
特点
该数据集颠覆了传统DramaBox数据集的固定尺寸与填充掩码设计,采用紧凑的单一.pth文件存储所有张量,实现了结构上的革新。其核心特色在于无填充的条件嵌入表示,每个样本仅包含一个精简提示,摒弃了人口统计学描述,转而专注于语音特性与情感。数据集中的嵌入张量涵盖潜在编码、文本条件、说话者身份及音色特征,以bfloat16和float32混合精度存储,兼顾效率与精度。双向配对机制使得模型能够自适应任意参考-目标关系,显著提升了训练的泛化能力。
使用方法
使用该数据集时,推荐采用WebDataset框架进行高效流式加载。首先通过decode_tuning函数解析每个.tar分片中的JSON元数据、.pth张量文件及MP3音频。脚本示例展示了如何轻松访问latent_part1作为参考上下文、latent_part2作为目标生成对象,以及wavlm_speaker_emb和orange_speaker_emb等说话者嵌入。训练配置囊括所有12,330个前向对与等量的后向对,总计24,660个训练实例。开发者可直接利用这些无填充的嵌入进行条件生成,或结合提供的音频文件实现端到端的语音合成微调。
背景与挑战
背景概述
DramaBox Tuning Data是一个专为语音合成模型微调而设计的配对训练数据集,于2026年由TTS-AGI团队创建,包含12,330个样本,涵盖英语、德语、西班牙语和法语四种语言。该数据集的核心研究问题在于如何通过双向音频配对训练(即每个样本包含正向和反向两种方向)来提升语音合成的表现力与自然度,特别是在情感表达和说话人多样性方面。其构建融合了Emolia情感语音子集(2,316个样本)和播客子集(10,014个样本),并采用Gemma-4-E4B和Gemini 3.5 Flash等先进语言模型生成提示文本,再经Gemma-3-12B-IT编码为条件嵌入,确保了文本与音频之间的精细对齐。该数据集对文本到语音(TTS)领域具有重要影响力,为情感化、多说话人、多语言语音合成模型的训练提供了高质量、结构紧凑的基准资源。
当前挑战
该数据集面临的挑战首先体现在领域问题层面:传统语音合成在生成具有丰富情感和自然韵律的语音时,常受限于单一参考音频的局限性,难以覆盖多样化的说话人风格与情感状态。DramaBox Tuning Data通过双向配对训练设计,试图解决模型在跨场景语音生成中的泛化能力不足问题,但仍需应对情感标注的主观性与语言特异性带来的复杂判别困难。在构建过程中,主要挑战包括:1)数据来源的异构性——Emolia情感语音与播客数据在录制条件、噪声背景、说话人分布上差异显著,需设计统一的格式与预处理流程;2)提示文本生成的一致性——使用不同大语言模型(如Gemma-4-E4B本地推理与Gemini API)生成提示时,需确保输出格式的规范性与质量的可控性,避免因量化误差或模型差异引入噪声;3)配对结构的工程复杂性——每个音频样本需生成正向与反向两种配对方式,且所有嵌入(潜在表示、条件嵌入、说话人嵌入)需整合为单一.pth文件,这对数据管道的内存管理与错误处理提出了更高要求。
常用场景
经典使用场景
在语音合成与情感计算交叉领域,DramaBox Tuning Data 被设计为一种双向配对的数据微调资源,经典使用场景聚焦于基于参考音频的条件生成与情感语音延续任务。研究人员通过其紧凑的双部件 latent 结构(latent_part1 与 latent_part2),利用预训练模型进行说话人特征迁移与语音风格模仿,特别适用于需要同时捕捉音色、韵律及情感维度的情感语音合成场景。该数据集囊括了 Emolia 情感语音子集与播客多说话人子集,支持英文、德文、西班牙文及法文等多种语言,为跨语言的情感语音克隆与零样本语音风格迁移提供了高质量的训练素材。
解决学术问题
该数据集有效解决了情感语音合成领域中训练数据稀缺与配对质量不均衡的学术难题。通过引入双向配对策略(前向与后向样本对),将有效训练样本数从 12,330 对倍增为 24,660 组,显著提高了模型对任意参考-目标关系的泛化能力。同时,其采用大型语言模型(如 Gemma-4-E4B 与 Gemini 3.5 Flash)结合音频内容自动生成富含情感标签与语音描述的高质量文本提示,克服了传统模板生成方式刻板、缺乏情感细腻度的问题,推动了情感可迁移语音合成技术的前沿发展。其影响在于为多说话人、多语言、多情感条件下的可控语音生成提供了标准化、可复现的数据基础。
衍生相关工作
围绕着该数据集的特点,学界与工业界衍生出多项具有代表性的经典工作。例如,基于其双向配对机制发展的“任意方向语音变换”(Any-direction Voice Conversion)方法,打破了传统语音转换仅支持源到目标单向映射的限制。另一个经典方向是利用多模态条件嵌入(包括 WavLM 说话人嵌入与 Orange 音色嵌入)构建说话人解耦与情感解耦的统一生成框架,实现了情感风格与身份特征的灵活独立控制。此外,受其 LLM 驱动提示生成流水线的启发,研究者提出了“语义感知多模态线索对齐”(Semantic-aware Multimodal Cue Alignment)策略,成为多任务情感语音合成领域的重要研究范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

