遇见数据集

davidgaofc/MedQuad_split

收藏
Hugging Face2023-11-22 更新2024-03-04 收录
官方服务:

资源简介:

--- license: mit dataset_info: features: - name: qtype dtype: string - name: Question dtype: string - name: Answer dtype: string splits: - name: SFT_train1 num_bytes: 7902949.746571586 num_examples: 5742 - name: SFT_train2 num_bytes: 7902949.746571586 num_examples: 5742 - name: test num_bytes: 2257199.1613335772 num_examples: 1640 - name: RL num_bytes: 2257199.1613335772 num_examples: 1640 - name: RM_oos num_bytes: 1128599.5806667886 num_examples: 820 - name: Shadow_oos num_bytes: 1128599.5806667886 num_examples: 820 download_size: 10355013 dataset_size: 22577496.9771439 configs: - config_name: default data_files: - split: SFT_train1 path: data/SFT_train1-* - split: SFT_train2 path: data/SFT_train2-* - split: test path: data/test-* - split: RL path: data/RL-* - split: RM_oos path: data/RM_oos-* - split: Shadow_oos path: data/Shadow_oos-* --- A Question-Entailment Approach to Question Answering". Asma Ben Abacha and Dina Demner-Fushman. BMC Bioinformatics, 2019.

许可证:MIT 数据集信息: 数据集特征: - 特征字段名:qtype,数据类型:字符串 - 特征字段名:Question,数据类型:字符串 - 特征字段名:Answer,数据类型:字符串 数据拆分: - 名称:SFT_train1,字节数:7902949.746571586,样本数:5742 - 名称:SFT_train2,字节数:7902949.746571586,样本数:5742 - 名称:test,字节数:2257199.1613335772,样本数:1640 - 名称:RL,字节数:2257199.1613335772,样本数:1640 - 名称:RM_oos,字节数:1128599.5806667886,样本数:820 - 名称:Shadow_oos,字节数:1128599.5806667886,样本数:820 下载大小:10355013 数据集总大小:22577496.9771439 配置项: - 配置名称:default 数据文件: - 拆分:SFT_train1,路径:data/SFT_train1-* - 拆分:SFT_train2,路径:data/SFT_train2-* - 拆分:test,路径:data/test-* - 拆分:RL,路径:data/RL-* - 拆分:RM_oos,路径:data/RM_oos-* - 拆分:Shadow_oos,路径:data/Shadow_oos-* 文献引用:《面向问答的问题蕴含方法》(A Question-Entailment Approach to Question Answering),作者阿斯玛·本·阿巴查(Asma Ben Abacha)与迪娜·德姆纳-富什曼(Dina Demner-Fushman),发表于《BMC生物信息学》(BMC Bioinformatics),2019年。

提供机构:
davidgaofc
原始信息汇总

数据集概述

特征信息

  • qtype: 字符串类型
  • Question: 字符串类型
  • Answer: 字符串类型

数据分割

  • SFT_train1:
    • 字节数: 7902949.746571586
    • 样本数: 5742
  • SFT_train2:
    • 字节数: 7902949.746571586
    • 样本数: 5742
  • test:
    • 字节数: 2257199.1613335772
    • 样本数: 1640
  • RL:
    • 字节数: 2257199.1613335772
    • 样本数: 1640
  • RM_oos:
    • 字节数: 1128599.5806667886
    • 样本数: 820
  • Shadow_oos:
    • 字节数: 1128599.5806667886
    • 样本数: 820

数据大小

  • 下载大小: 10355013 字节
  • 数据集大小: 22577496.9771439 字节

配置信息

  • default 配置:
    • SFT_train1: data/SFT_train1-*
    • SFT_train2: data/SFT_train2-*
    • test: data/test-*
    • RL: data/RL-*
    • RM_oos: data/RM_oos-*
    • Shadow_oos: data/Shadow_oos-*
搜集汇总
数据集介绍
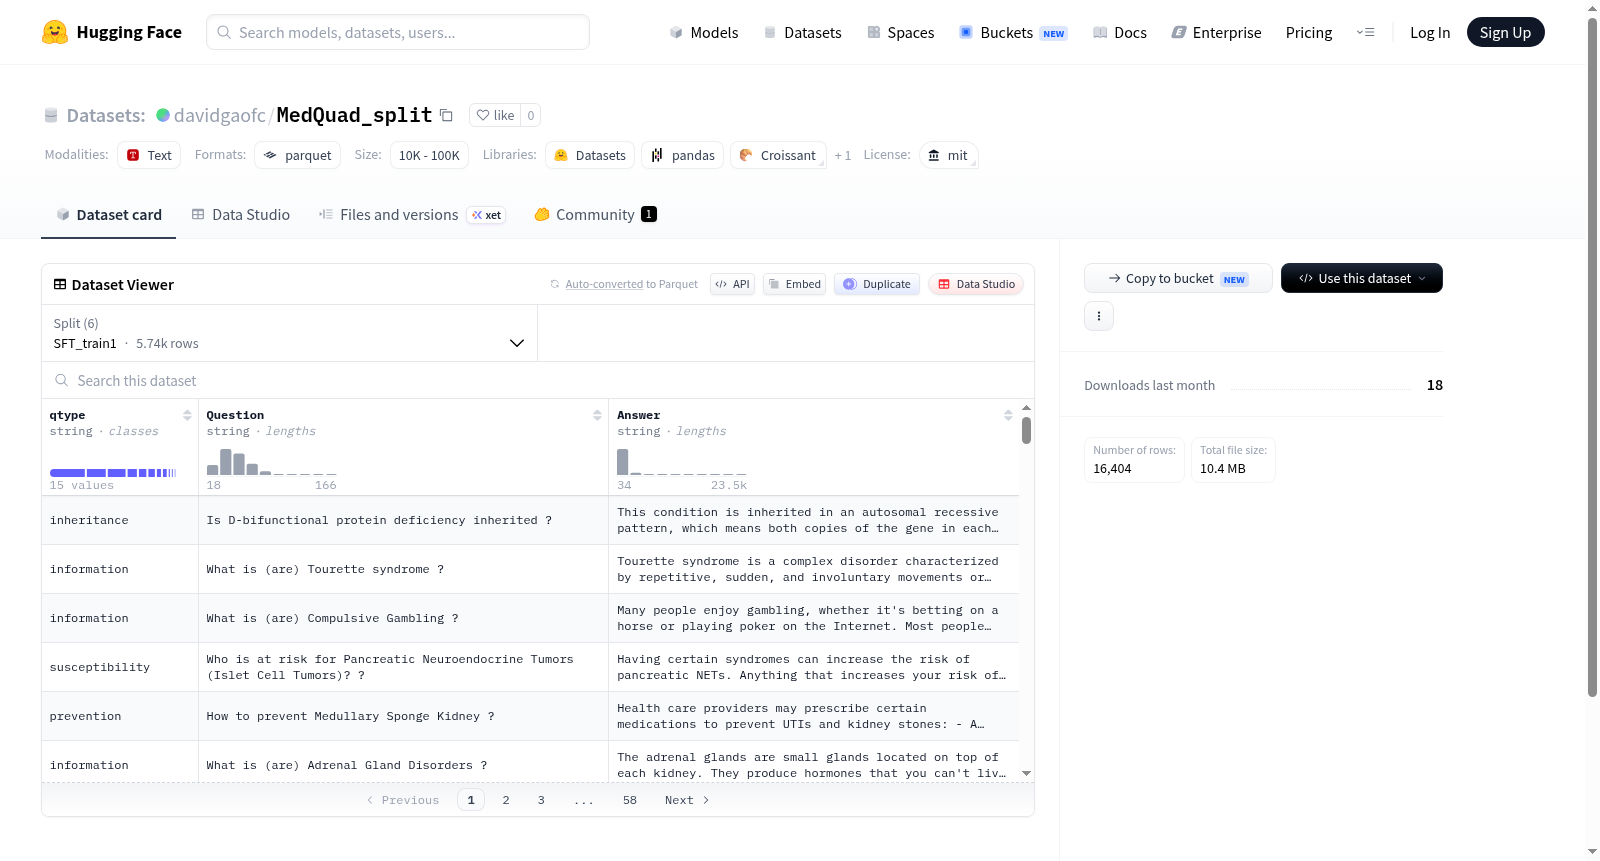
davidgaofc/MedQuad_split 数据集图片
构建方式
MedQuad_split数据集源自一项关于问答系统的创新研究,基于问题蕴含(Question-Entailment)方法构建,旨在提升医学领域的问答能力。该数据集从原始MedQuad资源中精心划分,形成了六个子集:SFT_train1和SFT_train2用于监督微调训练,test用于性能评估,RL面向强化学习任务,RM_oos与Shadow_oos则专注于分布外场景下的奖励模型训练与影子评估。每个样本包含问题类型(qtype)、问题文本(Question)及其对应答案(Answer),结构简洁而规范,为医学问答模型的训练与评测提供了标准化基础。
特点
该数据集的核心特点在于其多层次的分割设计,能够覆盖模型训练的不同阶段与目标。SFT_train1与SFT_train2各包含5742个样本,保证了监督学习的充足数据;test与RL子集各含1640个样本,分别支持模型性能验证与强化学习优化;RM_oos和Shadow_oos各含820个样本,针对分布外泛化能力进行专门测试。这种精细化的划分不仅提升了数据利用效率,还使得模型在医学问答任务中能够兼顾准确性、鲁棒性与适应性,展现出高度的实用价值与研究潜力。
使用方法
使用MedQuad_split数据集时,可通过HuggingFace的datasets库便捷加载。用户需指定config_name为'default',并根据任务需求选择相应子集,如'data/SFT_train1-*'用于监督微调,'data/RL-*'用于强化学习训练。数据默认以Parquet格式存储,支持高效读取。建议在加载后,将qtype、Question和Answer字段分别作为特征与标签,适配常见的序列到序列或分类模型。该数据集特别适用于医学问答、对话系统及知识检索等场景,开发者可依据具体任务灵活调用各子集,实现模型的分阶段训练与评估。
背景与挑战
背景概述
在自然语言处理与医学信息检索的交叉领域,如何从海量临床文本中精准提取答案始终是核心难题。MedQuad数据集由Asma Ben Abacha与Dina Demner-Fushman于2019年提出,隶属于美国国立医学图书馆,旨在通过问题蕴含方法推动医学问答系统的进步。该数据集以结构化三元组(问题类型、问题、答案)为框架,覆盖多类医学查询场景,其构建不仅服务于监督微调,还通过强化学习与离群检测等子集设计,为模型鲁棒性评估提供基准。作为生物医学问答领域的标志性资源,MedQuad为后续研究如BioBERT与PubMedBERT的涌现奠定了数据基础,显著提升了临床决策支持系统的可信度。
当前挑战
MedQuad数据集面临的核心挑战在于医学知识的动态演化与问答泛化能力的平衡。一方面,医学指南与药物信息快速更新,导致固定时间戳的数据集可能无法反映最新诊疗标准,需持续维护以保持时效性。另一方面,数据构建过程中需解决医学文本的歧义性与隐含逻辑——例如症状与疾病的非唯一对应关系,这要求标注团队具备专业临床知识,并设计严谨的问题蕴含规则。此外,多子集划分(如SFT_train与Shadow_oos)虽增强了模型评估的细致度,但也增加了跨域迁移时的噪声干扰,如何在高精度检索与低误判率之间取得最优解,仍是当前研究的瓶颈。
常用场景
经典使用场景
MedQuad_split数据集,源自生物医学问答领域的经典研究,其核心设计围绕一种基于问题蕴含(Question-Entailment)的问答范式展开。在自然语言处理与医学信息检索的交汇处,该数据集最经典的使用场景是训练和评估面向医疗领域的问答系统。研究者通过利用其精心划分的SFT、RL、RM等子集,能够构建从监督微调到强化学习对齐的完整流水线,从而提升模型在复杂医学问题上的应答准确性与安全性。这种分治策略不仅模拟了真实临床环境中医生对患者问题的多轮推理过程,也为后续的指令微调与偏好优化提供了标准化的基准测试平台。
衍生相关工作
MedQuad_split衍生了一系列具有影响力的相关工作,其中最为核心的是Asma Ben Abacha和Dina Demner-Fushman在BMC Bioinformatics上发表的奠基性论文,该研究首次将问题蕴含框架系统性地应用于医学问答,并开源了原始数据集。后续研究在此基础上,拓展了多模态医学问答(如结合影像与文本)、少样本学习下的医疗对话生成,以及基于强化学习的对齐优化方法。此外,该数据集的划分结构也启发了诸如MedQA、PubMedQA等基准的构建,形成了生物医学自然语言处理领域一套完整的评估生态,持续推动着从信息检索到知识推理的学术演进。
数据集最近研究
最新研究方向
MedQuad数据集的最新研究方向聚焦于利用问题蕴含(Question-Entailment)范式提升医学领域的问答系统性能。该数据集源自Asma Ben Abacha与Dina Demner-Fushman在BMC Bioinformatics上提出的开创性方法,将医学问答任务转化为问题与答案之间的逻辑蕴含判定,从而增强模型对复杂临床信息的理解与推理能力。当前前沿研究围绕大语言模型在医疗场景下的微调与强化学习展开,MedQuad_split通过划分监督微调(SFT)、强化学习(RL)及分布外评估(OOS)等子集,为训练鲁棒且安全的医学对话系统提供了基准。这一方向与医疗AI的可解释性、患者隐私保护等热点紧密关联,其意义在于推动AI辅助诊疗从检索式匹配迈向深层语义理解,为临床决策支持系统的落地奠定数据基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务