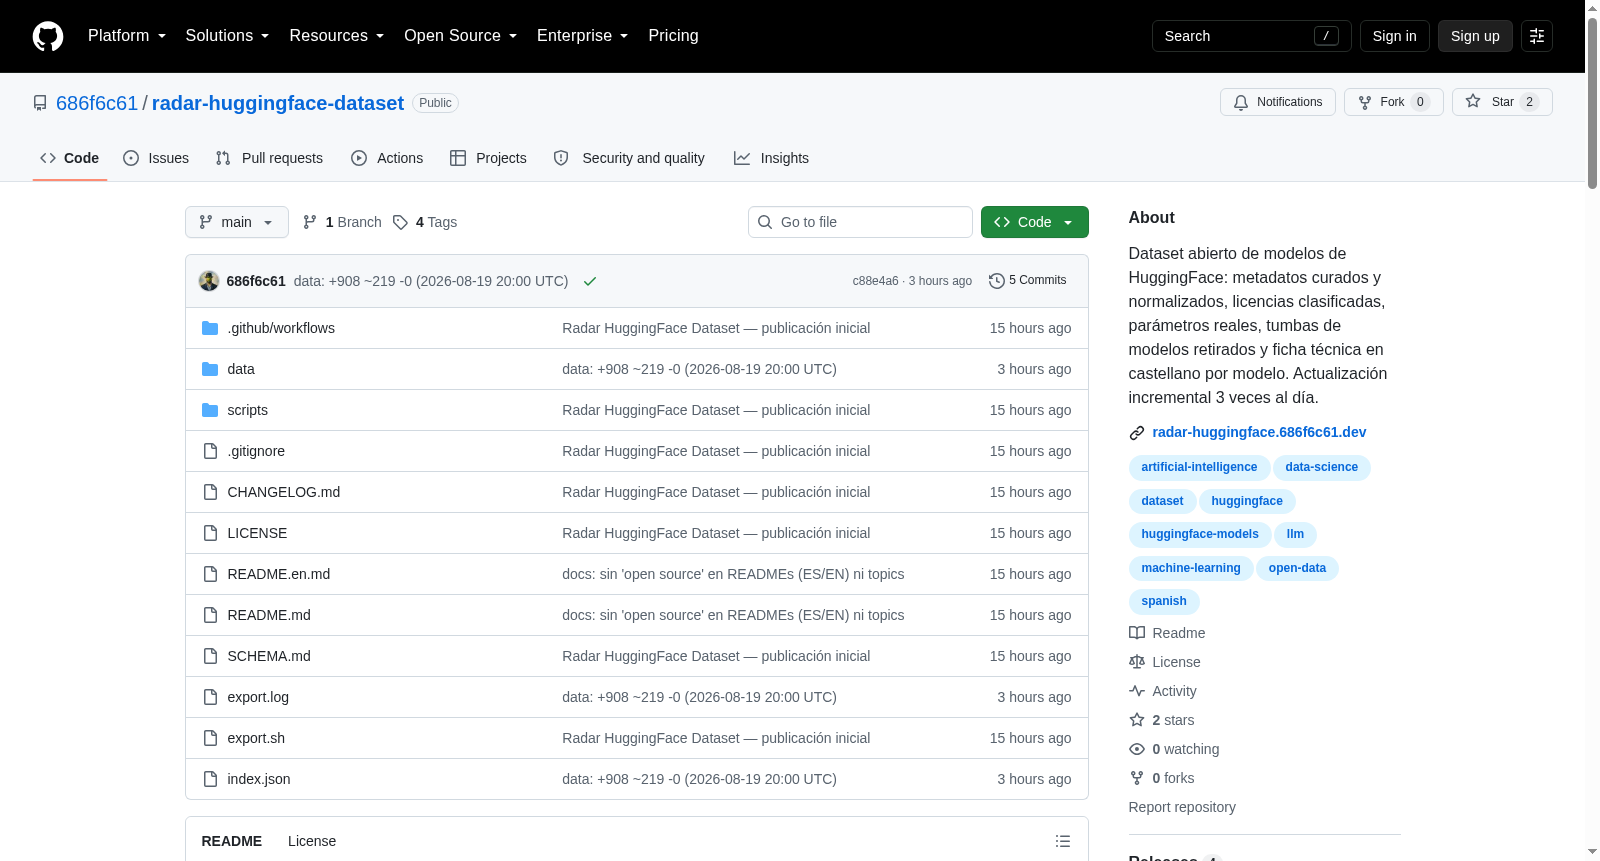
Radar HuggingFace Dataset
收藏资源简介:
Radar HuggingFace Dataset 是一个开放、动态且版本化的HuggingFace生态系统数据集。每天有数千个模型在hub上发布,其API仅能回答模型当前的状态;而该数据集每天三次提供经过整理和丰富的内容快照,涵盖所有值得关注的信息:发布了什么模型、谁发布的、许可证类型、真实热度、分发格式、实际参数数量,以及哪些模型消失而无人宣布。
The Radar HuggingFace Dataset is an open, dynamic, and versioned dataset within the Hugging Face ecosystem. Thousands of models are published on the Hugging Face Hub every day, and its API can only return the current status of models; this dataset provides curated and enriched content snapshots three times per day, covering all noteworthy information: what models have been released, who released them, their license types, real-world popularity, distribution formats, actual parameter counts, and which models have vanished without prior announcement.
Radar HuggingFace Dataset 数据集详情
数据集概述
Radar HuggingFace Dataset 是一个开放、实时更新且带版本管理的 HuggingFace 生态系统数据集,由 HF//RADAR 雷达系统生成,每天三次(06:00、14:00、22:00 西班牙时间)捕获 HuggingFace Hub 上值得关注的模型快照,并为每个模型生成西班牙语技术档案。该数据集并非 Hub 的简单镜像,而是经过筛选的策展层——仅收录具有已验证开放许可证且包含最低限度有用信息的模型。
核心目的
该数据集旨在回答 HuggingFace API 无法回答的历史与趋势性问题:
- 发布内容与发布者:哪些组织主导 Hub,使用何种许可证、模型规模和格式(GGUF、MLX、safetensors 等)
- 真实热度:按时间窗口统计下载量与点赞数,而非仅看有利于旧模型的累计值
- 模型消亡记录:标记已从 Hub 移除的模型(
removed、removed_at字段),记录生态系统的"墓碑" - 生态演化追踪:每 12 小时更新并编号版本,形成无法事后从 API 重建的 OSS 生态系统时间序列
数据结构
数据按作者(组织或用户)分文件夹存储,每个模型包含两个文件:
data/ ├── qwen/ │ ├── qwen3.8-27b.json # 结构化元数据(遵循 SCHEMA.md v1) │ ├── qwen3.8-27b.md # 西班牙语技术档案 │ └── ... ├── meta-models/ │ ├── muse-glimmer-30b.json │ └── muse-glimmer-30b.md └── ...
- 文件夹名为小写作者名,文件名为模型名,二者组合形成唯一
slug(作者-模型名) - 文件名冲突时(如大小写不同的重复上传),较新的模型添加
-2、-3后缀 - 每个
.json文件遵循 SCHEMA.md 版本 1,包含:许可证分类、真实参数数量、格式、基准测试、关键绩效指标、访问与移除标志 .md文件是由雷达根据模型卡片和网络来源生成的西班牙语技术档案- 仓库根目录的
index.json是轻量级清单,包含所有条目的关键字段,便于无需下载完整目录树即可浏览
更新机制
由雷达服务器上的 worker 每天三次执行更新流程:数据库导出 → 增量写入(仅重写变化内容)→ 结构化提交 → 推送。CI 验证每次推送,发布更新的批量数据并创建对应编号的 release。
- 同一文件更新:模型 KPIs 变化时直接重写原文件,不新建文件
- 历史保留:昨日数据保存在 git 提交历史中,以及编号的 release 快照(v1.0.0、v2.0.0 等)里
- 已移除模型:不会删除文件,而是标记
removed: true并注明移除日期;仅当模型从雷达数据库中删除时才移除文件
版本管理
每次含新数据的更新发布一个 release,版本号编码了时间段:
| 时段 | 版本递增 | 示例 |
|---|---|---|
| 06:00 早晨 | major | v3.0.0 |
| 14:00 下午 | minor | v3.1.0 |
| 22:00 夜晚 | patch | v3.1.1 |
例如 v14.2.1 表示数据集启动以来第 14 天的夜晚导出。Release 不可变,可固定版本以复现分析。格式变更会通过更新 schema 和 CHANGELOG.md 另行公告。
latestrelease(浮动):始终指向最新导出,其资源 URL 永久不变,适合持续消费- 结构化提交消息(如
data: +12 ~140 -1):标明每次更新的新增、修改和删除数量
使用示例
bash
获取单个模型元数据
curl -s https://raw.githubusercontent.com/686f6c61/radar-huggingface-dataset/main/data/qwen/qwen3.8-27b.json
python
使用 pandas 读取完整数据集(含档案)
import pandas as pd url = "https://github.com/686f6c61/radar-huggingface-dataset/releases/download/latest/models.jsonl.gz" df = pd.read_json(url, lines=True)
sql -- 使用 DuckDB 直接查询批量数据 SELECT author, COUNT(*) AS modelos FROM read_json(https://github.com/686f6c61/radar-huggingface-dataset/releases/download/latest/models.jsonl.gz, format=newline_delimited) GROUP BY author ORDER BY modelos DESC LIMIT 10;
许可证与声明
- 许可证:CC-BY-4.0
- 数据来源:HuggingFace Hub 元数据
- 技术档案:由 HF//RADAR 生成
- 使用要求:使用数据集时需链接到仓库或雷达站点
- 免责声明:数据按"原样"提供;技术档案由 LLM 撰写,可能包含错误,在生产环境使用模型前请对照原始模型卡片核实