findcard12138/Realtime-SFT
收藏资源简介:
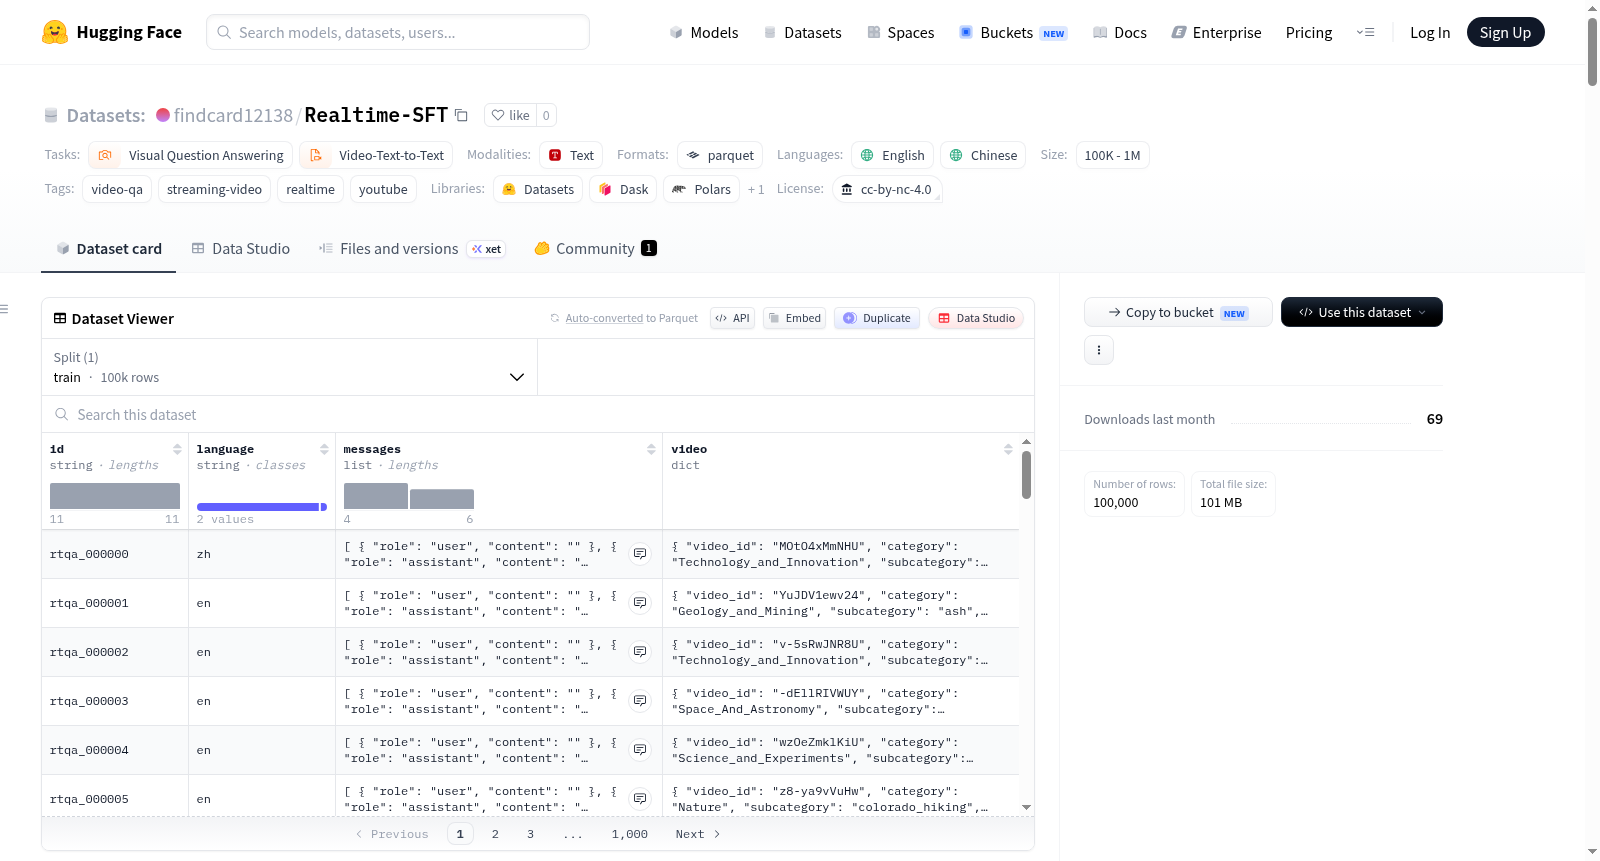
Realtime-SFT是一个包含100,000个样本的流式风格视频问答数据集,基于YouTube短视频构建。每个样本包含多模态对话和帧时间戳元数据,这些数据将助手文本中的每个`<|video|>`标记与一个视频帧时间戳对齐。数据集不重新分发视频文件,仅提供注释、YouTube视频ID和时间戳元数据;用户需根据YouTube服务条款和原始上传者的许可自行获取视频。数据集来源为YouTube平台,包含24,817个独特的YouTube视频,视频时长在4分钟以内,帧采样率为每秒1帧。语言分布为英语(93,815个样本)和中文(6,185个样本),涵盖27个类别,注释数据采用CC-BY-NC-4.0许可。数据集结构包括一个训练分割,存储为Parquet分片,每个行包含id、language、messages和video字段。特殊标记如`<|video|>`用于标记视频帧位置,`<|silence|>`表示助手保持静默的时间步,`<|...|>`用于流式对话中的早期截断。构建流程通过语义构建和时间布局对齐两个阶段,将原始视频流转换为时间对齐的多轮对话。加载方法支持使用Hugging Face datasets库或直接读取Parquet文件。视频访问需用户基于提供的video_id和frame_timestamps自行从YouTube获取并对齐帧。数据集旨在用于实时流式视频理解的学术研究,不应用于商业部署、人脸识别、监控或其他可能侵犯隐私或平台条款的应用。局限性包括YouTube视频可能因删除、隐私变更、区域限制或账户更改而不可用,视频文件未包含,且未进行个人身份信息、不当内容或敏感内容的审核。
Realtime-SFT is a 100K-sample streaming-style video question answering dataset constructed from short YouTube videos. Each sample contains a multimodal conversation and frame timestamp metadata that aligns every `<|video|>` token in the assistant text with one video frame timestamp. This repository does not redistribute video files. It only provides annotations, YouTube video IDs, and timestamp metadata. Users are responsible for obtaining videos according to YouTube Terms of Service and the original uploaders licenses. The dataset source is YouTube, with 24,817 unique YouTube videos, duration within 4 minutes, frame sampling at 1 fps. Languages are English (93,815 samples) and Chinese (6,185 samples), covering 27 categories, and the license for annotations is CC-BY-NC-4.0. The dataset structure has one train split stored as Parquet shards, each row with id, language, messages, and video fields. Special tokens include `<|video|>` for video frame positions, `<|silence|>` for silent timesteps, and `<|...|>` for early cut-offs in streaming conversations. The construction pipeline involves semantic construction and temporal layout alignment phases to convert raw video streams into time-aligned multi-turn dialogues. Loading methods support using Hugging Face datasets library or direct Parquet reading. Video access requires users to independently obtain videos from YouTube using provided video_id and frame_timestamps for alignment. The dataset is intended for academic research on real-time and streaming video understanding, and should not be used for commercial deployment, face recognition, surveillance, or other applications that may violate privacy or platform terms. Limitations include potential unavailability of YouTube videos due to deletion, privacy changes, regional restrictions, or account changes; video files are not included, and PII, NSFW, and sensitive-content audits have not been performed.