
Isamu136/wikiart_indexed
收藏官方服务:
资源简介:
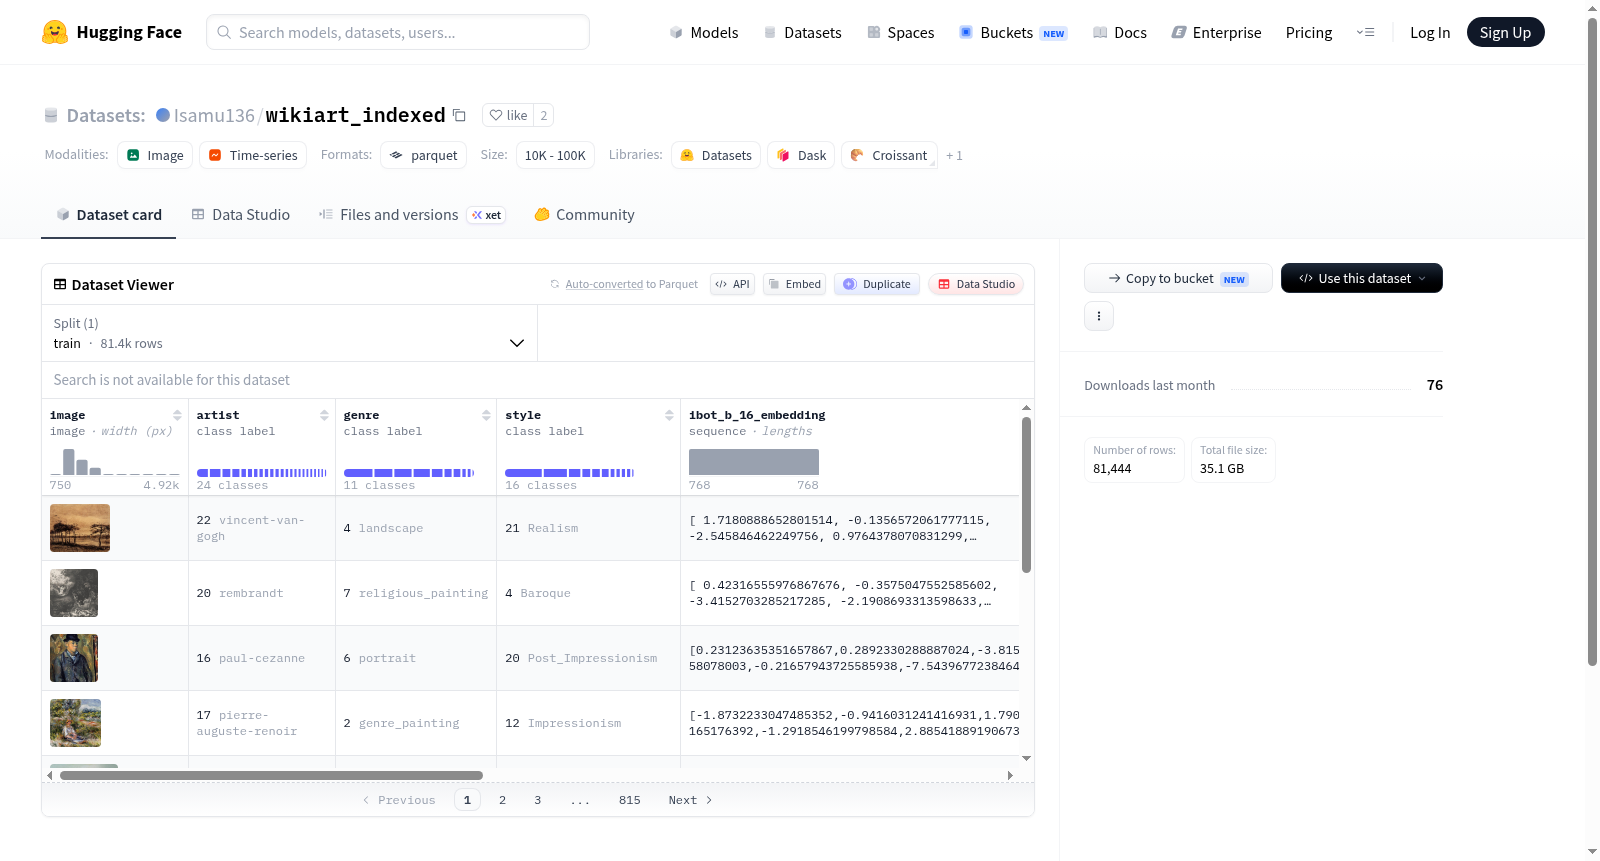
该数据集包含艺术作品的图像及其相关信息,如艺术家、流派、风格以及一些嵌入向量。艺术家、流派和风格都是分类标签,分别对应不同的艺术家、绘画流派和艺术风格。数据集分为训练集,包含81444个样本,总大小为34843473471.5字节。
This dataset contains images of artworks and their associated information, including artist, genre, style, and several embedding vectors. Artist, genre, and style are all categorical labels, which respectively correspond to different artists, painting genres, and art styles. The dataset is split into a training set, which includes 81,444 samples with a total size of 34,843,473,471.5 bytes.
提供机构:
Isamu136原始信息汇总
数据集概述
数据集名称
- 名称: wikiart_indexed
数据集特征
- 特征1: image
- 数据类型: image
- 特征2: artist
- 数据类型: class_label
- 类别名称: 包含121个艺术家名称,如0: Unknown Artist, 1: boris-kustodiev, ...
- 特征3: genre
- 数据类型: class_label
- 类别名称: 包含11个艺术流派,如0: abstract_painting, 1: cityscape, ...
- 特征4: style
- 数据类型: class_label
- 类别名称: 包含27个艺术风格,如0: Abstract_Expressionism, 1: Action_painting, ...
- 特征5: ibot_b_16_embedding
- 数据类型: float32
- 特征6: moco_vitb_imagenet_embeddings_without_last_layer
- 数据类型: float32
- 特征7: clip_vision_l14
- 数据类型: float32
- 特征8: clip_l14
- 数据类型: float32
数据集分割
- 分割名称: train
- 数据大小: 34843473471.5 bytes
- 示例数量: 81444
数据集大小
- 下载大小: 35082781676 bytes
- 数据集大小: 34843473471.5 bytes
搜集汇总
数据集介绍
构建方式
WikiArt数据集作为艺术领域的重要资源,汇聚了跨越多个世纪与流派的杰出画作。Isamu136/wikiart_indexed数据集在此基础上进行了深度加工,将原始图像与艺术家、流派、风格三类精细标注相结合,构建起一个结构化的艺术知识库。数据集包含81,444个训练样本,每个样本均提供高分辨率图像,并通过预定义的类别标签体系对艺术家(如克劳德·莫奈、巴勃罗·毕加索等128位)、流派(如肖像画、风景画等10类)及风格(如印象派、立体主义等27种)进行系统化编码。此外,数据集中还嵌入了四种预计算的特征向量,包括iBOT-B/16、MoCo-vitb、CLIP视觉与CLIP文本嵌入,为多模态分析奠定基础。
使用方法
使用该数据集时,可通过HuggingFace Datasets库直接加载,利用'image'字段获取图像数据,并借助'artist'、'genre'与'style'字段进行多标签分类任务。预计算的特征向量如'clip_vision_l14'可直接用于零样本分类或跨模态检索,无需额外提取。研究者可基于这些特征构建轻量级分类器,或将其作为对比学习、自监督预训练的评估基准。数据集的分割设计为单训练集,适合用于特征学习与表示评估,亦可按需划分验证子集进行模型调优。
背景与挑战
背景概述
WikiArt数据集由Isamu136于近年构建并发布,旨在为计算机视觉与艺术史交叉领域提供大规模、多标注的绘画图像资源。该数据集汇集了从文艺复兴到现代主义的128位艺术家、10种流派及27种风格的作品,共计81,444幅图像,并附带预提取的视觉嵌入特征(如CLIP、MoCo等),为艺术风格迁移、艺术家识别及流派分类等任务奠定了坚实基础。其核心研究问题聚焦于如何利用深度学习模型捕捉绘画作品中的艺术特征与语义信息,推动机器对艺术创作的理解与生成。该数据集已成为艺术智能分析领域的重要基准,促进了跨模态学习与数字人文研究的发展。
当前挑战
该数据集面临的挑战首先体现在艺术分类的模糊性上:同一幅画作可能跨越多种风格或流派,而标注的单一性难以反映艺术品的复杂属性,导致模型训练时的标签噪声与歧义。其次,数据构建过程中存在显著困难,包括从不同来源收集图像时面临的分辨率差异、色彩失真及版权限制,以及艺术家、流派和风格标注依赖专家知识所带来的主观偏差。此外,预训练嵌入特征虽丰富了数据维度,但不同特征空间的对齐与融合仍是一个开放问题,限制了模型在多任务学习中的泛化能力。
常用场景
经典使用场景
WikiArt Indexed数据集汇聚了从文艺复兴到当代的逾八万幅绘画作品,涵盖128位艺术家、11种题材与27种风格流派,为计算机视觉与艺术史交叉领域的研究提供了丰饶的数字化沃土。该数据集最经典的使用场景在于构建多模态艺术理解模型,研究者可借助其丰富的图像与标签信息,训练能够同时识别艺术家身份、绘画题材与艺术风格的深度神经网络。通过对画家笔触、色彩布局与构图特征的深度学习,模型得以捕捉不同艺术流派间的微妙差异,进而实现跨风格的艺术品自动分类与检索。
解决学术问题
该数据集有效破解了艺术史研究中因样本稀缺而难以开展大规模量化分析的困境,为探索绘画风格演化规律与艺术家创作轨迹提供了坚实的数据基础。学术研究可借此深入探讨风格迁移中的语义保留问题,即在保留原作内容的前提下实现风格转换的算法优化。同时,数据集内嵌的多种预训练视觉嵌入(如CLIP、iBOT与MoCo特征)为对比学习与表征解耦研究提供了标准化基准,推动了无监督与自监督学习方法在细粒度视觉分类任务上的理论突破。
实际应用
在实际应用层面,该数据集为数字博物馆与在线艺术平台的智能导览系统提供了技术支撑。基于此数据集训练的模型可自动识别用户上传画作的风格与年代,并推荐相似艺术作品,极大丰富观众的审美体验。此外,在艺术教育领域,该数据集赋能了智能创作辅助工具的开发,能够根据用户选择的艺术流派生成风格化图像,降低艺术创作的门槛。文化遗产数字化保护项目中,该数据集也为破损画作的风格复原与年代鉴定提供了参考依据,助力珍贵艺术遗产的传承。
数据集最近研究
最新研究方向
在计算机视觉与艺术史交叉领域,Isamu136/wikiart_indexed数据集因其对西方绘画流派、风格及创作者的多维度标注,成为推动艺术风格迁移、生成模型及多模态理解研究的关键资源。近期前沿方向聚焦于利用其预提取的CLIP、iBOT等深度视觉嵌入,结合对比学习与扩散模型,实现高保真度的艺术风格重构与跨时空艺术对话。该数据集所涵盖的印象派、立体主义等流派,与近年数字人文浪潮中‘算法策展’及‘AI艺术创作伦理’等热点事件紧密相连,其结构化标签助力研究者量化分析艺术演变规律,为文化遗产数字化保护与创造性转化提供了可复现的基准,显著推动了生成式AI在艺术领域从‘模仿’向‘理解’的范式跃迁。
以上内容由遇见数据集搜集并总结生成


