遇见数据集

dreamlake-lerobot-annotated

收藏
Hugging Face2026-08-17 更新2026-08-18 收录
官方服务:

资源简介:

该数据集名为 DreamLake viz template,采用 LeRobot v2.1 格式,包含一段30秒的真实自我中心视频录制(900帧,29.97 fps)。数据内容包括:自我中心视角的RGB图像(分辨率1080×1920,3通道);左右手2D关键点(每手21个关键点,每个点包含x、y坐标和置信度,共3维);以及子任务索引和对应的标签表(用于标注时间轴上的不同阶段)。关键点数据在未检测到手时以NaN填充(而非零,避免与左上角像素混淆)。该数据集适用于机器人模仿学习、手部姿态估计、动作识别等任务,并支持基于时间段的子任务标注。

The dataset named DreamLake viz template is a robotic learning dataset in LeRobot v2.1 format, containing a 30-second real egocentric video recording (900 frames, 29.97 fps). The data includes: egocentric RGB images (resolution 1080×1920, 3 channels); 2D keypoints for left and right hands (21 keypoints per hand, each with x, y coordinates and confidence, 3 dimensions); and subtask indices with a corresponding label table (for annotating different stages along the timeline). Keypoints are filled with NaN when hands are not detected (instead of zero, to avoid confusion with the top-left pixel). This dataset is suitable for tasks such as robot imitation learning, hand pose estimation, action recognition, and supports time-segment-based subtask annotation.

创建时间:
2026-08-14
原始信息汇总

数据集总结

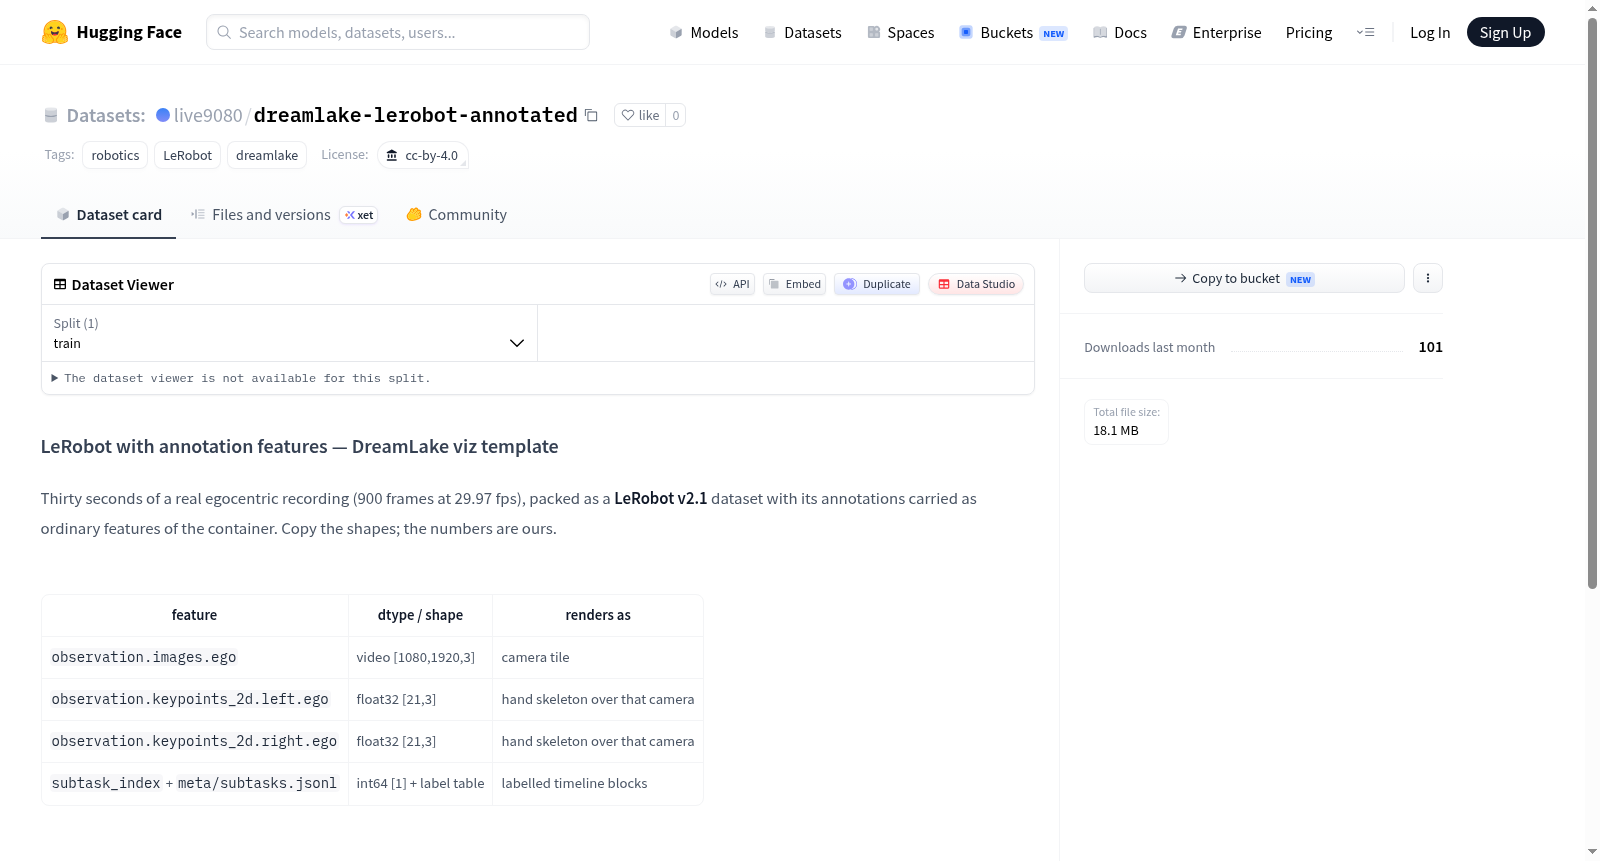
该数据集为一个带有标注特征的机器人学习数据集,遵循 LeRobot v2.1 格式,内容为一段30秒的真实第一人称视角录制视频(共900帧,帧率29.97fps)。

核心内容

特征 数据类型/形状 渲染方式
observation.images.ego 视频 [1080, 1920, 3] 相机画面
observation.keypoints_2d.left.ego float32 [21, 3] 手部骨架叠加于相机画面
observation.keypoints_2d.right.ego float32 [21, 3] 手部骨架叠加于相机画面
subtask_index + meta/subtasks.jsonl int64 [1] + 标签表 带标签的时间轴区块

关键设计细节

  1. 关键点特征命名需与相机名称对应:关键点特征名称必须以对应相机名称结尾,例如 observation.keypoints_2d.left.ego 继承自 observation.images.ego。若命名为 keypoints_2d.ego_left 则匹配失败。

  2. 标注片段结构:采用索引列加标签表的方式,即沿用 LeRobot 中 task_index + meta/tasks.jsonl 的模式,此处降一级使用。

  3. 缺失数据处理:未检测到手部的帧使用 NaN 表示,而非0。因为0代表真实的像素坐标(左上角),使用NaN可避免将虚构原点与实际测量值混淆。

许可信息

  • 许可证:cc-by-4.0
  • 标签:robotics, LeRobot, dreamlake
搜集汇总
数据集介绍
dreamlake-lerobot-annotated 数据集图片
构建方式
该数据集以真实的第一人称视角录制了三十秒的连续视频流,涵盖900帧图像,帧率设定为29.97 fps,并遵循LeRobot v2.1规范进行封装。其构建精妙之处在于,将手部关键点标注作为普通特征嵌入数据容器,而非依赖外部标注文件。图像特征与关键点特征通过命名规则紧密耦合,即关键点特征名未尾必须包含对应的相机名称片段,如`observation.keypoints_2d.left.ego`与`observation.images.ego`相呼应,以此确保像素空间的一致性。同时,采用索引列与标签表相结合的方式描述子任务,沿用了LeRobot自有的`task_index`与`meta/tasks.jsonl`模式,形成层次化的标注结构。
特点
该数据集的核心特色在于其标注与容器融为一体的设计,既保留了LeRobot标准的视频流,又在同一命名空间内嵌入了2D手部关键点(每帧21个关键点,含x、y坐标及可见性),并以NaN而非零值标识未检测到的手部,这一细节凸显了数据采集的严谨性,避免了零值造成的像素混淆。命名规则的强制一致性保障了多相机数据集的扩展性,而标签表的引入则为时间轴上的语义分段提供了结构化基础,使得数据既适用于视觉感知任务,也能服务于行为理解与分析。
使用方法
使用时,用户可直接加载该LeRobot数据集,通过标准API访问`observation.images.ego`获取视频帧,同步提取`observation.keypoints_2d.left/right.ego`获取手部关键点。关键点坐标已映射至图像像素空间,可无缝叠加于对应相机画面,便于可视化或直接作为模型输入。子任务标签通过`subtask_index`和`meta/subtasks.jsonl`文件解读,用户可据此划分时间轴并标注动作类别。该数据集兼容LeRobot的生态系统,可无缝融入机器人学习流程,支持行为克隆、模仿学习等范式,其命名规范亦为扩展至多相机多模态场景提供了模板。
背景与挑战
背景概述
在机器人学习与计算机视觉交叉领域,数据集的构建与标注直接影响模型性能与泛化能力。DreamLake-Lerobot-Annotated 数据集由 LeRobot 社区于近期创建,旨在为具身智能研究提供一种新型的带注释的机器人操作数据格式。该数据集基于真实的第一人称视角录制,包含900帧、共30秒的高清视频,并创新性地将手部关键点、子任务索引及标签表作为标准特征嵌入LeRobot v2.1容器中,从而支持细粒度的动作分析与任务分解。这一设计有效解决了传统数据集标注信息与视觉数据分离、格式不兼容的问题,为后续研究提供了可复用的模板,对推动机器人学习的数据标准化与多模态融合研究具有重要影响。
当前挑战
该数据集的主要挑战体现在三个层面:首先,在领域问题层面,机器人操作数据通常缺乏细粒度的手部姿态与任务阶段标注,而该数据集通过引入关键点与子任务标签,初步解决了这一问题,但仍需验证其在不同相机视角与复杂背景下的鲁棒性。其次,在数据构建过程中,关键点特征的命名必须与对应相机名称严格匹配,否则像素空间对齐失败,这要求构建者遵循严格的命名规范,增加了数据集生成与维护的复杂度。最后,对于未检测到的手部帧,数据集采用NaN而非零值,以区分真实缺失与像素坐标原点,避免误导视觉模型,但这一处理要求下游算法具备处理非数值的能力,增加了模型设计的难度。
常用场景
经典使用场景
在机器人学习与具身智能研究领域,该数据集以其精心的LeRobot v2.1格式封装,成为多模态感知与操控任务建模的基准资源。其核心价值在于同步呈现高分辨率第一人称视角影像(1080×1920,29.97帧每秒)与双手关键点序列(每帧21个三维坐标点),并辅以层次化的任务标注结构。研究者常将其用于开发视觉-运动控制联合模型,训练机器人理解手部细粒度动作与场景上下文之间的语义关联,尤其适用于模仿学习、视觉伺服控制及人机交互场景下的策略泛化研究。数据集的格式规范严格遵循特征命名与像素空间对齐原则,为跨场景、跨主体的算法评估提供了可比性强的测试平台。
衍生相关工作
该数据集的发布催生了一系列围绕LeRobot生态的扩展工作。基于其特征命名与容器结构约定,研究者开发了自动化数据集校验工具,用于检查模态命名一致性与像素空间匹配性,确保新采集数据与现有流程无缝对接。在算法层面,后续工作借鉴其NaN处理策略,提出了缺失关键点条件下的鲁棒估计网络,并利用其分层任务标注设计出多粒度时序动作分割模型。此外,该数据集的视觉模板被广泛引用为可视化基准,催生了面向机器人轨迹的高效渲染库,使科研人员能快速生成带注释的视频摘要,加速了实验结果的定性与同行评议过程。
数据集最近研究
最新研究方向
该数据集聚焦于机器人学习领域中的具身智能与多模态感知融合前沿,其核心创新在于将精细的手部关键点注释与第一人称视角视频流紧密结合,推动了视觉-动作联合建模的研究。通过遵循LeRobot v2.1规范,数据集支持细粒度的子任务标注,为复杂操作序列的分步学习提供了可靠基准。其设计巧妙之处在于关键点特征与相机命名空间的严格对应,以及采用NaN而非零值表示未检出手部的策略,凸显了对数据真实性与注释精度的极致追求。这一工作不仅为机器人模仿学习提供了高保真的训练语料,还促进了人机交互中手部动态理解、运动规划及跨视角泛化等热点方向的探索,对于构建能适应真实世界操作的智能体具有重要的引领意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务