
遇见数据集

open-llm-leaderboard-old/details_Yash21__Mistral-Quantum-dpo

收藏
Hugging Face2024-01-10 更新2024-06-22 收录
官方服务:

资源简介:

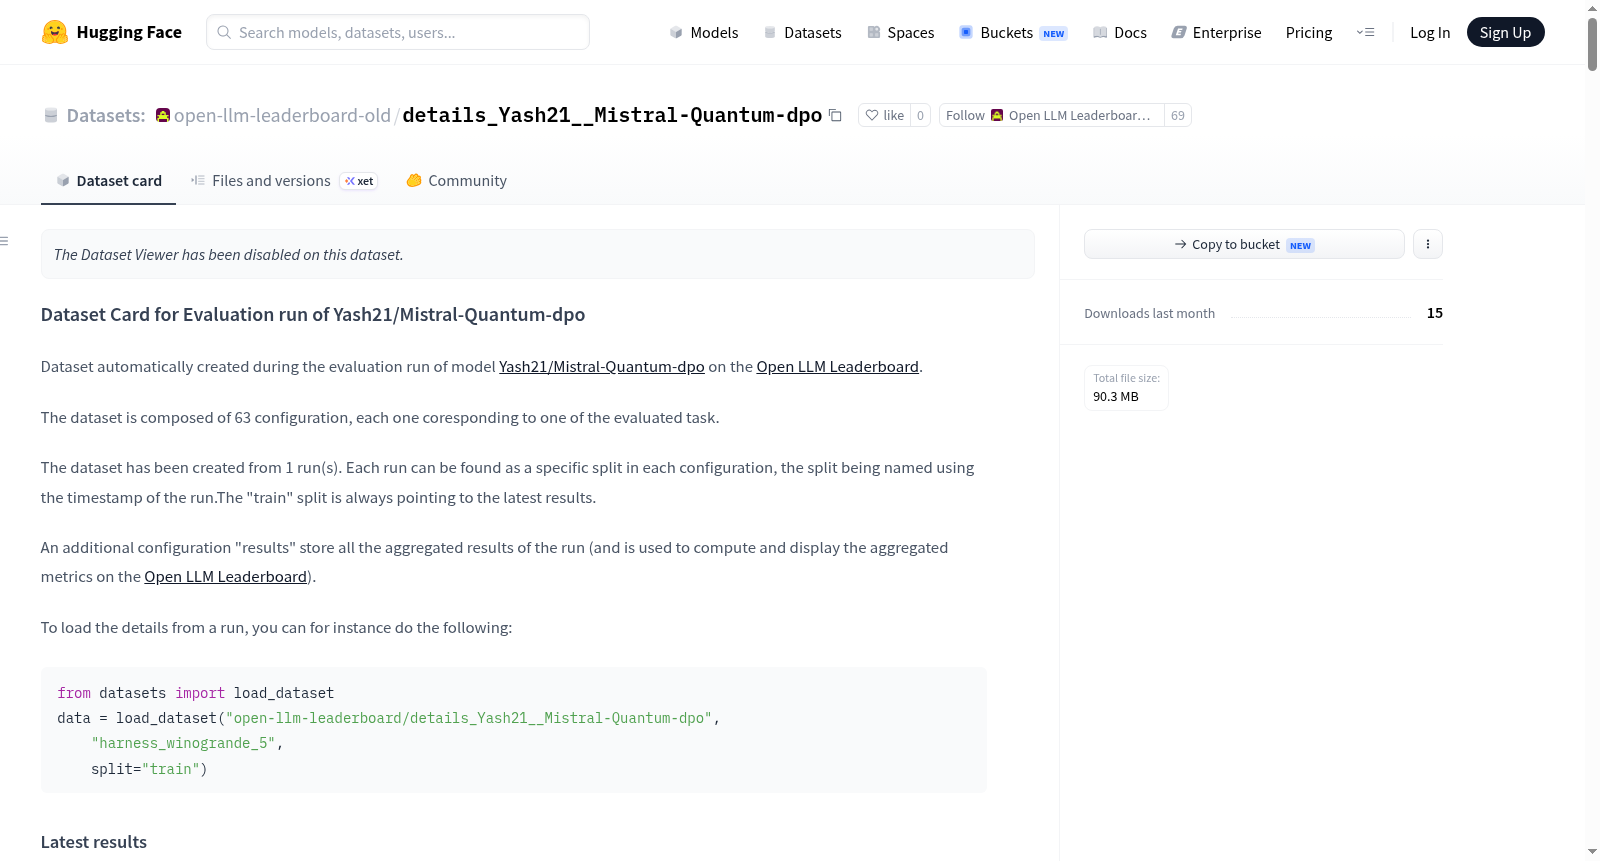
该数据集是在Open LLM Leaderboard上对模型Yash21/Mistral-Quantum-dpo进行评估时自动创建的。数据集由63个配置组成,每个配置对应一个评估任务。数据集是从1次运行中创建的,每次运行在每个配置中作为一个特定的分割,分割名称使用运行的时间戳。train分割始终指向最新的结果。此外,还有一个名为results的配置,存储了所有运行的聚合结果,用于计算和显示Open LLM Leaderboard上的聚合指标。文件还提供了如何使用`datasets`库中的`load_dataset`函数加载运行详情的示例。

该数据集是在Open LLM Leaderboard上对模型Yash21/Mistral-Quantum-dpo进行评估时自动创建的。数据集由63个配置组成,每个配置对应一个评估任务。数据集是从1次运行中创建的,每次运行在每个配置中作为一个特定的分割,分割名称使用运行的时间戳。train分割始终指向最新的结果。此外,还有一个名为results的配置,存储了所有运行的聚合结果,用于计算和显示Open LLM Leaderboard上的聚合指标。文件还提供了如何使用`datasets`库中的`load_dataset`函数加载运行详情的示例。

原始信息汇总

数据集概述

数据集组成

  • 该数据集包含63个配置,每个配置对应一个评估任务。
  • 数据集从1次运行中创建,每个运行可以在每个配置中找到特定的分割,分割名称使用运行的时间戳。
  • "train"分割始终指向最新的结果。
  • 一个额外的配置"results"存储所有运行的聚合结果,用于计算和显示在Open LLM Leaderboard上的聚合指标。

数据加载示例

python from datasets import load_dataset data = load_dataset("open-llm-leaderboard/details_Yash21__Mistral-Quantum-dpo", "harness_winogrande_5", split="train")

最新结果

  • 这些是最新结果,来自2024-01-10T18:44:13.240040的运行。
  • 结果包括多个任务的准确率(acc)、标准化准确率(acc_norm)、以及其他指标(如mc1, mc2等)及其标准误差。

配置详情

  • harness_arc_challenge_25

    • 分割:2024_01_10T18_44_13.240040, latest
    • 路径:**/details_harness|arc:challenge|25_2024-01-10T18-44-13.240040.parquet
  • harness_gsm8k_5

    • 分割:2024_01_10T18_44_13.240040, latest
    • 路径:**/details_harness|gsm8k|5_2024-01-10T18-44-13.240040.parquet
  • harness_hellaswag_10

    • 分割:2024_01_10T18_44_13.240040, latest
    • 路径:**/details_harness|hellaswag|10_2024-01-10T18-44-13.240040.parquet
  • harness_hendrycksTest_5

    • 分割:2024_01_10T18_44_13.240040, latest
    • 路径:多个路径,包括**/details_harness|hendrycksTest-abstract_algebra|5_2024-01-10T18-44-13.240040.parquet等。
搜集汇总
数据集介绍
open-llm-leaderboard-old/details_Yash21__Mistral-Quantum-dpo 数据集图片
构建方式
在大型语言模型评估领域,Open LLM Leaderboard作为权威的基准平台,其评估过程会系统性地生成结构化结果数据。本数据集正是针对Yash21/Mistral-Quantum-dpo模型在Open LLM Leaderboard上的评估运行而自动构建的产物。数据集由63个独立配置组成,每一个配置精确对应一项被评估的任务,涵盖ARC挑战赛、HellaSwag、GSM8K、Winogrande以及涵盖57个学科的Hendrycks测试集等多样化评测维度。数据源自单次评估运行,每次运行的结果以时间戳为标识形成独立的数据分割,其中“train”分割始终指向最新评估结果。此外,数据集还包含一个名为“results”的特殊配置,用于汇总存储所有任务的聚合指标,这些聚合数据正是Open LLM Leaderboard计算和展示模型综合性能分数的直接依据。
特点
该数据集展现出鲜明的结构化与动态追踪特性。其核心特点在于以任务为粒度进行精细配置,每个配置独立存储对应任务的详细评估结果,这种设计使得研究者能够聚焦于特定能力维度的深入分析。数据集的版本管理机制尤为突出,每次评估运行均生成带有精确时间戳的数据分割,而“train”分割的自动更新机制确保了用户始终能够访问最新的评估数据。这种设计不仅完整保留了模型性能的历史演化轨迹,也便于进行不同时间点结果的横向对比。聚合配置“results”的设立进一步提升了数据集的实用性,它将分散在各任务中的指标统一归纳,为用户提供了从宏观层面快速把握模型整体表现的便捷途径。
使用方法
利用Hugging Face Datasets库可高效加载此数据集。用户需首先调用`load_dataset`函数,指定数据集名称`open-llm-leaderboard/details_Yash21__Mistral-Quantum-dpo`,并通过参数选择所需的任务配置,例如`harness_winogrande_5`,再设定`split`参数为`train`以获取最新评估结果。若需回溯历史数据,可将`split`参数替换为对应运行的时间戳标识。加载后的数据集可直接用于复现模型在特定基准上的表现,或作为二次分析的输入。对于需要宏观性能视图的场景,加载“results”配置可一次性获取所有任务的聚合指标,极大便利了模型性能的综合评估与报告撰写。
背景与挑战
背景概述
在大规模语言模型(LLM)迅猛发展的浪潮中,如何系统性地评估模型在多样化任务上的综合能力,已成为学术界与工业界共同关注的核心议题。Open LLM Leaderboard由Hugging Face团队于2023年发起,旨在为开源社区提供一个标准化、透明化的模型评测平台,其核心研究问题在于如何通过多维度基准测试,客观反映模型在推理、知识理解与生成等维度的真实水平。该数据集作为Leaderboard的衍生产物,记录了Yash21/Mistral-Quantum-dpo模型在2024年1月10日的完整评测结果,涵盖ARC Challenge、HellaSwag、MMLU(涵盖57个学科)、TruthfulQA、Winogrande及GSM8K等共计63项任务配置。其影响力体现在为社区提供了可复现的细粒度评测数据,推动了模型性能对比与迭代优化的科学化进程。
当前挑战
该数据集所解决的领域问题在于弥补LLM评测中缺乏统一、细粒度基准的空白,尤其针对模型在常识推理(如ARC Challenge)、多学科知识(如MMLU)、数学逻辑(如GSM8K)及对抗性生成(如TruthfulQA)等维度上的表现差异,提供了量化评估手段。构建过程中面临的挑战包括:评测任务多样性导致的数据格式异构性,需将不同来源的基准(如HendrycksTest的57个学科)统一为可比较的Parquet格式;评测结果的时效性管理,需通过时间戳分割区分多次运行结果,并确保“latest”分割指向最新数据;以及模型在特定任务(如GSM8K得分为0)上的极端表现,揭示了当前模型在数学推理等复杂任务上的系统性短板,需进一步分析数据偏差与评估指标适配性。
常用场景
经典使用场景
该数据集专为评估大型语言模型在多样化自然语言理解与推理任务中的表现而设计,其经典使用场景集中于对模型进行标准化基准测试。通过整合ARC-Challenge、HellaSwag、Winogrande、GSM8K以及涵盖57个学科领域的MMLU(HendrycksTest)等任务,研究者可系统性地衡量模型在常识推理、数学求解、科学知识掌握及文本蕴含等方面的能力。数据集以Parquet格式存储每个任务的细粒度结果,便于加载与复现,从而支撑模型性能的横向对比与纵向追踪。
实际应用
在实际应用中,该数据集为模型选型与部署提供了关键决策依据。企业和研究机构可依据模型在该数据集各任务上的表现,选择最适合特定场景(如教育辅导、法律咨询、医疗问答)的基座模型。例如,在需要强数学推理的金融风控场景中,可优先参考GSM8K得分;而在需广泛常识的客服系统中,则关注HellaSwag与MMLU结果。此外,该数据集还能辅助监控模型迭代过程中的性能漂移,确保部署模型的稳定性。
衍生相关工作
该数据集衍生了一系列重要工作,包括基于其评估结果对模型进行针对性微调与知识蒸馏的策略研究。例如,研究者利用该数据集的细粒度错误分析,开发了面向低分任务(如GSM8K)的专项训练数据增强方法,显著提升了模型的数学推理能力。此外,该数据集还催生了多任务联合优化算法,通过在不同任务间共享表征,实现了模型在MMLU等综合知识测评上的性能突破。这些工作共同推动了从单一任务评估到系统性能力诊断的研究范式转型。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

